做数据项目久了,我越来越觉得,存储这件事最容易被讲复杂,也最容易被选错。
很多人第一次接触 DAS、NAS、SAN,会先去背定义:
DAS 是直接连接存储,NAS 是网络附加存储,SAN 是存储区域网络。
这些定义当然没错,但真正做选型的时候,你面对的不是考试题,而是一堆很现实的问题:
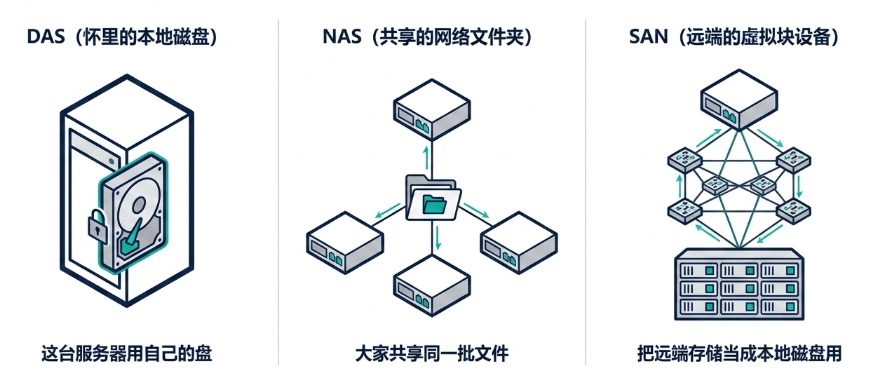
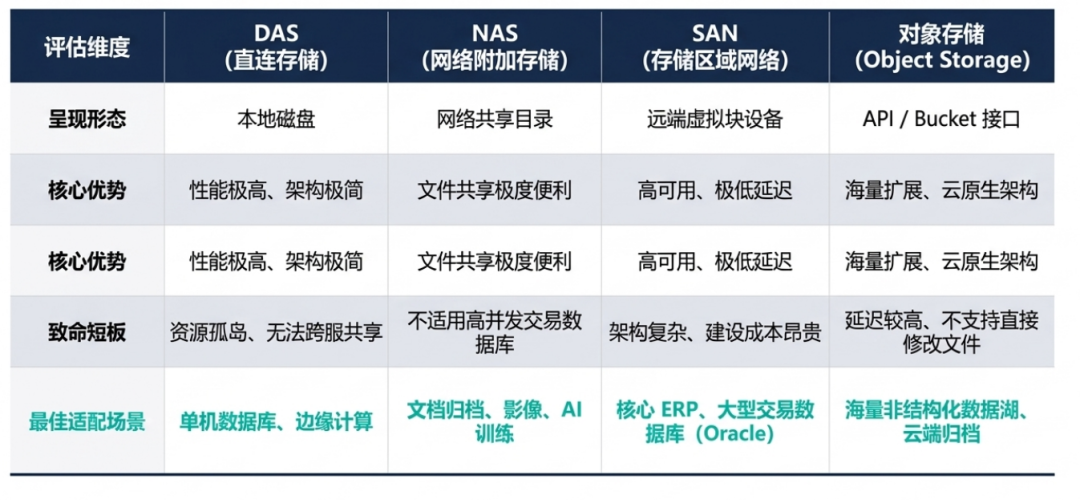
DAS 是“这台服务器用自己的盘”,NAS 是“大家共享同一批文件”,SAN 是“把远端存储当成本地磁盘用”。
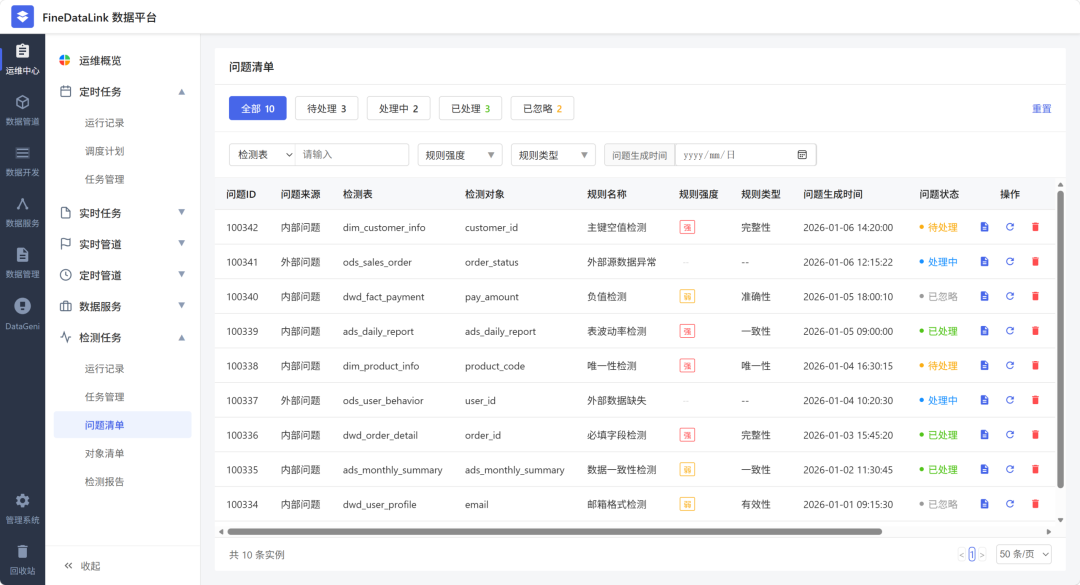
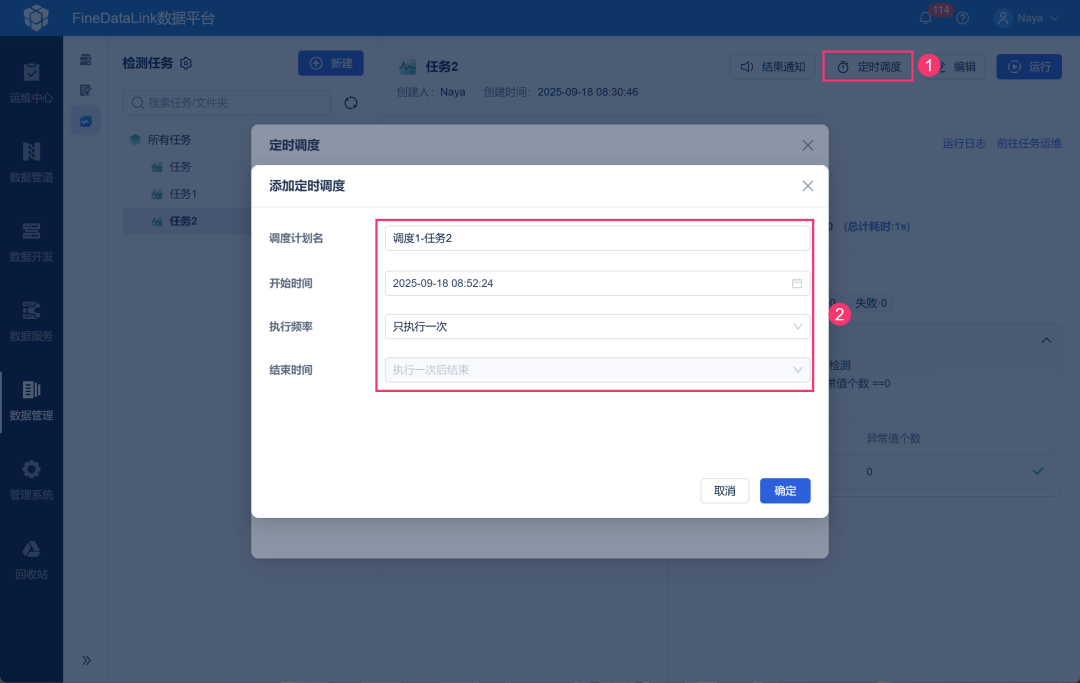
FineDataLink 5.0新增整合了库表管理、血缘分析、数据检测、全局清洗规则等能力:
从实际使用来看,这几个能力放在一起,比单独看某一个功能更有意义。
平时可以先把库表、表结构和具体数据统一管起来,遇到问题时再顺着血缘去看数据表、API、任务之间到底怎么关联;
如果发现空值、重复、格式异常,或者敏感数据处理不一致,也可以继续用数据检测和全局清洗规则去处理,把“看数据、查关系、找问题、做清洗”串成一套比较完整的数据管理流程。
需要数据集成工具FineDataLink 5.0的可以自取:https://s.fanruan.com/ns1l9
我以前给别人解释 DAS、NAS、SAN,最不喜欢从英文缩写开始讲。
-
DAS 的服务器看到的是直接连接在自己身上的磁盘。
-
-
这三个区别看起来不大,实际上已经决定了绝大多数架构差异。
-
如果数据库文件放在这台机器自己的 NVMe 或 SAS 磁盘上,这是 DAS。
-
如果服务器挂载一个 NFS 目录,把文件写到网络存储里,这是 NAS。
-
如果存储阵列给服务器划了一块 LUN,操作系统把它识别成磁盘设备,这是 SAN。
所以不要先问哪个更高级,要先问应用希望以什么方式访问数据。
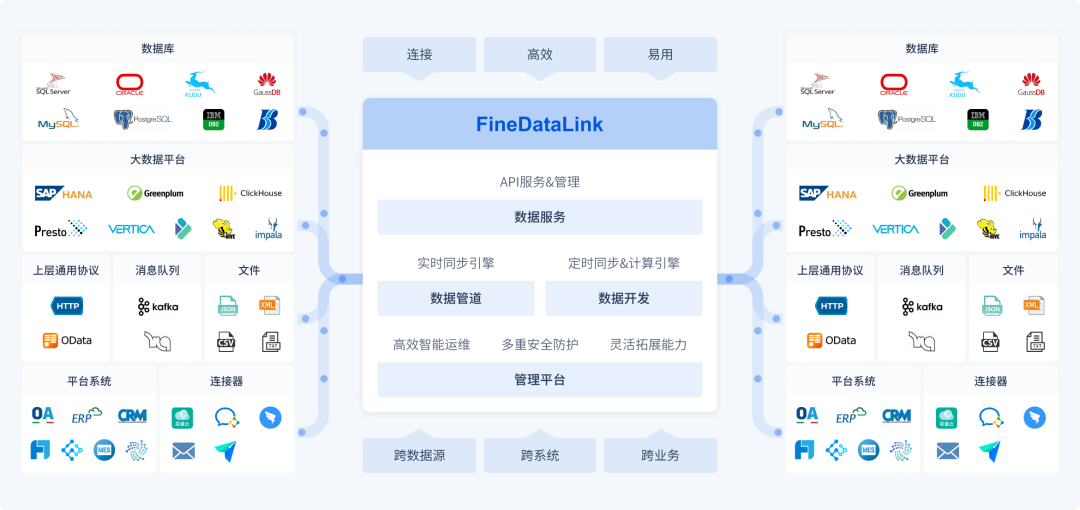
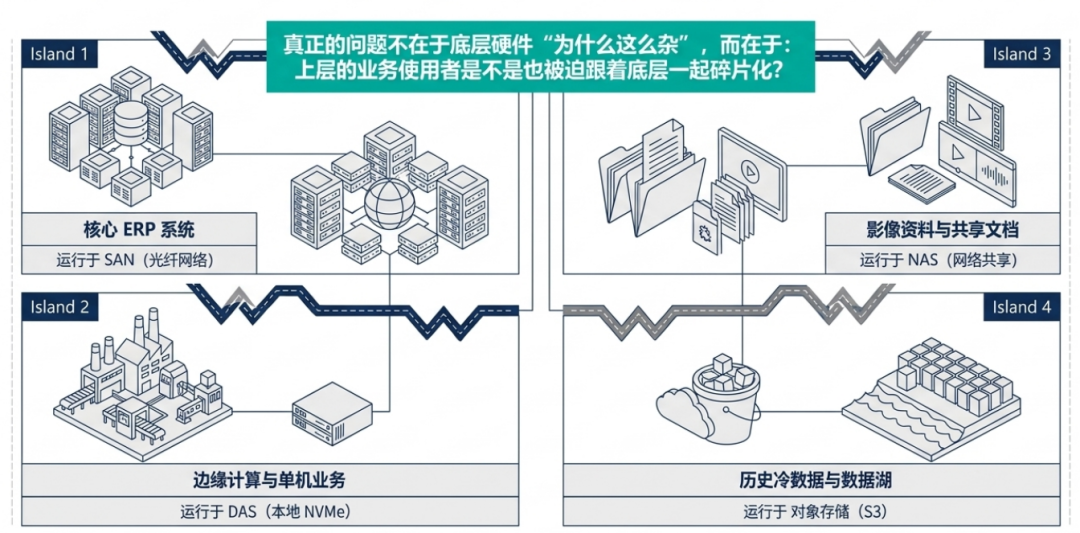
我们实际用 FineDataLink 5.0 做数据接入时,也不会要求企业先把所有底层存储统一掉。
很多客户本来就是业务数据库用一套、数仓用一套、归档又是另一套,真正重要的是先把这些异构环境里的数据接起来,让上层分析和数据使用不再被底层物理存储方式牵着走。
服务器内部装硬盘,或者通过 SAS、PCIe、NVMe 等方式直接连接磁盘,本质上都属于 Direct Attached Storage。
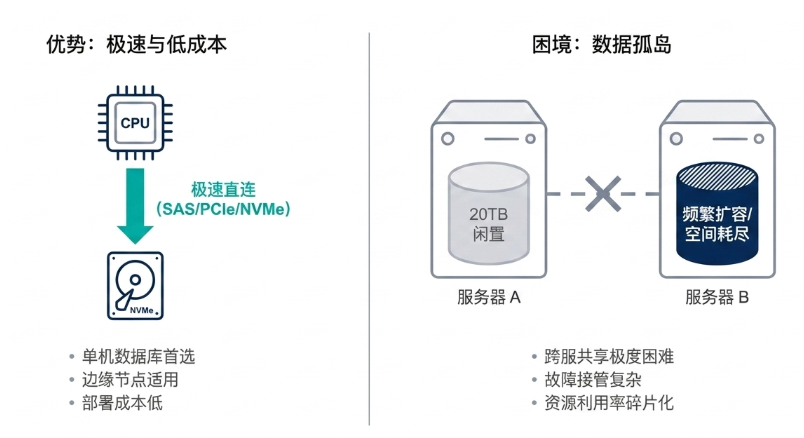
它最大的优点,就是直接。访问路径短,架构简单,部署成本也相对低。
所以一些单机数据库、小型业务系统、开发环境、边缘节点,用 DAS 完全没问题。
而且现在 NVMe SSD 性能非常高,所以千万别把 DAS 理解成低端方案。
如果两边都是本地 DAS,这20TB并不能天然分给服务器 B 用。
所以 DAS 很适合“自己用自己的盘”,但不擅长大规模资源共享。
这种环境里,我们实际更关心的往往不是“怎么把所有 DAS 统一”,而是怎么把分散在各台服务器里的业务数据持续抽出来。
可以借助 FineDataLink 5.0 把真正需要分析的数据持续同步到统一数仓或分析数据库,这样底层服务器可以分散,上层数据使用不必跟着一起分散。
DAS 可以分散,但企业的数据分析没必要跟着分散。
三、NAS:真正擅长的不是“当硬盘”,而是共享文件
服务器或者电脑通过网络访问 NAS,常见协议包括:
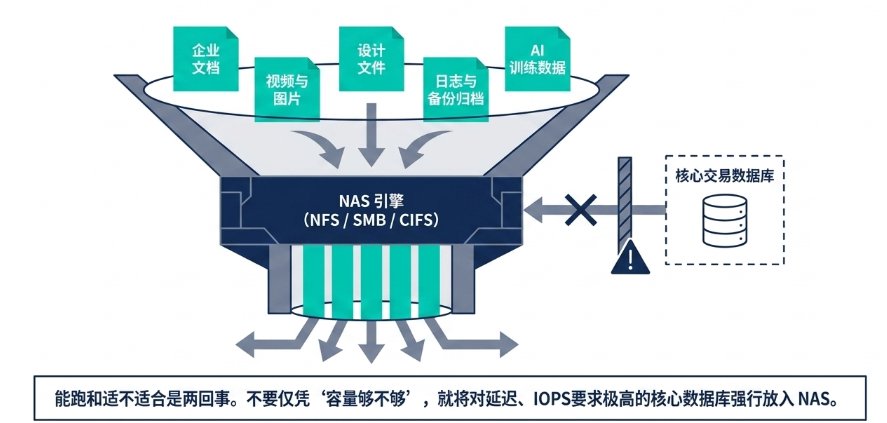
因为这些场景最核心的需求,不是给某一台服务器一块独占磁盘,而是很多人、很多服务器都需要访问同一批文件。
很多人觉得 NAS 也能存数据,那数据库是不是也随便往里面放?
尤其核心交易数据库,要看延迟、IOPS、网络稳定性以及数据库本身对存储访问方式的要求,不能只看“容量够不够”。
在文件类数据越来越多以后,我反而会更关注这些文件怎么继续进入后续数据体系。
不如先通过 FineDataLink 5.0 把真正需要使用的数据接入、整理,再进入后续数据库或数仓,让 NAS 继续负责它最擅长的文件共享,分析系统也不用长期绑在文件目录结构上。
因为 NAS 已经能通过网络访问存储了,那为什么还要 SAN?
虽然真正的磁盘可能在几十米外的存储阵列里,但操作系统看到的依然可以是一块块设备。
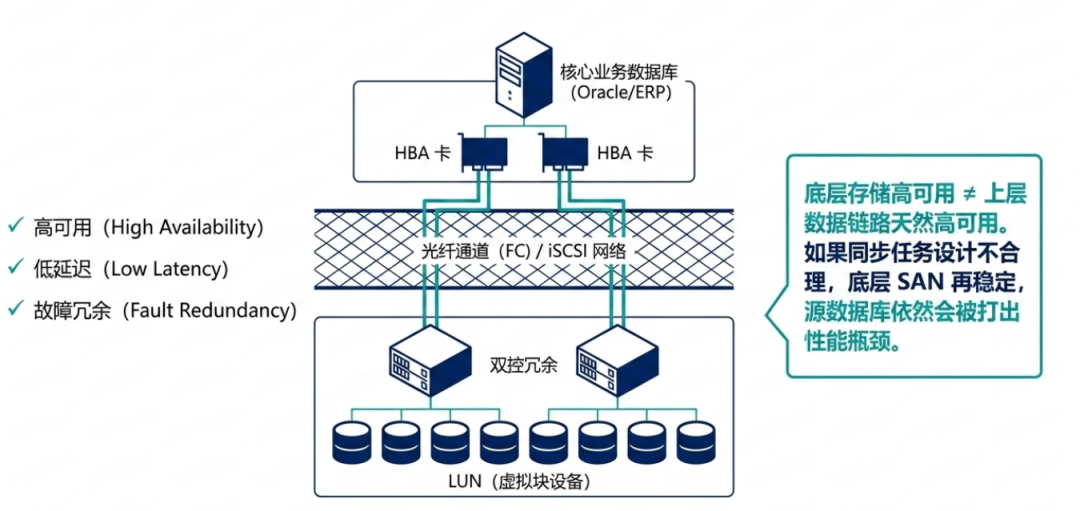
它通常会涉及存储阵列、双控制器、HBA 卡、交换机、多路径等一整套架构。
所以 Oracle、ERP、核心交易系统、虚拟化集群这类业务,经常会偏向 SAN。
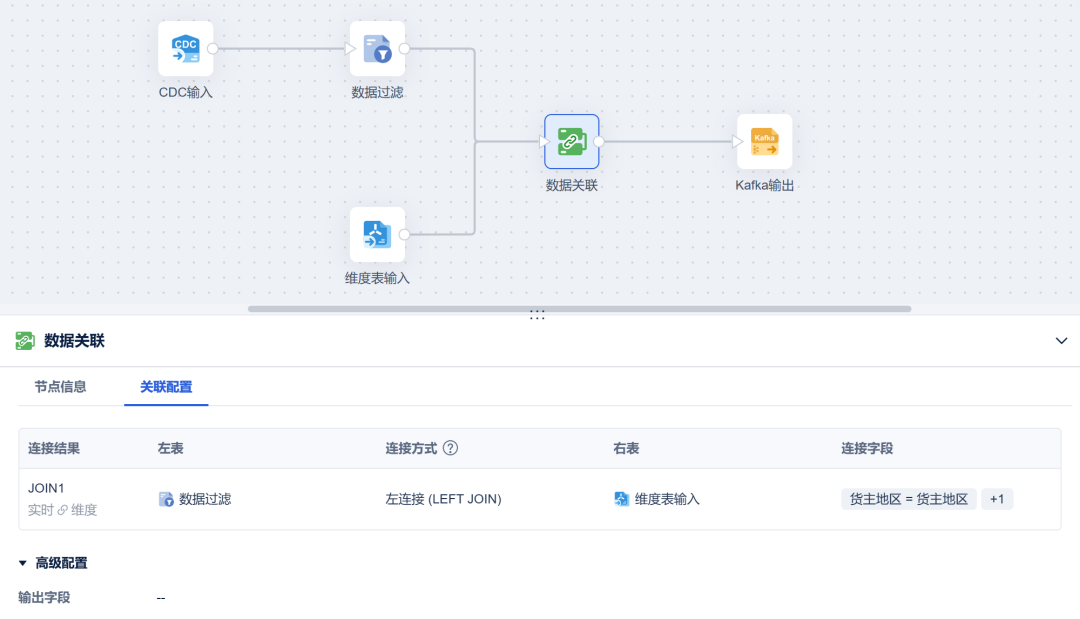
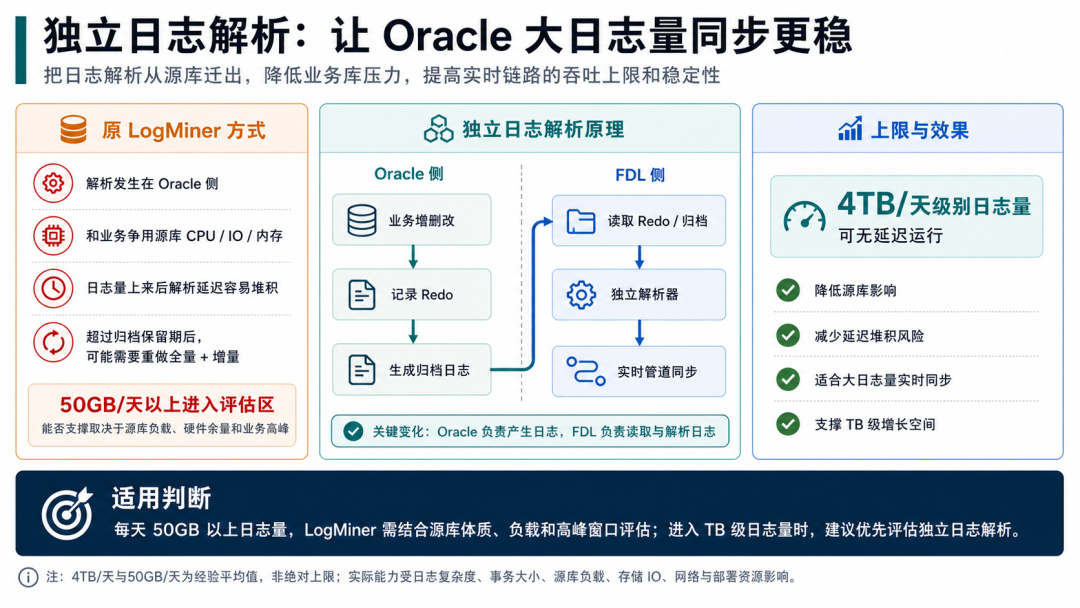
我们用 FineDataLink 5.0 对接这类核心数据库时,真正关心的通常是 CDC 链路、任务并发、写入节奏和源库压力,
因为如果同步任务设计不合理,即使底层 SAN 很稳定,源数据库一样可能被打出性能问题。
所以 SAN 解决的是底层存储可靠性,数据同步则要解决上层链路稳定性。
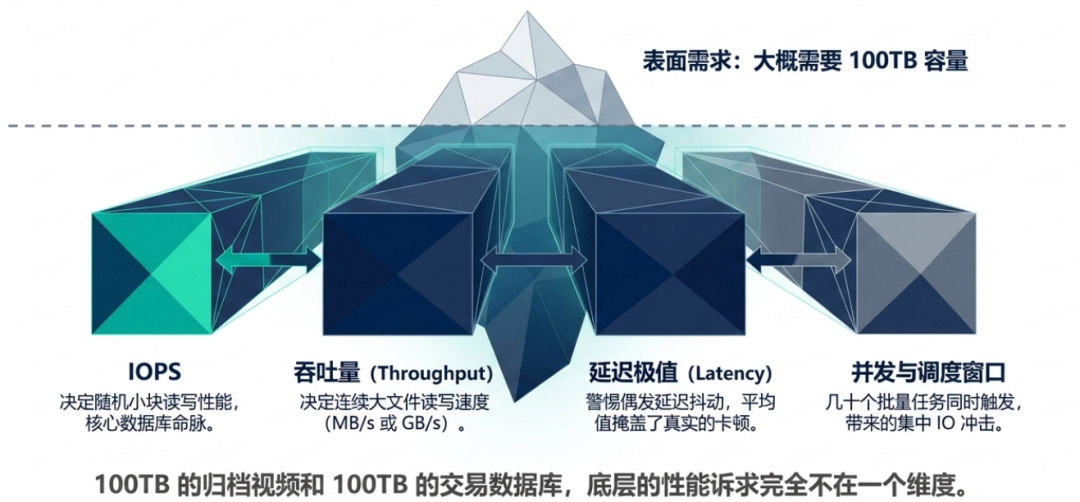
五、真正影响体验的,往往不是容量,而是 IOPS、吞吐和延迟
因为容量只决定数据装不装得下,性能决定业务能不能正常跑。
100TB 的归档视频和100TB 的交易数据库,完全不是一回事。
IOPS,代表每秒能完成多少次 IO 操作。
如果数据库大量随机小块读写,这个指标很关键。
吞吐量,一般看 MB/s 或 GB/s。
视频、大文件、备份这类连续读写,更看吞吐。
延迟,就是一次 IO 从发出到完成需要多久。
很多数据库业务最怕的其实不是平均性能差,而是延迟突然抖起来。
很多所谓存储性能问题,并不是硬件真的不够,而是几十个批量任务同时跑,把 IO 峰值集中堆在一个时间点。
使用 FineDataLink 5.0 时,这类场景更应该结合任务调度、增量同步和实时链路去安排数据流转节奏,尽量减少对源系统和目标存储的集中冲击。
六、DAS、NAS、SAN怎么选?先看业务,不要先看设备
-
如果是单台服务器自己使用,共享要求不高,又追求简单和本地性能,DAS 往往最直接。
-
如果核心是多人或者多服务器共享大量文件,NAS 更自然。
-
如果是大型数据库、虚拟化、ERP 这类核心系统,对块存储、可用、低延迟要求比较高,SAN 更合适。
真正合理的架构,很多时候并不是三选一,而是混合使用。
这一点和我们实际使用 FineDataLink 5.0 时的感受也很像:
企业底层既有不同数据库,又有不同存储形态,本身并不可怕,真正麻烦的是上层每换一次基础设施,所有数据任务都要重新适配。
所以更现实的思路往往是先把数据流转层稳定下来,再根据性能、成本和国产化改造需求逐步调整底层架构。
七、对象存储越来越多,DAS、NAS、SAN是不是要过时了
除了 DAS、NAS、SAN,现在还有对象存储,比如 S3 类架构。
对象存储特别适合海量非结构化数据、数据湖、备份归档、云原生应用。
所以一家稍微复杂点的企业,同时存在这些架构非常正常。
这也是我觉得 FineDataLink 5.0 在异构环境里更有价值的一点:
底层可以继续保留 Oracle、国产数据库以及不同存储形态,数据工程层先把这些来源接起来、同步起来、加工起来,上层分析和业务应用就不用天天关心底层到底换了什么设备。
这是很多介绍 DAS、NAS、SAN 的文章最容易漏掉的一块。
尤其数据库迁移时,更不能只考虑“历史数据怎么搬过去”。
比如 Oracle 准备迁到达梦、OceanBase 或 GaussDB。
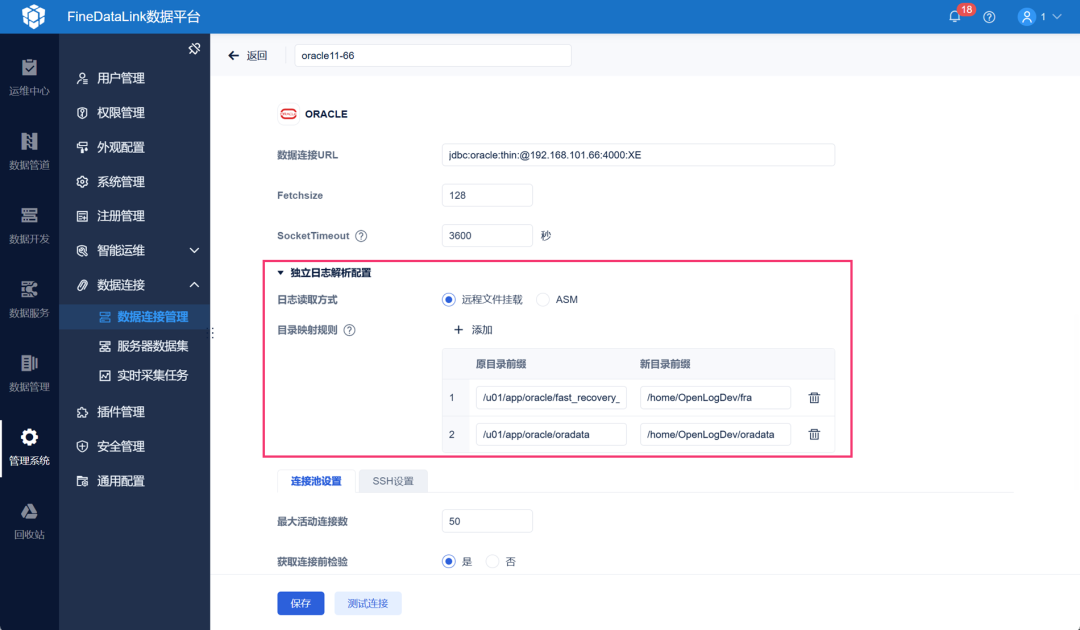
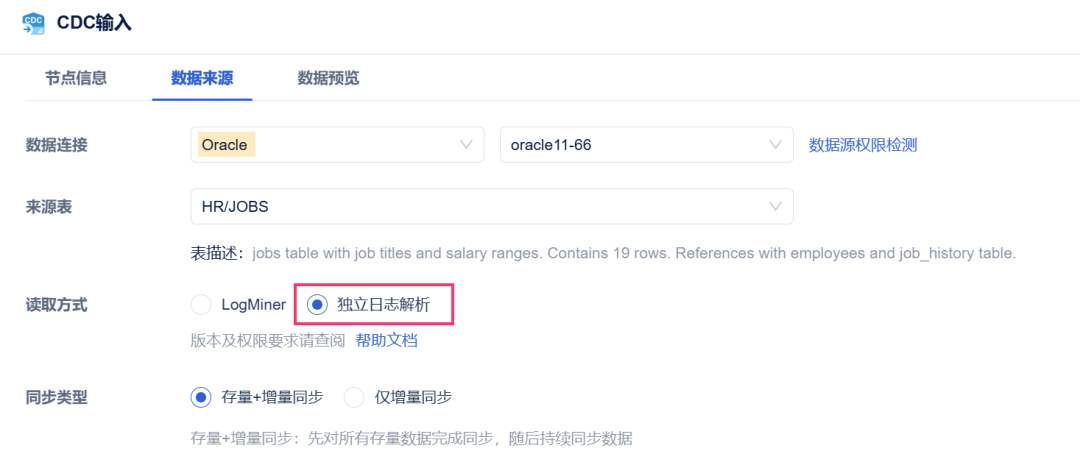
我们自己碰到这种项目,会更关注 FineDataLink 5.0 的 Oracle 独立日志解析能力以及对国产数据库实时同步的支持,
因为真实生产环境里,真正棘手的不是把几十 TB 历史数据一次性搬完,而是全量迁移完成以后,旧库还在不断产生新的交易数据;
只有把全量迁移和后续增量同步接起来,最后切换时才有可能把停机窗口压下来。
企业迁移的不是一批静态文件,而是一条正在运行的数据链。
数据放在哪里是一回事,数据能不能稳定地在系统之间流动,又是另一回事。
这也是为什么我会把存储架构和 FineDataLink 5.0 分开看。
后者更关注数据怎么接、怎么同步、怎么加工,以及底层数据库和基础设施发生变化以后,原来的数据链路还能不能继续跑。
真正成熟的数据架构,从来不是买了一套最贵的存储,而是存储、数据库、数据集成和上层应用各自解决自己最擅长的问题,最后还能稳定地串在一起。
|