这个系列从零开始写一个能跑的 LLM,配套课程《AI算法实战:手搓 Transformer 架构与反向传播训练》(NumPy + Torch 双版本实现)。
课程地址:https://edu.fanruan.com/video/837 | 授课讲师:帅杰
转载须知:非商业转载请注明作者及原文链接,商业转载请联系作者授权。
一、Embedding 之后,词向量还是「各过各的」
上一课我们给每个词向量加上了位置编码,模型终于知道谁在前、谁在后。但走到这里,先停一步问一个问题:每个词的向量,和别的词发生关系了吗?
没有。查 W_e 表是逐词独立的,加 PE 也是逐词独立的。「我」这个词的 8 个数字,从头到尾只由它自己的 id 和位置决定,句子里出现的是「爱」还是「恨」,对它毫无影响。
可语言不是这么工作的。看这两个句子:
「我爱AI」——「爱」是动词,主语是「我」。
「AI爱我」——「爱」还是那个「爱」,但主语宾语全换了。
同一个「爱」,在两个句子里扮演的语法角色完全不同。如果「爱」的向量永远不变,模型怎么区分它是在「爱别人」还是「被爱」?人读句子时会自动把上下文揉进对每个词的理解里——看到「爱」,眼睛会同时瞟向前面的「我」和后面的「AI」。
Self-Attention(自注意力)就是让模型拥有这双「会瞟的眼睛」的机制:让序列里的每个词,都去和句子里所有词(包括自己)打个照面,按相关程度把别人的信息加权汇总到自己身上。走完这一层,「爱」的向量就不再是孤立的「爱」,而是「我-爱-AI」这个语境里的「爱」。
顺便对比一下老牌做法。RNN 那一代模型读句子像排长队传话:「我」先过,更新一次内部状态,再把状态传给「爱」,「爱」再传给「AI」——每个词只能间接吃到前面的残羹,距离越远信息越淡,而且必须按顺序算,没法并行。Self-Attention 完全不同:一句话里所有词两两之间直接连线,任意两个词的距离都是「一步」,「爱」和「我」、「爱」和「AI」的关系强度一样清晰;更妙的是,5×5 个分数可以一次性全部算出,天然适合 GPU 并行。这也是 Transformer 能用 GPU 堆出大模型的底层原因。
二、QKV 由来:一次「带着问题查资料」
Self-Attention 最经典的比喻是图书馆检索。你心里带着一个问题走进书库:
问题(Query):你想找什么?比如「我想知道谁在爱」。
书签(Key):每本书书脊上的标签,标明这本书讲什么。
内容(Value):书里真正的信息,匹配上了才翻开读。
你拿自己的问题 Q,去和每本书的书签 K 逐一比对——问题和书签越契合,相关度越高;最后按相关度,把各本书的内容 V 取加权平均,得到你真正带走的答案。
|
角色
|
比喻
|
在向量里的含义
|
|
Q(Query)
|
你心里的问题
|
当前这个词,想获取什么信息
|
|
K(Key)
|
每本书的书签
|
每个词,能提供什么信息
|
|
V(Value)
|
书里的内容
|
每个词,实际被取走的信息
|
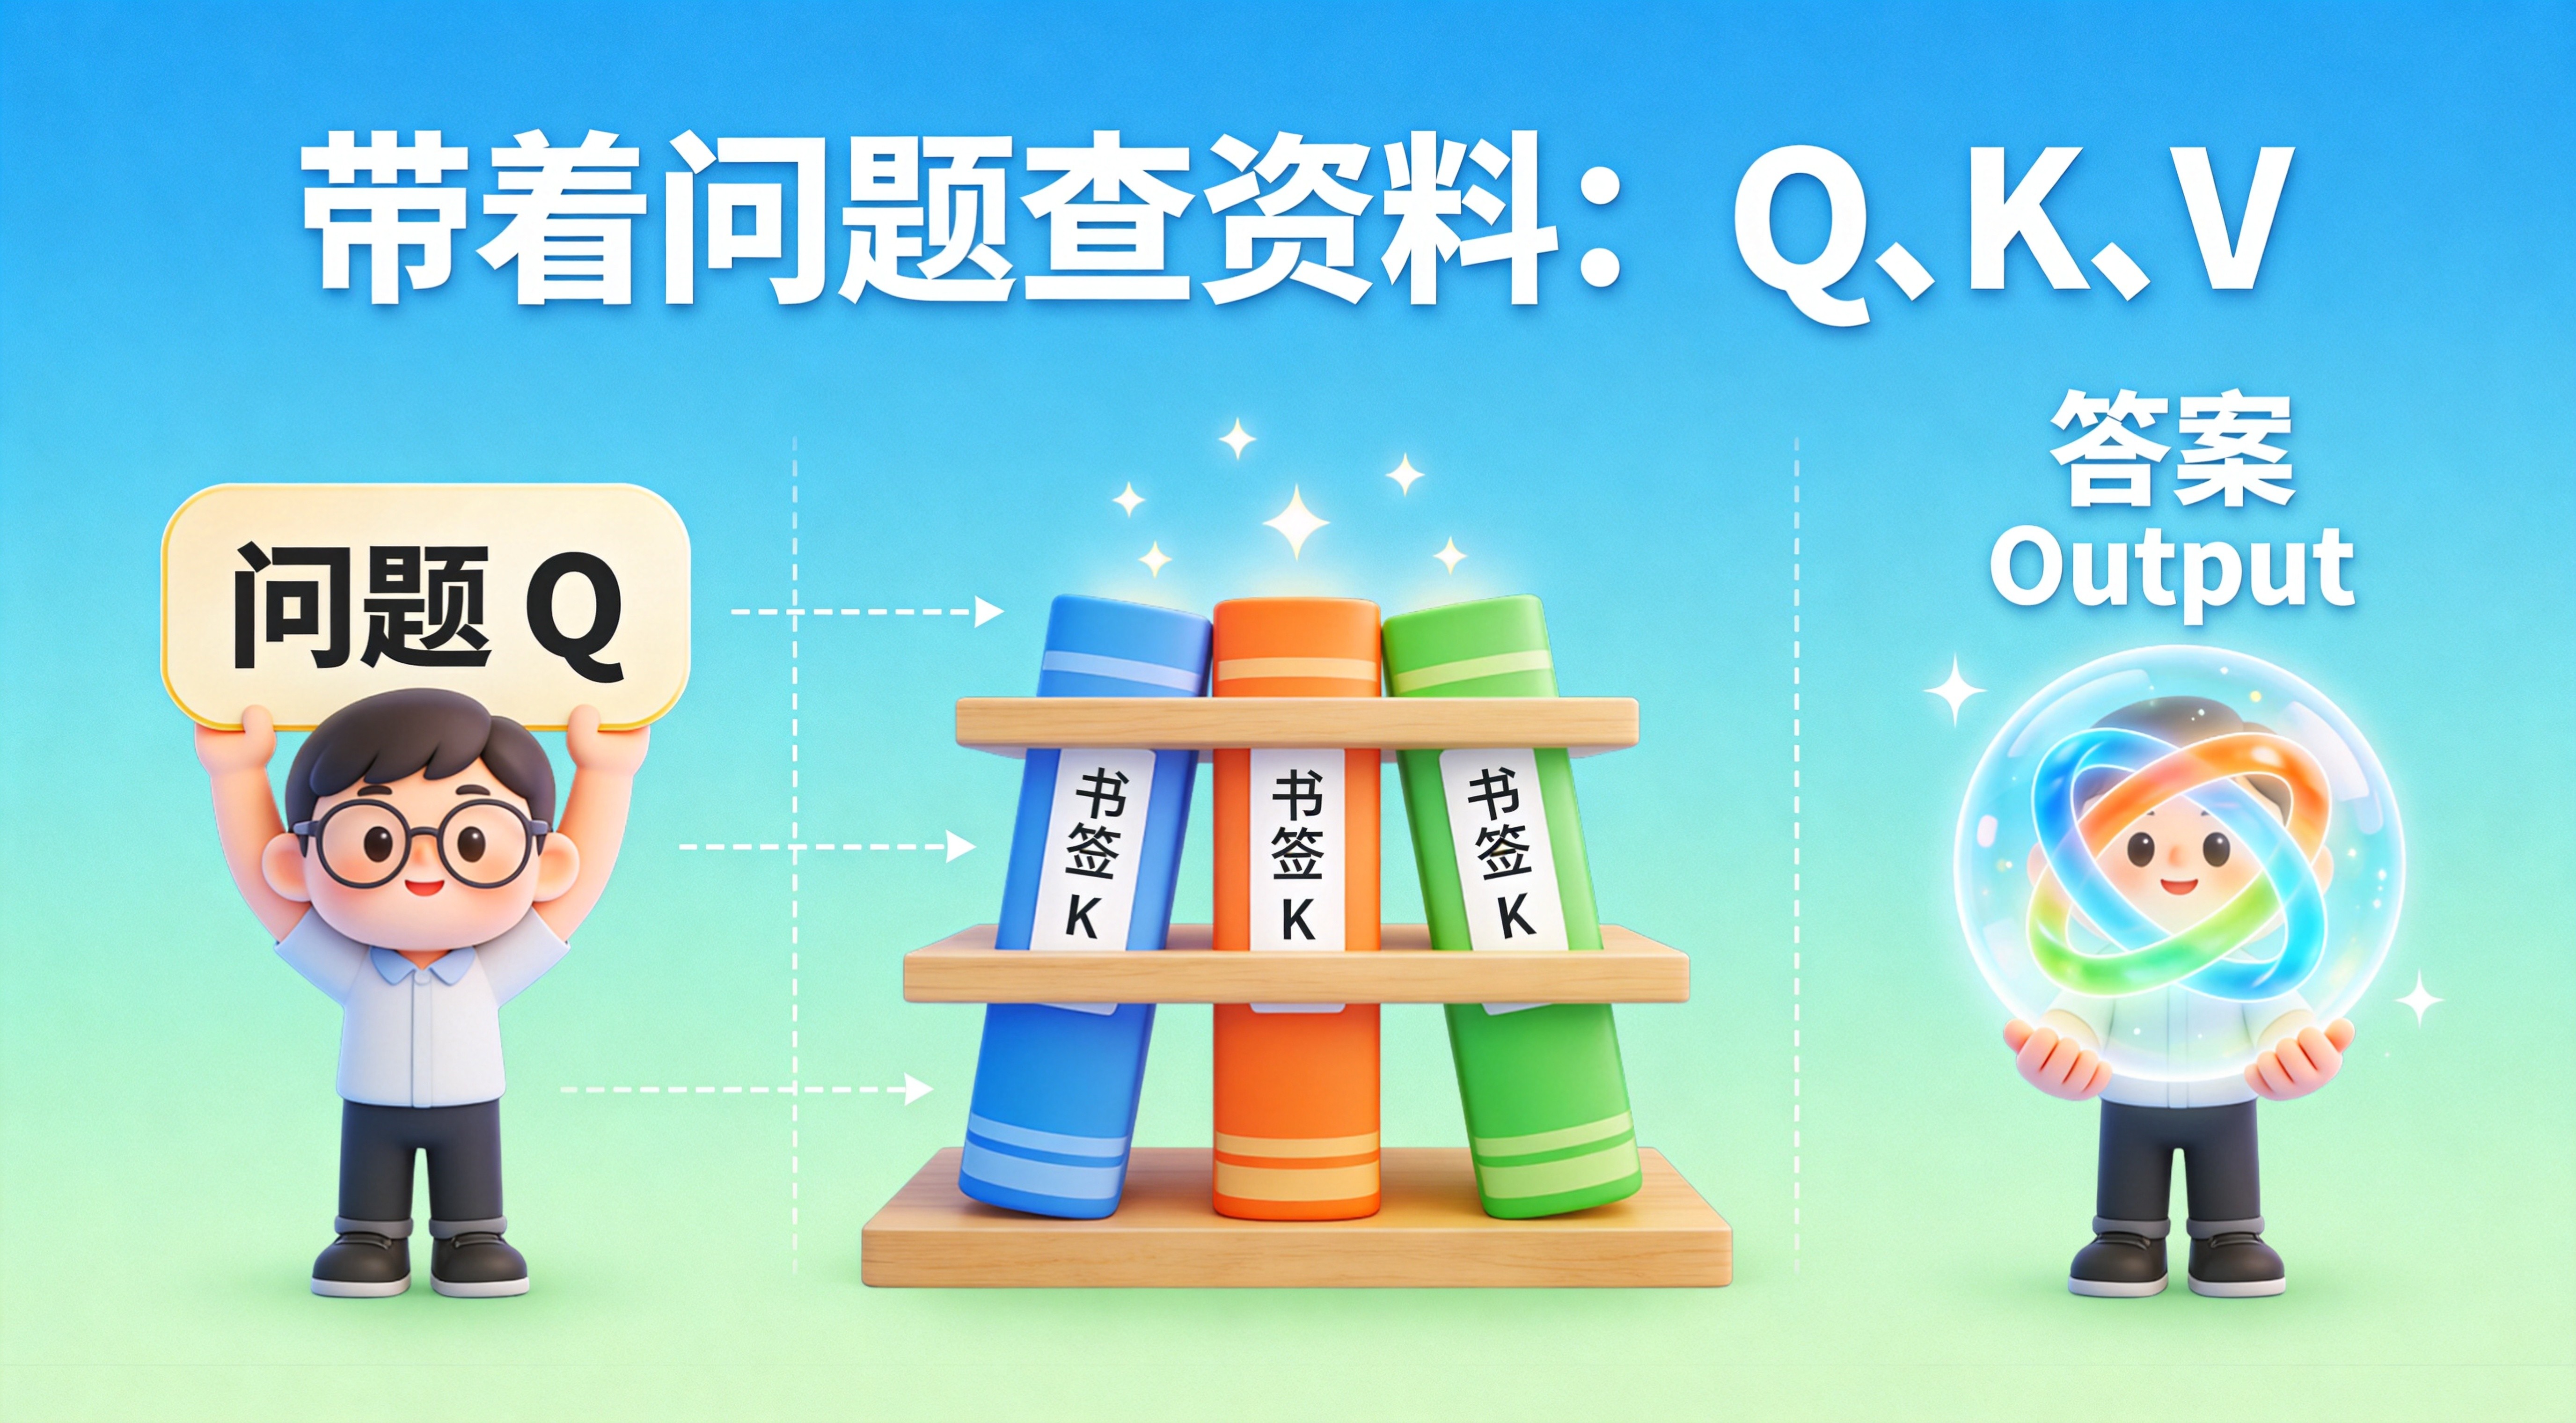
QKV 检索比喻:每个词同时拿出「问题 Q」和「书签 K」,问题与书签逐一比对,相关度高的词,其「内容 V」被更多地取走。
关键问题来了:词向量 X 本身只有一份,Q、K、V 从哪来?答案是三次独立的矩阵乘法——用三个不同的可学习矩阵 W_q、W_k、W_v,把同一个 X 投影到三个不同的空间:
Q = X @ W_q # 每个词换成「提问」的身份
K = X @ W_k # 每个词摆出「被检索」的书签
V = X @ W_v # 每个词备好「被取走」的内容
为什么非要投影成三份,不用 X 直接互相算?因为一个词「想问的」和「能答的」往往不是一回事。「爱」想问「谁是主语」,但它自己能提供的是「动作、情感」这类信息——硬用同一套向量兼任两个角色,表达能力会被捆住。三个投影矩阵各管一个视角,这是模型自己学出来的分工。
三、手算 QKV:还是那句「我爱 AI」
沿用上一课的案例:句子「我爱 AI」补 0 到长度 5,维度 D=8。输入 X 是 5×8 的矩阵(词嵌入加完位置编码后的结果,数值取自课程配套 Excel 的 self-attention 表):
|
位置
|
token
|
来源
|
|
0
|
我
|
真实词
|
|
1
|
爱
|
真实词
|
|
2
|
AI
|
真实词
|
|
3
|
<PAD>
|
补齐位
|
|
4
|
<PAD>
|
补齐位
|
三个投影矩阵 W_q、W_k、W_v 都是 8×8(课程演示中用固定值,真实训练时随机初始化再学出来)。X 分别乘上去,得到三个 5×8 的矩阵。以「我」(位置 0)这一行为例,保留两位小数:
|
向量
|
dim0
|
dim1
|
dim2
|
dim3
|
…
|
|
X[0](输入)
|
1.46
|
0.69
|
0.94
|
1.21
|
…
|
|
Q[0]=我提问
|
0.81
|
-1.14
|
-0.37
|
0.11
|
…
|
|
K[0]=我的书签
|
0.18
|
-0.68
|
-0.07
|
-0.64
|
…
|
|
V[0]=我的内容
|
0.48
|
0.34
|
0.18
|
0.16
|
…
|
注意 Q、K、V 是三副完全不同的面孔:同一个「我」,提问时 dim1 是 -1.14,当书签时 dim1 是 -0.68,提供内容时 dim1 是 0.34。一次投影,三种身份。
矩阵形状是这一步最容易绕晕的地方,单独钉死:
|
矩阵
|
形状
|
口诀
|
|
X
|
5 × 8
|
5 个词,每个 8 维
|
|
W_q / W_k / W_v
|
8 × 8
|
输入 8 维,投影后还是 8 维
|
|
Q / K / V
|
5 × 8
|
行数=词数,列数=维度
|
四、打分:Q·Kᵀ,两个向量有多「对路」
有了 Q 和 K,就可以回答「词 A 该多关注词 B」了。做法是让 Q 的每一行,去和 K 的每一行做点积:
scores = Q @ K.T # 5×8 乘 8×5,得到 5×5
5×5 正好是一张「两两对照表」:第 i 行第 j 列的数,表示位置 i 的词对位置 j 的词的关注打分。
| |
对 我(j=0)
|
对 爱(j=1)
|
对 AI(j=2)
|
对 PAD
|
对 PAD
|
|
我(i=0)
|
0.90
|
1.09
|
0.67
|
-0.89
|
-0.89
|
|
爱(i=1)
|
0.91
|
1.24
|
0.74
|
-0.67
|
-0.67
|
|
AI(i=2)
|
0.24
|
0.27
|
-0.10
|
-0.56
|
-0.56
|
为什么点积能衡量「对路程度」?几何上,点积等于「两个向量的长度 × 夹角余弦」。两个向量方向越一致,点积越大且为正;方向相反,点积为负;互相垂直,点积为 0。通俗说:Q 里写着「我要找主语」,K 里写着「我是名词、指人」,两者方向对得上,分数就高。
五、为什么要除以 √d:不除,Softmax 会「赌徒下注」
Transformer 论文里,打分后还要除以 √d(d 是 K 的维度,这里 d=8,√8≈2.83):
scores = Q @ K.T / np.sqrt(d) # 缩放
为什么?看一个统计事实:点积是 d 个乘积项相加。如果 Q、K 每个分量都是均值为 0、方差为 1 的随机数,那么每个乘积项方差约为 1,d 项加起来,点积的方差就是 d,标准差是 √d。维度越高,点积的绝对值天然越大——这跟语义没关系,纯粹是「加的项多了」。
数值大会带来什么后果?Softmax 对大数极其敏感。我们做个模拟(随机初始化 Q、K,一句 5 个词,重复 2000 次取平均,看 Softmax 后最大权重有多大):
|
维度 d
|
点积标准差(理论 √d)
|
不除 √d:最大权重平均
|
除以 √d:最大权重平均
|
|
8
|
2.83
|
0.70
|
0.44
|
|
64
|
8.00
|
0.89
|
0.46
|
|
256
|
16.00
|
0.95
|
0.46
|
d=256 时(真实大模型的常见维度),不做缩放,Softmax 平均把 95% 的权重压到一个词上——注意力退化成「只看一个词」的赌徒下注,梯度也会变得极小,模型几乎学不动。除以 √d 把分数拉回温和区间,权重分布恢复从容。
看本文案例「我」这一行,缩放前后对比(补齐位列先忽略,下一节处理):
| |
对 我
|
对 爱
|
对 AI
|
|
原始打分
|
0.90
|
1.09
|
0.67
|
|
÷√8 后
|
0.32
|
0.38
|
0.24
|
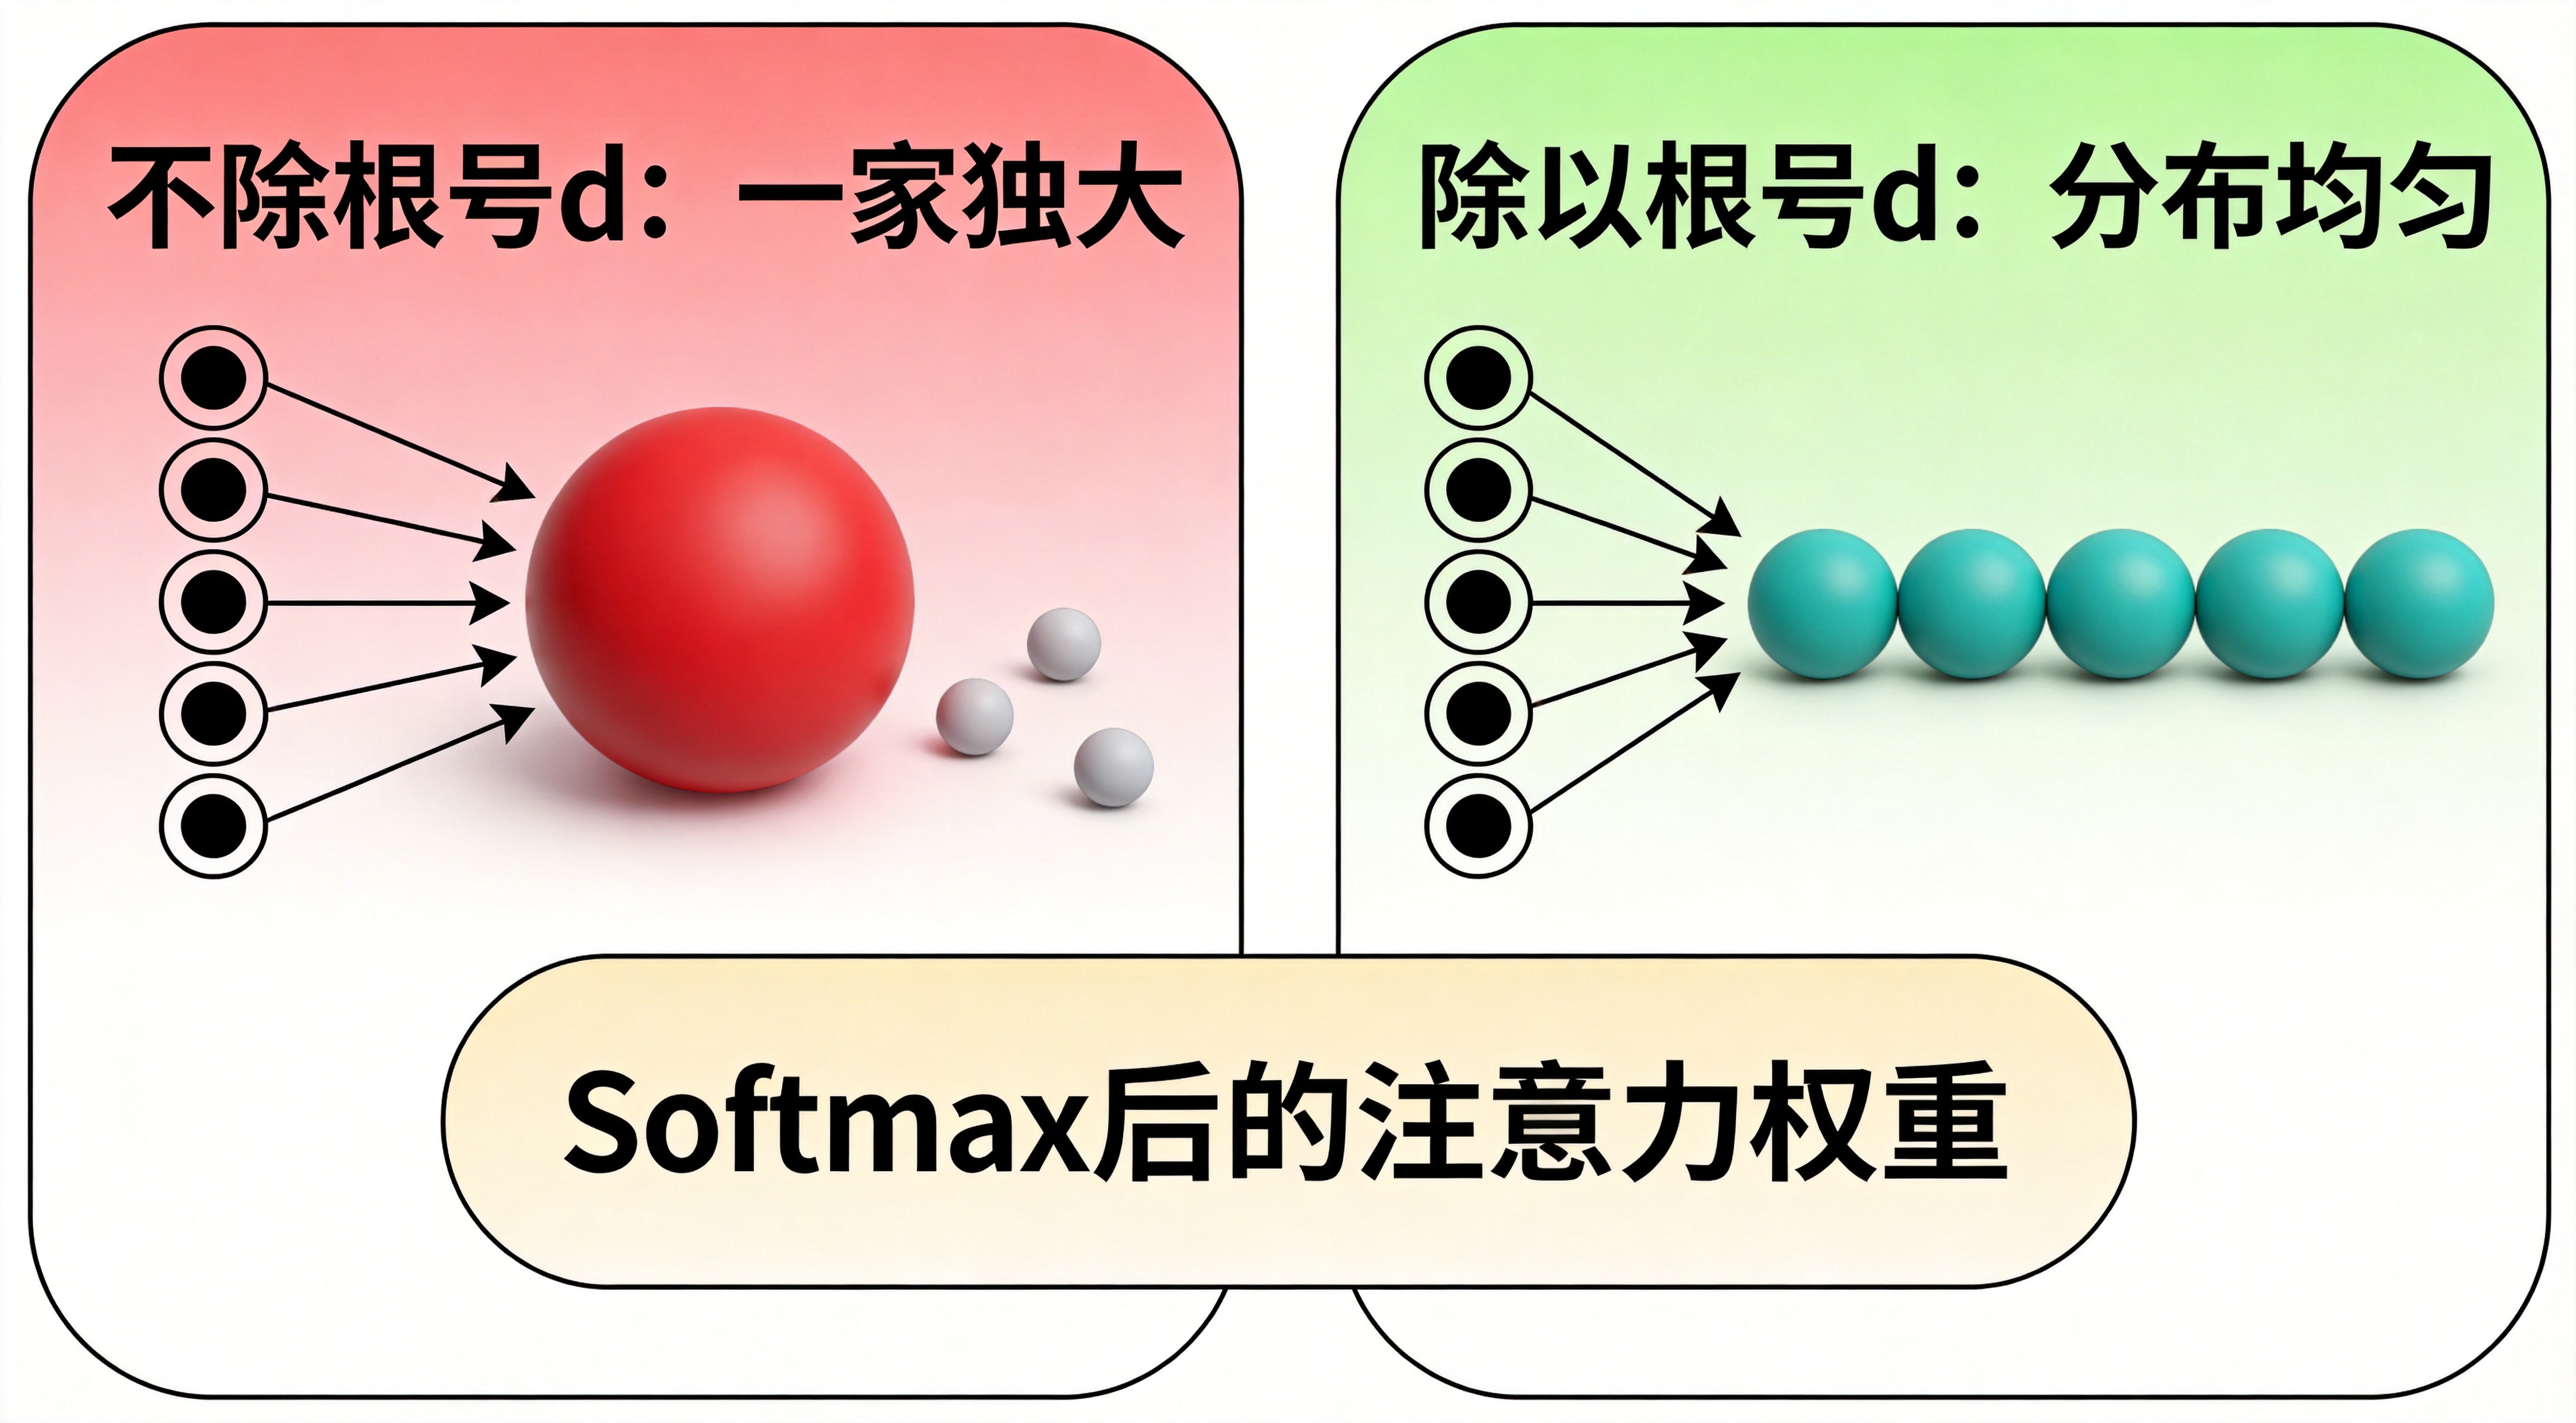
除以 √d 的作用:维度越高,点积分数天然越大,Softmax 会把权重几乎全压给一个词;缩放把分数拉回温和区间,注意力分布重新变得均匀可学。
六、Mask:让补齐位「闭嘴」
打分矩阵里有个麻烦:位置 3、4 是补 0 的 <PAD>,它们没有任何语义,却也拿着 K、V 参与了打分。看「我」这一行,对两个 PAD 的分数是 -0.89——负数,看似无害,但 Softmax 之后它们仍会分走一小份权重,凭空往「我」的向量里掺噪声。
处理办法简单粗暴:在 Softmax 之前,把所有指向 PAD 的分数(mask 列)改成一个极大的负数 -1e9:
scores[:, pad_positions] = -1e9 # 词对 PAD 的分数打到负无穷
为什么是 -1e9?Softmax 要算 e 的分数次方。e^(-1000000000) 在计算机里直接下溢成 0,PAD 的权重就干干净净变成 0,连小数点后十位的噪声都不留。
有两个细节值得说透:
第一,mask 的是列不是行。分数矩阵第 j 列代表「大家对位置 j 的关注」,PAD 没有内容可被取走,所以封掉它的列。至于 PAD 自己当查询(第 3、4 行)算出什么,无所谓——后面本来就没人会去读 PAD 位置的输出。这也和第 2 课的 Padding Mask 完全呼应:attention_mask 里 0 的位置,就是这里要封掉的列。
第二,Encoder 里 mask 只封 PAD;到 Decoder 还会多出一张「下三角」因果掩码,防止偷看未来的词——那是第 14 课的内容。
七、Softmax:把分数变成「和为 1」的权重
分数现在还是任意实数(有正有负),没法直接当「配比」。Softmax 做两件事:先 e^x 把所有分数变成正数,再除以总和归一化,让每行权重加起来正好等于 1:
weights = exp(scores) / exp(scores).sum(axis=1, keepdims=True)
实际计算时会先减去本行最大值再取指数(exp(scores - max)),数值上完全等价,但能防止 e 的大数次方溢出。
还是看「我」这一行,缩放并 mask 之后,三个真实词的权重是:
|
关注对象
|
我(自己)
|
爱
|
AI
|
PAD×2
|
|
缩放后分数
|
0.32
|
0.38
|
0.24
|
-1e9
|
|
Softmax 权重
|
0.334
|
0.357
|
0.309
|
0
|
读出来就是:「我」在更新自己时,35.7% 看「爱」,33.4% 看自己,30.9% 看「AI」,PAD 一分不给。权重非负、和为 1、还保留了分数的相对高低——这正是「注意力分配比例」该有的样子。
八、加权求和:把别人的 V「融」进自己
最后一步:用刚才得到的权重,对所有词的 V 做加权平均。权重矩阵是 5×5,V 是 5×8,相乘得到 5×8 的输出:
output = weights @ V # 5×5 乘 5×8,得到 5×8
对「我」这个词,它的新向量 = 0.334×V(我) + 0.357×V(爱) + 0.309×V(AI) + 0×V(PAD)。三个真实词的内容按配比融在一起,「我」的向量里从此有了「爱」和「AI」的影子。
|
输出行
|
dim0
|
dim1
|
dim2
|
dim3
|
…
|
|
output[0](我)
|
0.44
|
0.23
|
0.09
|
0.16
|
…
|
|
output[1](爱)
|
0.44
|
0.23
|
0.09
|
0.16
|
…
|
|
output[2](AI)
|
0.44
|
0.23
|
0.09
|
0.16
|
…
|
一个值得注意的现象:三行输出数值非常接近。因为这是个只有 3 个词的短句,每个词都能看到全部上下文,融完之后大家的向量自然趋同——这正是 Self-Attention「全局视野」的体现。长句子里,不同位置的权重差异才会拉开。
还有一个容易忽略但极其关键的事实:输出矩阵的形状和输入一模一样,还是 5×8。进来 5 个 8 维向量,出去还是 5 个 8 维向量——变的是每个向量「里面装的内容」,不是它的形状。这也是 Self-Attention 能一层一层堆叠的原因:上一层的输出,原样接得住下一层的输入。
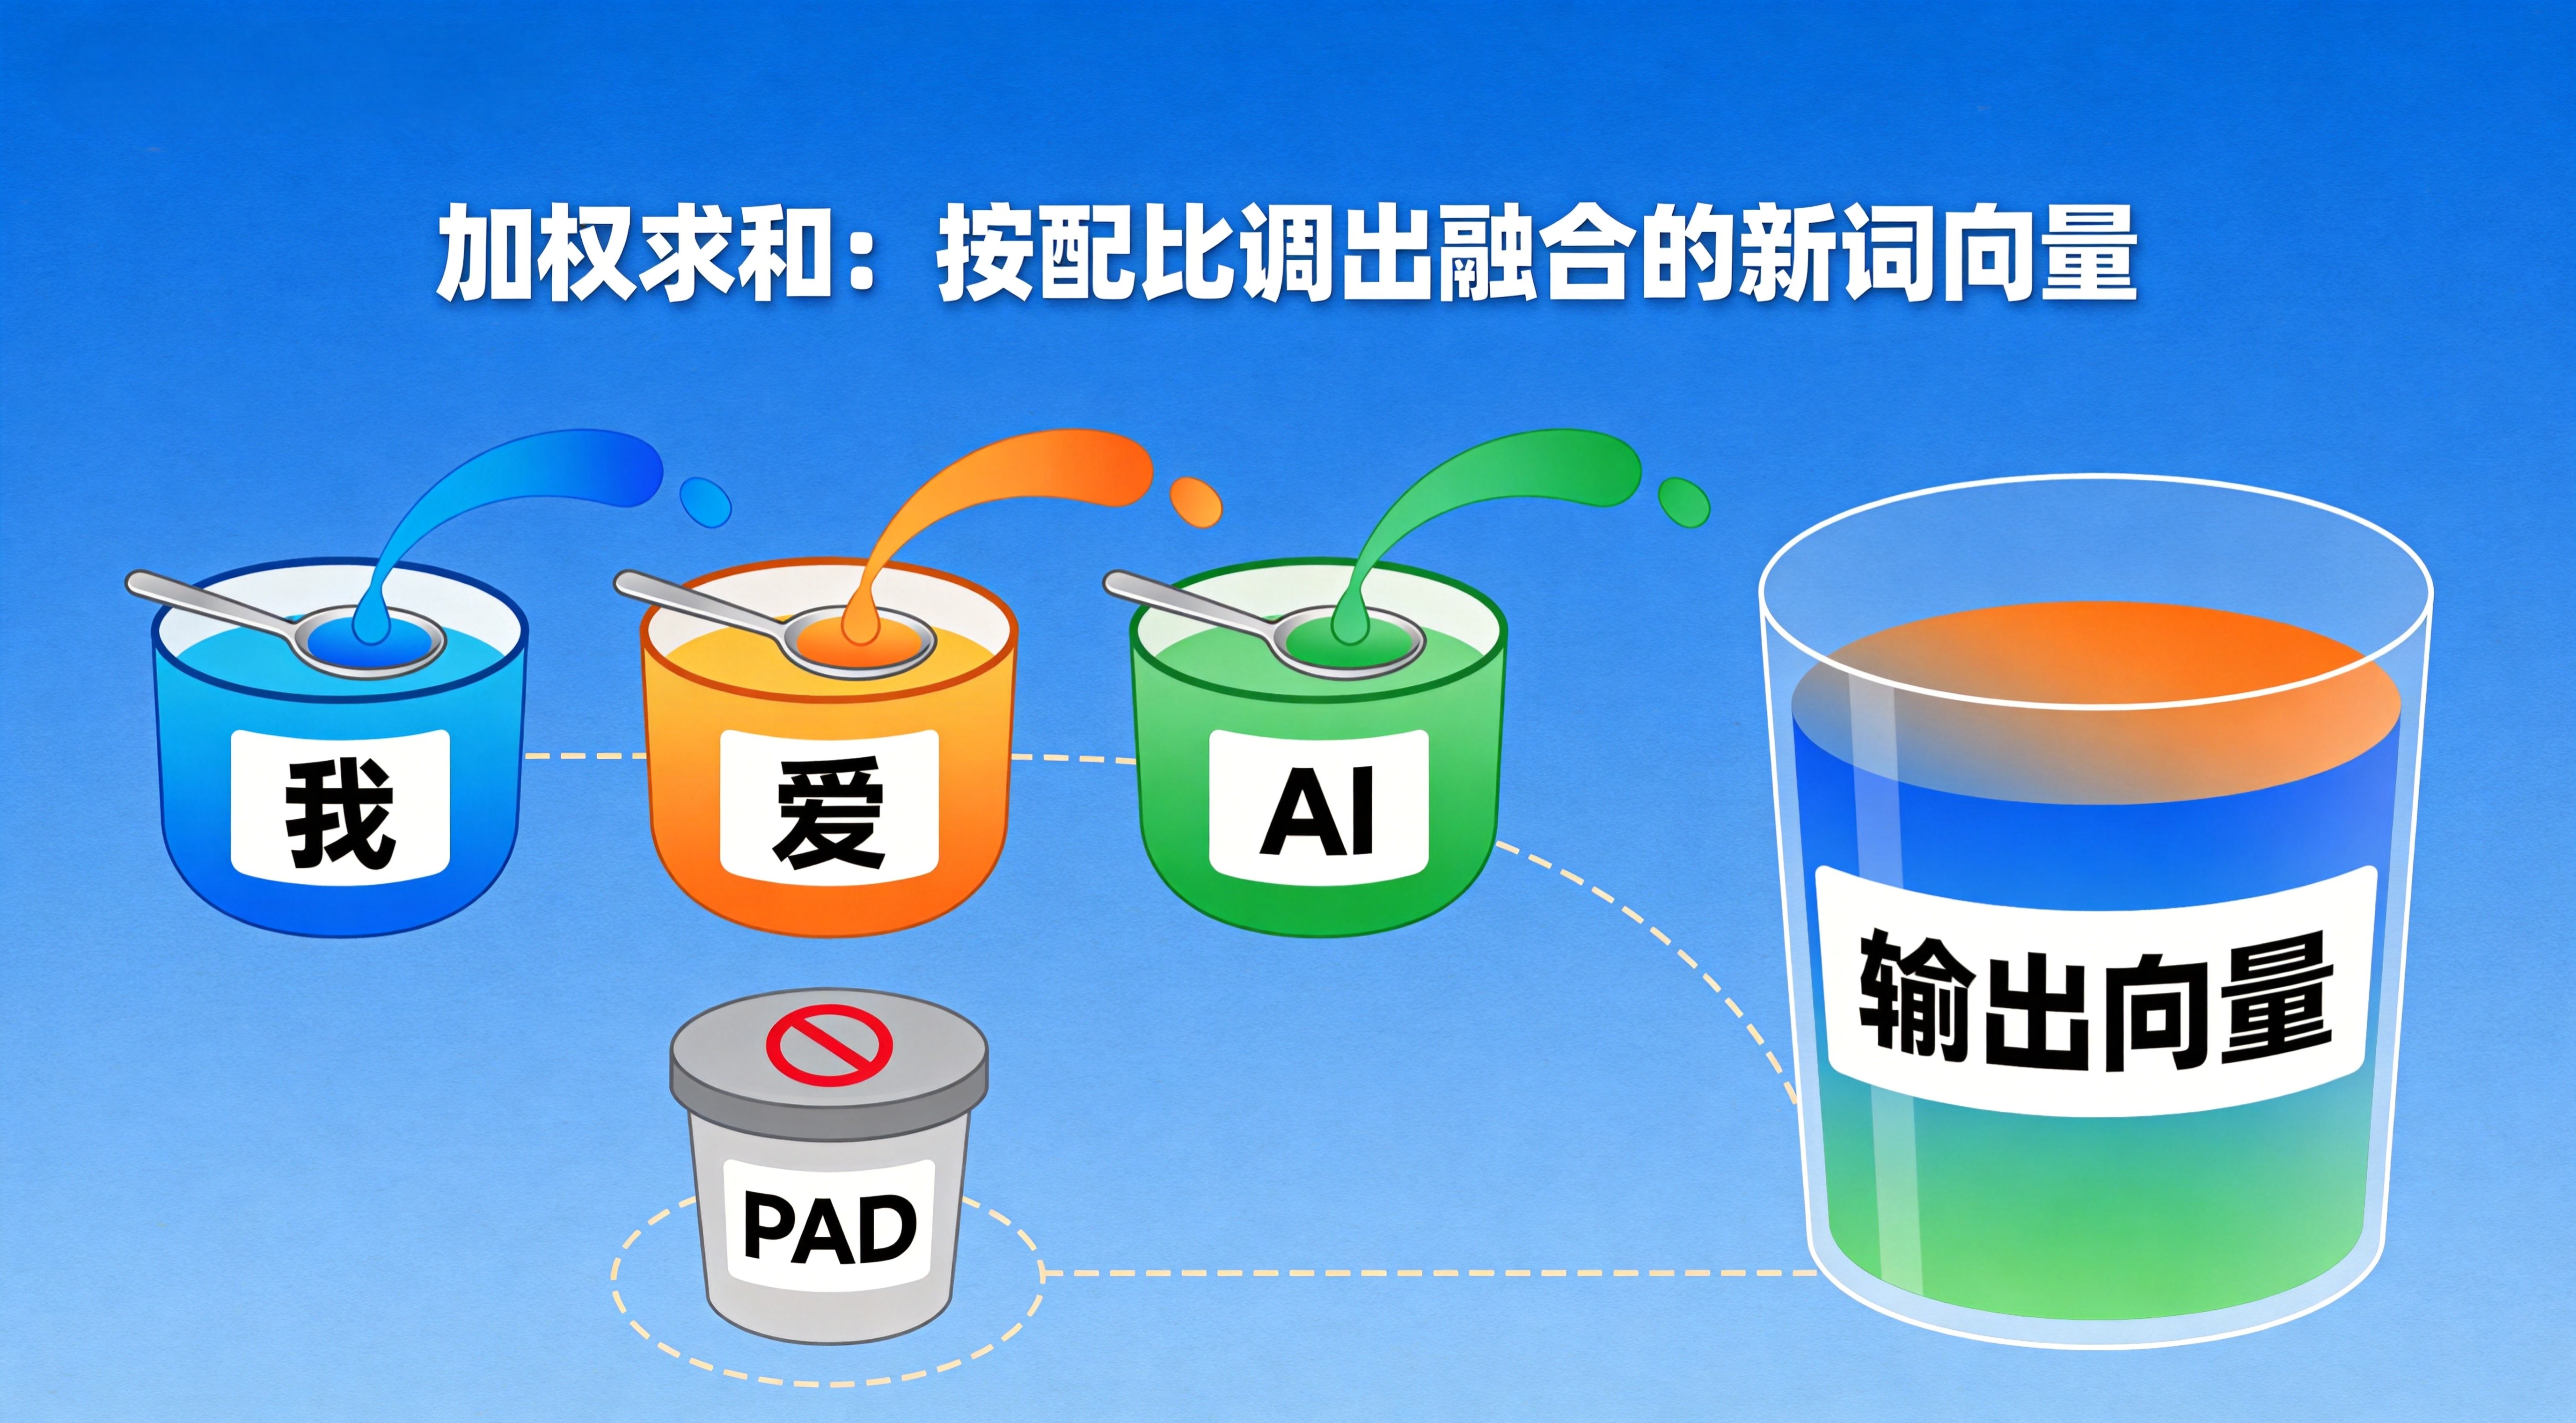
加权求和:每个词的输出,是所有词的 V 按注意力权重调出的「混合饮料」——权重高的词,味道占比大;PAD 位置权重为 0,一点不掺。
九、完整代码:30 行跑通单头 Self-Attention
把五步串起来——投影、打分、缩放、mask、Softmax、加权——纯 NumPy 实现如下(W 矩阵取课程 Excel 演示值,所以跑出来的数字和上文表格完全一致;真实模型中这些矩阵随机初始化、由训练学出):
import numpy as np

def self_attention(X, Wq, Wk, Wv, mask=None):

# 1. 三次线性投影

Q = X @ Wq

K = X @ Wk

V = X @ Wv

d = Q.shape[1]

# 2. 打分并缩放

scores = Q @ K.T / np.sqrt(d) # [S, S]

# 3. Padding Mask:把 PAD 列打成负无穷

if mask is not None:

scores[:, mask == 0] = -1e9

# 4. 按行 Softmax(减最大值防溢出)

scores = scores - scores.max(axis=1, keepdims=True)

exp = np.exp(scores)

exp[:, mask == 0] = 0 # PAD 列 e^x 直接清零

weights = exp / exp.sum(axis=1, keepdims=True)

# 5. 加权求和

return weights @ V, weights # [S, D], [S, S]

# X: 5×8(「我爱AI」+2个PAD),mask: 1 真实词 / 0 PAD

mask = np.array([1, 1, 1, 0, 0])

out, attn = self_attention(X, Wq, Wk, Wv, mask)

print(attn[0]) # [0.334 0.357 0.309 0. 0. ]

print(out[0]) # [0.44 0.23 0.09 0.16 ...]
PyTorch 里这一整段就是官方的一个函数调用,数学完全相同:
import torch.nn.functional as F

out = F.scaled_dot_product_attention(

Q, K, V, attn_mask=padding_mask, is_causal=False)
十、小结:一个公式,五个动作
单头 Self-Attention 的全部秘密,可以压成一行公式:
Attention(Q,K,V) = softmax( Q@K.T / √d + mask ) @ V
对应五个动作,回顾一遍:
1. 投影:X 乘 W_q/W_k/W_v,一个词分饰提问者、书签、内容三个角色;
2. 打分:Q·Kᵀ 算两两相关度,得到词与词的 5×5 对照表;
3. 缩放:除以 √d,防止维度高时 Softmax 退化成单点下注;
4. Mask + Softmax:PAD 列打成 -1e9 清零,再归一化成和为 1 的权重;
5. 加权求和:按权重混合所有词的 V,每个词都带着上下文信息离开。
本文是系列课程《AI算法实战:从零手搓 Transformer 架构与反向传播训练》的配套文章。
课程提供 NumPy 和 PyTorch 双版本完整代码实现,从零开始构建一个可运行的 LLM。
课程地址:https://edu.fanruan.com/video/837
授课讲师:帅杰
转载须知:非商业转载请注明作者及原文链接,商业转载请联系作者授权。


