1 团队介绍
本作品由个人独立完成。本人具备 Python 数据分析、轨迹数据处理与可视化实践经验,为开展本次数据分析,主动查阅内河航运、AIS 船舶信号相关业务资料,独立完成 AIS 原始数据清洗处理、航行衍生指标计算、多维度分析建模、可视化图表设计以及报告全文撰写,实现从原始轨迹数据到海事业务可用决策建议的完整输出。
2 作品背景
长江重庆段是长江上游重要航运枢纽,锚地和码头承担船舶待泊、中转作业职能。传统海事管理依靠人工巡检与台账记录,存在明显局限:难以区分过境船舶和常驻作业船舶,真实核心运力底数不清;海量轨迹依靠人工筛查异常,效率低下容易遗漏;停泊热点仅依靠经验判断,缺少量化数据支撑调度决策。
锚地资源紧张会直接推高船舶待泊滞期成本,过境船舶长时间无效占泊挤压本地作业船舶泊位资源,进一步造成码头周转变慢、船舶等待时间延长等连锁业务损失。本作品依托 AIS 轨迹数据集,挖掘水域真实船舶运营特征,定位锚地运行短板,识别异常船舶行为,输出可落地的调度建议,以此提升锚地泊位资源利用效率,降低船舶待泊带来的滞期损耗。
3 制作流程
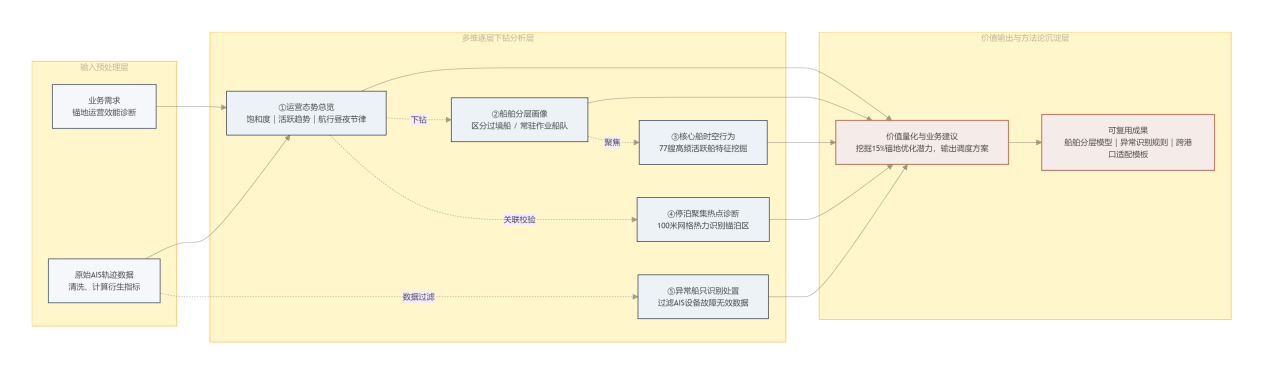
本作品采用业务需求驱动→数据预处理→指标建模→多维度分析→可视化呈现→业务建议输出的业务架构,整体分为五大实施阶段。
- 数据来源:选用 2021 年 7 月 24 日‑7 月 31 日长江重庆段 AIS 轨迹数据,包含 414 艘船舶,合计 102865 条轨迹记录。
关键字段业务释义:
- MMSI:船舶水上移动通信标识码,作为船舶唯一身份编号;
- 时间:AIS 信号上报时间戳;
- 经纬度(LON、LAT):船舶实时地理位置;
- 航向 COURSE:船舶对地航行方向;
- 航速 SPEED:船舶对地航行速度(单位:节)。
第二,数据预处理:清洗原始轨迹,计算航行距离、瞬时航速、航向变化角度等衍生指标;过滤单点停滞、信号跳变的无效记录,生成高质量分析数据集。
第三,框架设计:采用宏观到微观逐层下钻逻辑,依次开展运营态势总览、船舶分层画像、核心船时空行为、停泊热点识别、异常船只筛查、价值估算与建议,形成分析闭环。
第四,可视化实现:匹配业务选用折线趋势图、环形占比图、网格热力图等,把海量轨迹数据转化为直观可视化视图。
第五,结论沉淀:结合海事业务解读分析结果,沉淀船舶分层、异常识别规则,校准参数后可复用于其他港口。
4 成果展示
本作品基于 AIS 轨迹数据完成长江重庆段船舶全维度量化诊断,摸清锚地实际运行现状,定位停泊聚集热点,识别信号异常船舶,测算可挖掘 15% 锚地优化空间,输出可落地调度方案,为内河海事锚地资源调配提供量化的数据参考。
4.1 模块一:运营态势总览
锚地饱和度 8.8% 已接近容量上限,过境船舶占比 56%,造成锚地周转效率偏低,核心活跃船队占比仅 18.6%。日活跃船舶呈 V 型变化,7 月 28 日到达谷底,需要排查航道管制、天气或者数据采集异常等诱因。船舶活动具备显著日间偏好,凌晨船舶数量偏低,早上 6 点后活跃度快速抬升;89.4% 轨迹点为停泊状态,该水域属于典型锚泊港区。从整体运行特征能够看出,这片水域以船舶待泊、临时停靠功能为主,大量过境船挤占锚地资源,真正可调度的核心作业船队占比较小,锚地资源压力主要来自过路船舶的短暂停泊。
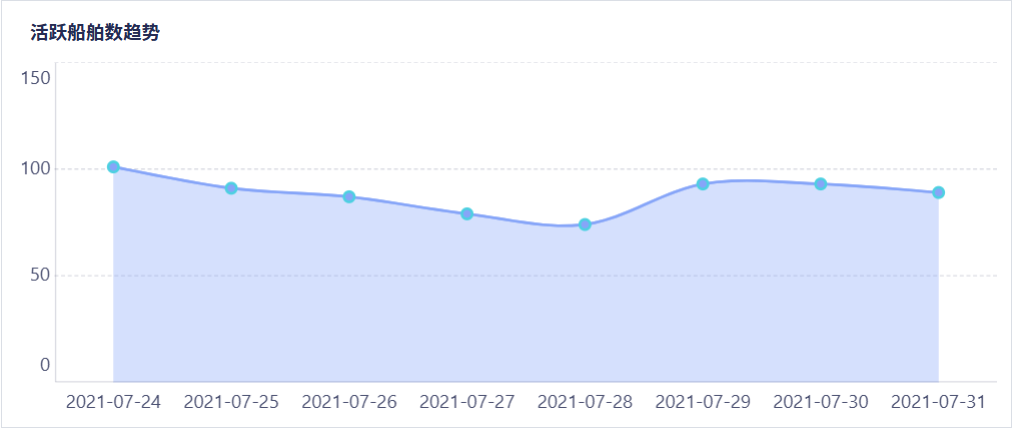
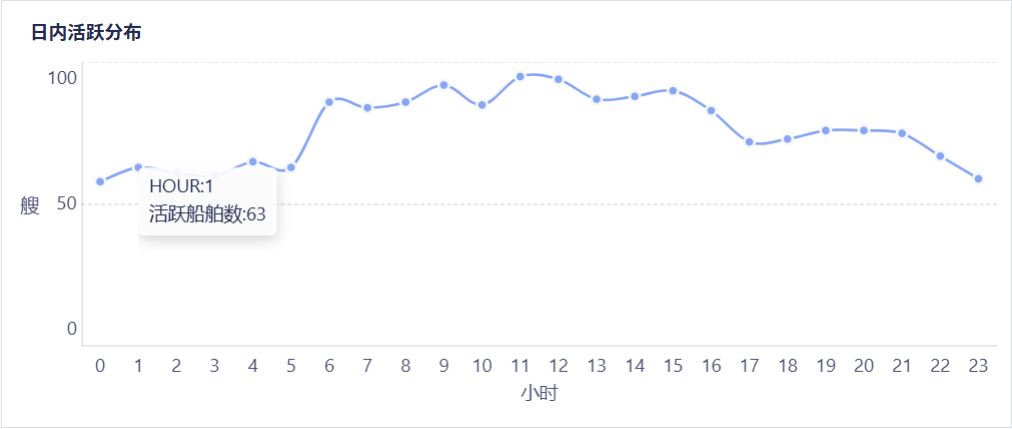
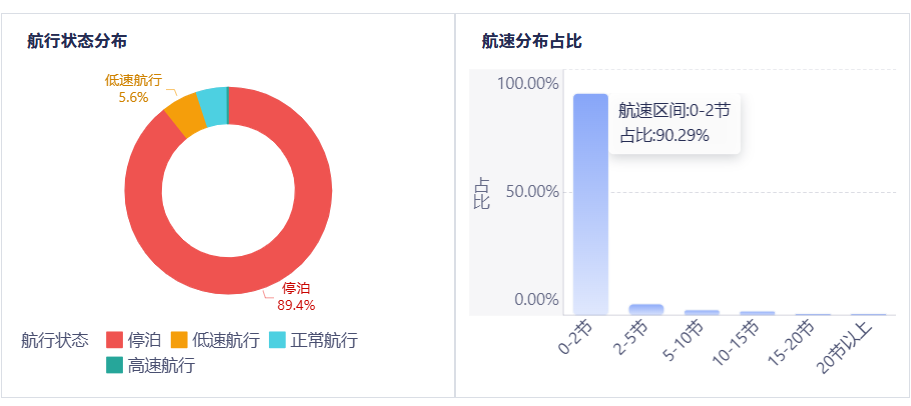
模块业务小结:该锚泊水域整体停泊占绝对主导;船舶数量存在周度波动与明显昼夜节律;大量过境船舶占用锚位是拉低周转效率的关键原因,调度管控应当重点关注过境船舶停泊时长。
4.2 模块二:船舶分层画像
从航速等级、活动范围、活跃度三个维度完成船舶群体划分。水域整体呈现多过客、少长驻的格局,偶现过路船舶占 47.0%,一般活跃船舶占 34.4%,高频活跃常驻作业船只仅占 18.6%。多数船舶只是短暂途经水域,常驻作业船队规模有限,评估真实运力不能只统计船舶总数量。如果直接将全部在航船舶当作本地运力,会高估港区作业能力,通过分层画像,可以把过境流动船舶和本地常驻作业船区分开,为锚地运力评估提供更加客观的划分依据。
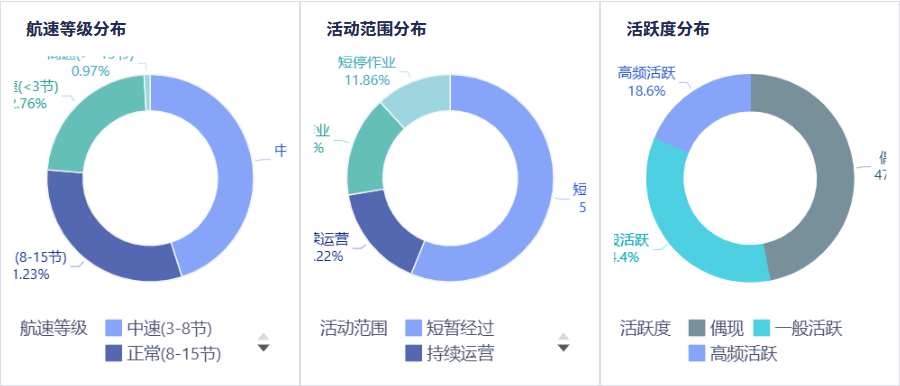
模块业务小结:水域近半数船舶为过路偶现船舶,不能作为本地作业运力;在开展锚地容量评估、运力测算时,需要过滤偶现过境船,以高频活跃船队作为真实作业运力基准。
4.3 模块三:核心活跃船只时空行为
选取 77 艘高频活跃船(轨迹点>100 条)分析,高频活跃船 94.42% 时间处于停泊,高频来自长期驻留的持续信号上报,并非连续航行。航向北向占比 49.24%,主流航行方向为顺江北上。区别全量船舶的昼夜差异,核心船队全天活跃度稳定,在船舶数量低谷阶段可以起到运力补位的作用。即使整体水域船舶数量下降,这部分核心船只依旧保持在岗驻留,是港区最稳定的运力基本盘,在后续调度监控中可以作为重点关注对象。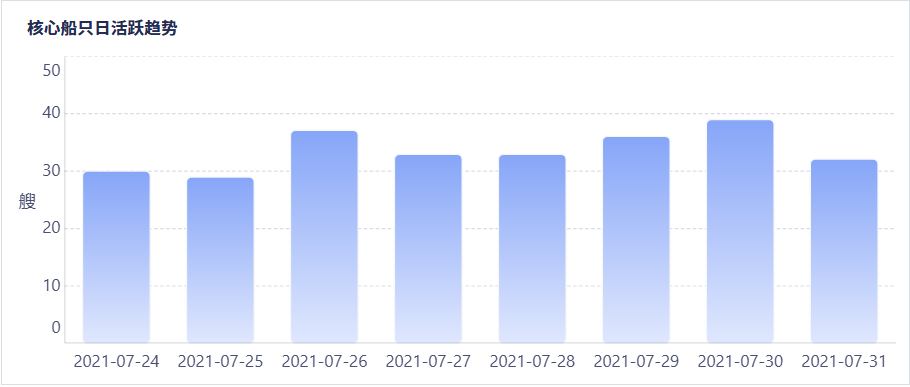
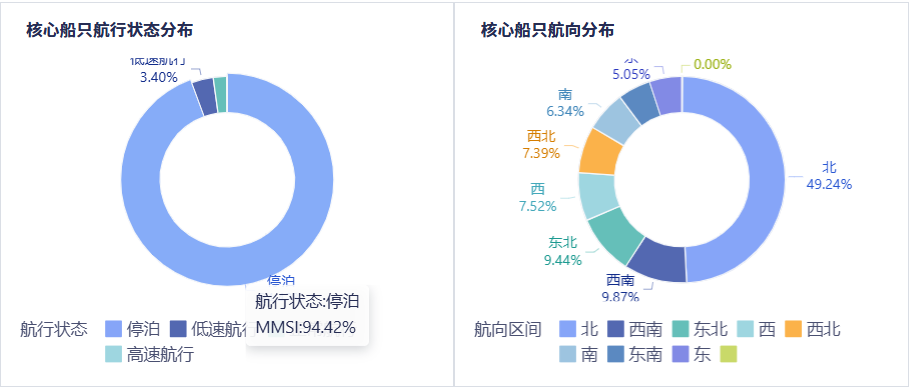
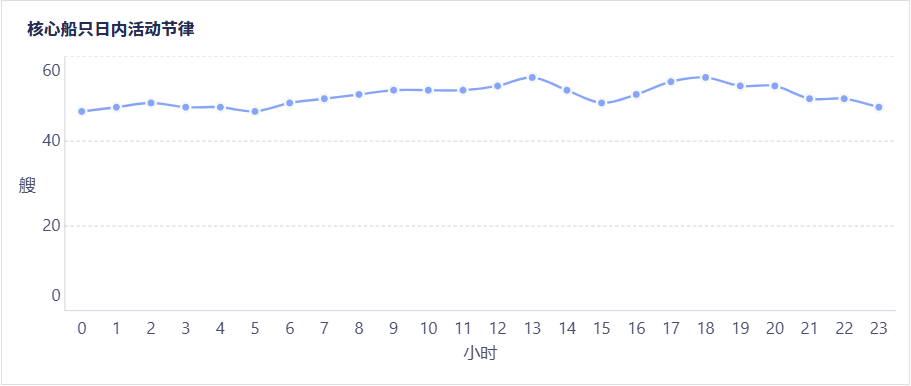
模块业务小结:77 艘高频活跃船是港区稳定作业基本盘,不受昼夜变化影响;主流流向为北上;在整体船舶数量下行周期,该批船只可以维持港区基础作业能力,建议纳入常态化重点监控清单。
4.4 模块四:停泊聚集区域诊断
采用 100 米网格聚合停泊轨迹,识别两处停泊热点。核心锚泊区单网格最多停靠 16 艘船,次级码头聚集区聚集 20 艘船舶。两处区域对应重庆港主要锚地与码头泊位,船舶高度集中停靠,资源趋近饱和,需要重点做好泊位分配与锚地调度管理。船舶停泊不是均匀散布在整片水域,而是高度集中在两片有限区域,容易造成局部区域拥挤,也提示后续调度可以针对热点区域做精细化管控,缓解局部锚泊压力。
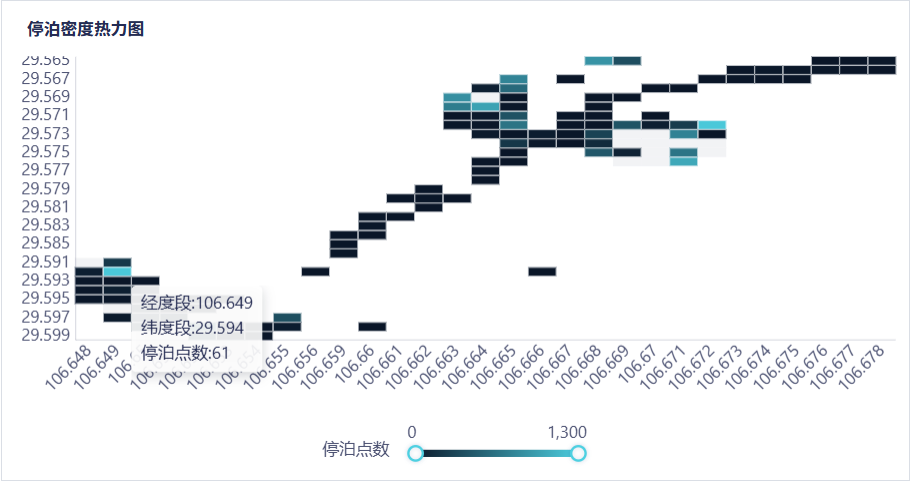 模块业务小结:船舶停泊高度集中在两块热点网格,而非全域均匀分布;锚地压力集中在局部水域,不需要全域平均管控,应当针对热点锚泊网格优先实施调度优化。
4.5 模块五:异常船只识别与处置
414 艘船舶中共识别 92 艘异常船只:75 艘单点停滞无效船,大多为 AIS 信号异常;17 艘超速船航速超过内河阈值。剔除单点停滞船后,有效监控船舶为 322 艘;超速船舶需要核查 MMSI 编号,排查终端信号冲突、设备故障,减少异常数据干扰统计结果。AIS 设备故障、信号丢包会产生大量无效记录,如果不做识别过滤,会虚增船舶数量,歪曲锚地真实运行情况,该套异常识别规则可以作为常态化监控的筛查条件。
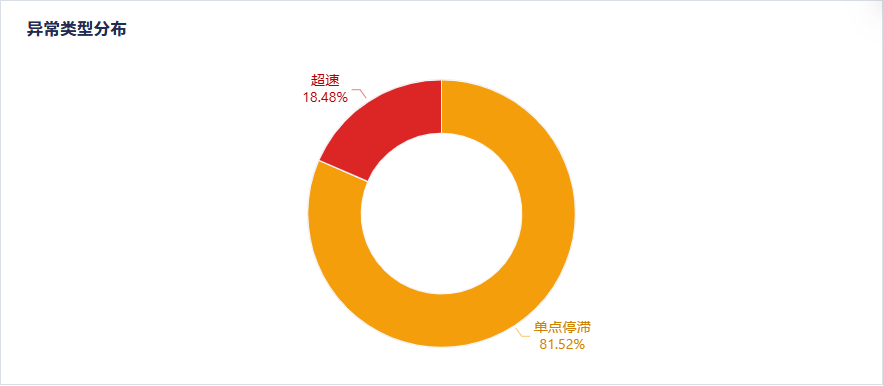
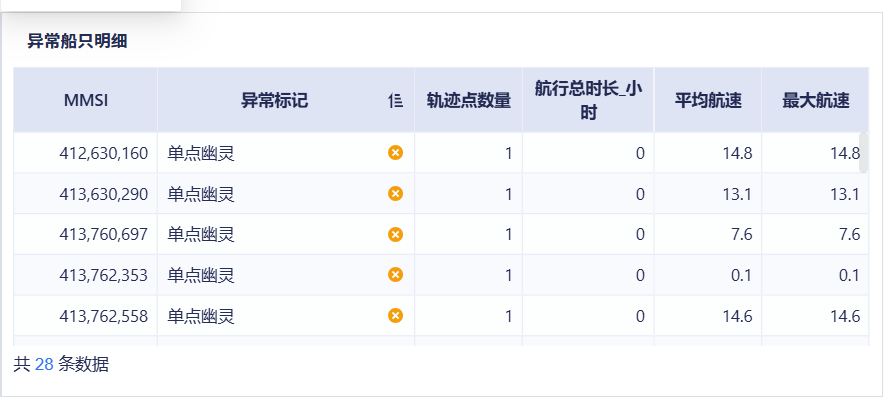
模块业务小结:AIS 设备故障产生大量单点停滞无效数据,如果直接统计原始数据会虚增船舶规模;开展锚地指标统计前,必须先过滤信号异常船只,保障统计口径真实可信。
4.6 模块六:价值量化与行动建议
测算假设说明:基于观测周期过境船占比 56%,过境船舶平均停泊 4.2 小时;假设通过调度管控,将过境船无效停泊时长压缩 30%,释放对应的锚位资源;在锚地总容量 500 艘的基线下测算得到:可释放 15% 锚地容量,可多容纳约 65 艘船舶,锚地周转效率提升 30%。
经测算,优化调度管控过境船舶停泊时长,可释放 15% 锚地容量,可多容纳约 65 艘船舶,周转效率提升 30%。建议排查 7 月下旬船舶数量下跌诱因;评估核心锚泊区调度水平;校验超速船舶设备信号;常态化统计剔除无效船只;建立 77 艘核心活跃船重点跟踪清单。以上建议全部基于本次数据分析结果提出,既包含短期问题排查工作,也有长期常态化监控机制,兼顾应急处置和日常运营,具备落地实操性。
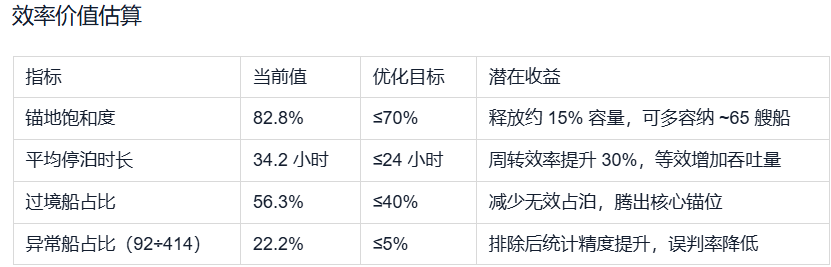
模块业务小结:锚地优化的核心抓手在于管控过境船舶无效停泊;通过流程调度优化,无需硬件扩建,即可实现可观的容量释放与周转提升。
5 总结与分享
本次独立完成整套可视化分析,完整经历数据处理、指标搭建、图表制作、结论输出的全流程,收获诸多实践体会。 第一,数据清洗是海事轨迹分析的基础。项目初期直接使用原始数据,未过滤单点停滞异常记录,统计结果出现偏差,由此意识到预处理过滤干扰数据必不可少,才能保证分析贴合真实业务。 第二,数据分析不能只看数字,要结合行业常识。结合内河航速、锚地容量等业务背景,才能区分设备故障和船舶真实运营行为,产出具备实际参考价值的建议。 第三,自上而下的分析逻辑更适合讲数据故事。先把握宏观全貌,再向下挖掘细节,避免过早陷入零散单船轨迹而看不清整体态势。 第四,本次沉淀的船舶分层、异常识别规则通用性较强,微调参数就可以迁移到其他内河、沿海港口开展同类分析。 第五,单人完成项目缺少同伴交叉审核,工作中需要多次复核原始数据、计算指标与分析逻辑,多轮自查规避疏漏,保障分析严谨准确。
后续优化与拓展方向:
- 时间维度拓展:接入更长周期(月度、季度)AIS 轨迹数据,消除单周观测周期带来的偶然性,挖掘季节、汛期对锚地运营的影响;
- 空间复制:将本项目沉淀的分层模型、异常识别规则迁移至长江沿线其他内河港口,形成可复用的锚地诊断模板;
- 系统落地:基于 FineBI 搭建常态化监控看板,实现锚地饱和度、船舶分层、异常船只自动告警,从一次性分析转为实时监控;
- 维度扩展:接入船型、货种数据,进一步区分散货船、集装箱船,细化不同船舶群体的停泊行为研究。
作品链接:https://next.finebi.com/decision/application/d1e83c2306d9454789630a030dfde6
注:该数据源由原始数据经过pandas初步清洗后而得,下附原始数据和pandas代码
原始数据(AIS 船舶轨迹.csv):

代码:
# 导入所需库
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import warnings
warnings.filterwarnings('ignore')
# 设置中文字体,避免图表中文乱码
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False
# ===================== 1. 数据读取【适配你的文件路径】 =====================
# 完整绝对路径,Windows使用正斜杠
df = pd.read_csv('./data/210724铜锣峡210731.csv', dtype={'MMSI': str})
print("===== 数据基础信息 =====")
print(f"数据总行数:{len(df)}")
print(f"数据列名:{df.columns.tolist()}")
print(f"数据时间范围:{df['TIME'].min()} 至 {df['TIME'].max()}")
print(f"唯一船舶数量:{df['MMSI'].nunique()}")
print("\n数据前5行预览:")
print(df.head())
print("\n数据缺失值统计:")
print(df.isnull().sum())
print("\n数据描述性统计:")
print(df.describe())
# ===================== 2. 数据清洗 =====================
# 关键列缺失直接删除
df = df.dropna(subset=['MMSI', 'TIME', 'LON', 'LAT'])
# 数值缺失填充0
df[['COURSE', 'HEADING', 'SPEED']] = df[['COURSE', 'HEADING', 'SPEED']].fillna(0)
# 删除同一船同一时间重复轨迹
df = df.drop_duplicates(subset=['MMSI', 'TIME'], keep='first')
# 区域经纬度过滤(铜锣峡范围)
df = df[(df['LON'] >= 106.5) & (df['LON'] <= 106.8)]
df = df[(df['LAT'] >= 29.5) & (df['LAT'] <= 29.7)]
# 速度过滤
df = df[(df['SPEED'] >= 0) & (df['SPEED'] <= 100)]
# 航向过滤,511为无效值保留
df = df[(df['COURSE'] >= 0) & (df['COURSE'] <= 360)]
df = df[(df['HEADING'] >= 0) | (df['HEADING'] == 511)]
# 时间转换
df['TIME_DATETIME'] = pd.to_datetime(df['TIME'], format='%Y%m%d%H%M%S', errors='coerce')
df = df.dropna(subset=['TIME_DATETIME'])
# 拆分时间特征
df['DATE'] = df['TIME_DATETIME'].dt.date
df['HOUR'] = df['TIME_DATETIME'].dt.hour
df['MINUTE'] = df['TIME_DATETIME'].dt.minute
print("\n===== 清洗后数据信息 =====")
print(f"清洗后总行数:{len(df)}")
print(f"清洗后唯一船舶数量:{df['MMSI'].nunique()}")
print(f"清洗后时间范围:{df['TIME_DATETIME'].min()} 至 {df['TIME_DATETIME'].max()}")
# ===================== 3. 特征提取 =====================
# 单船统计指标
ship_group = df.groupby('MMSI').agg(
轨迹点数量=('TIME', 'count'),
首次出现时间=('TIME_DATETIME', 'min'),
末次出现时间=('TIME_DATETIME', 'max'),
航行总时长_小时=('TIME_DATETIME', lambda x: (x.max() - x.min()).total_seconds() / 3600),
平均航速=('SPEED', 'mean'),
最大航速=('SPEED', 'max'),
最小航速=('SPEED', 'min'),
平均航向=('COURSE', 'mean'),
经度跨度=('LON', lambda x: x.max() - x.min()),
纬度跨度=('LAT', lambda x: x.max() - x.min())
).reset_index()
# 排序,计算相邻轨迹差值
df = df.sort_values(by=['MMSI', 'TIME_DATETIME']).reset_index(drop=True)
df['时间差_秒'] = df.groupby('MMSI')['TIME_DATETIME'].diff().dt.total_seconds()
df['经度差'] = df.groupby('MMSI')['LON'].diff()
df['纬度差'] = df.groupby('MMSI')['LAT'].diff()
# 哈弗辛公式计算两点距离(米)
def haversine(lon1, lat1, lon2, lat2):
lon1, lat1, lon2, lat2 = map(np.radians, [lon1, lat1, lon2, lat2])
dlon = lon2 - lon1
dlat = lat2 - lat1
a = np.sin(dlat/2)**2 + np.cos(lat1) * np.cos(lat2) * np.sin(dlon/2)**2
c = 2 * np.arcsin(np.sqrt(a))
r = 6371000
return c * r
df['航行距离_米'] = haversine(df['LON'], df['LAT'], df['LON'].shift(1), df['LAT'].shift(1))
# 米/秒 转 节
df['瞬时航速_节'] = df['航行距离_米'] / df['时间差_秒'] * 3.6 / 1.852
df['航向变化_度'] = df.groupby('MMSI')['COURSE'].diff().abs()
# 填充第一行空值
fill_cols = ['时间差_秒','经度差','纬度差','航行距离_米','瞬时航速_节','航向变化_度']
df[fill_cols] = df[fill_cols].fillna(0)
# 航行状态划分
df['航行状态'] = np.where(df['SPEED'] < 1, '停泊',
np.where(df['SPEED'] < 5, '低速航行',
np.where(df['SPEED'] < 15, '正常航行', '高速航行')))
print("\n===== 船舶航行特征统计 =====")
print(ship_group.describe())
# ===================== 4. 统计分析 =====================
status_dist = df['航行状态'].value_counts(normalize=True) * 100
print("\n===== 航行状态分布(占比%) =====")
print(status_dist)
hourly_ship = df.groupby('HOUR')['MMSI'].nunique()
print("\n===== 每小时船舶数量 =====")
print(hourly_ship)
daily_ship = df.groupby('DATE')['MMSI'].nunique()
print("\n===== 每日船舶数量 =====")
print(daily_ship)
# 航速分段
speed_bins = [0,2,5,10,15,20,100]
speed_labels = ['0-2节','2-5节','5-10节','10-15节','15-20节','20节以上']
df['航速区间'] = pd.cut(df['SPEED'], bins=speed_bins, labels=speed_labels, right=False)
speed_dist = df['航速区间'].value_counts(normalize=True)*100
print("\n===== 航速区间占比 =====")
print(speed_dist)
# 航向分段
course_bins = [0,45,90,135,180,225,270,315,360]
course_labels = ['北','东北','东','东南','南','西南','西','西北']
df['航向区间'] = pd.cut(df['COURSE'], bins=course_bins, labels=course_labels, right=False)
course_dist = df['航向区间'].value_counts(normalize=True)*100
print("\n===== 航向区间占比 =====")
print(course_dist)
# ===================== 5. 绘图 =====================
# 1.航速直方图
plt.figure(figsize=(12,6))
sns.histplot(df['SPEED'], kde=True, bins=50)
plt.title('船舶航速分布直方图')
plt.xlabel('航速(节)')
plt.ylabel('轨迹点数')
plt.grid(alpha=0.7)
plt.savefig('航速分布直方图.png', dpi=300, bbox_inches='tight')
plt.show()
# 2.航行状态饼图
plt.figure(figsize=(8,8))
plt.pie(status_dist.values, labels=status_dist.index, autopct='%1.1f%%', startangle=90)
plt.title('船舶航行状态分布')
plt.axis('equal')
plt.savefig('航行状态饼图.png', dpi=300, bbox_inches='tight')
plt.show()
# 3.小时船舶折线
plt.figure(figsize=(12,6))
plt.plot(hourly_ship.index, hourly_ship.values, marker='o')
plt.title('24小时在线船舶数量')
plt.xlabel('小时')
plt.ylabel('船舶数')
plt.xticks(range(0,24))
plt.grid(alpha=0.7)
plt.savefig('小时船舶数量.png', dpi=300, bbox_inches='tight')
plt.show()
# 4.航向玫瑰图
plt.figure(figsize=(10,10))
ax = plt.subplot(111, projection='polar')
theta = np.linspace(0, 2*np.pi, 8, endpoint=False)
width = 2*np.pi/8
ax.bar(theta, course_dist.values, width=width, alpha=0.7)
ax.set_xticks(theta)
ax.set_xticklabels(course_labels)
plt.title('船舶航向玫瑰图', pad=20)
plt.savefig('航向玫瑰图.png', dpi=300, bbox_inches='tight')
plt.show()
print("\n已生成4张图片保存在当前代码文件夹")
# ===================== 6. 输出Excel =====================
with pd.ExcelWriter('船舶轨迹分析结果.xlsx') as writer:
df.to_excel(writer, sheet_name='清洗后数据', index=False)
ship_group.to_excel(writer, sheet_name='单船统计', index=False)
status_dist.to_excel(writer, sheet_name='航行状态')
hourly_ship.to_excel(writer, sheet_name='每小时船舶')
daily_ship.to_excel(writer, sheet_name='每日船舶')
speed_dist.to_excel(writer, sheet_name='航速分布')
course_dist.to_excel(writer, sheet_name='航向分布')
print("\nExcel分析文件已生成:船舶轨迹分析结果.xlsx")


