从“重新搜”到“版本资产”——FaceGraph 脸谱
2026 · 帆软智数先锋 AI 创新大赛 · 个人方向
脸谱
FACEGRAPH
一张图谱看清一个行业:基于 MOSS 的行业研究图谱智能体
《脸谱》把一句自然语言里的行业问题,拆成一张能追证、能复跑、还能持续更新的行业图谱。MOSS 负责商业事实检索与 Skill 运行,FaceGraph 负责候选召回、实体识别、分类、证据组织与图谱生成,Evidence Ledger 记录每项判断的依据,Version Diff 记录行业变化。首轮真实 Run 已跑通最小链路,后续以人工基线、复核成本和版本复跑继续验证业务收益。
2m50s 首轮最小链路|MOSS 实测
8 一级赛道|Taxonomy 输出
48+ 代表厂商|首轮图谱规模
19 信息来源|本次运行记录
QUESTION → GRAPH|一个人上场,背后像跟着一支行业研究小组
00 · 正文目录 / READING ROUTE
四章一条主线|严格对齐个人方向写作模版
本项目书按大赛个人方向要求重构为四章:先讲企业背景与业务目标,再还原业务痛点;核心方案集中说明 MOSS、FaceGraph、数据底账、Skill、算法、实测与复现;最后统一用“已实测 / 验收目标 / 计算公式”三类口径量化价值。技术材料不再单独扩成一级章节,全部回收到“核心方案”中。
- 企业背景与业务目标|业务场景 → 现状差距 → 工具定位 → 量化业务目标
二、业务痛点|场景还原 → 一号位焦虑 → 量化影响 → 人天成本 → 受影响角色
三、核心方案|产品命题 → MOSS/帆软融合 → 生成链 → 产品体验 → 数据底座 → Skill算法 → 实测复现
四、价值量化|业务价值 → 管理效率 → 数字资产 → Before/After → 验收指标 → 方法沉淀
正式目录
|
编号
|
章节
|
这一章回答什么
|
|
一
|
企业背景与业务目标
|
1.1 企业背景与场景|1.2 现状差距|1.3 工具定位|1.4 量化业务目标
|
|
二
|
业务痛点
|
2.1 场景还原|2.2 一号位焦虑|2.3 量化影响|2.4 人天/返工成本|2.5 用户与场景
|
|
三
|
核心方案
|
3.1 产品命题|3.2 帆软产品融合|3.3 MOSS 与生成链|3.4 产品体验|3.5 数据底座|3.6 Skill算法|3.7 实测|3.8 MOSS实操
|
|
四
|
价值量化
|
4.1 业务/效率/资产价值|4.2 Before/After|4.3 验收指标|4.4 方法论沉淀
|
目录只保留四个一级章节。原“数据底座、Skill 架构、MOSS 实测、MOSS 实操”等内容全部收进第三章“核心方案”,避免结构完整却不符合大赛模版。
一、企业背景与业务目标
“工欲善其事,必先利其器。” —— 《论语·卫灵公》
FaceGraph 面向政企数字化服务、售前咨询、生态合作、技术选型和行业研究这些高频场景。它们有个共同毛病:老板的问题通常很短,活儿通常很长。嘴上只有一句“看看这个行业”,落到桌面上就是企业名单、产品、招采、专利、关系、Logo、政策一大摞,少一张都容易挨问。
翻译成班味:老板问“这个行业有哪些玩家”,团队收到的潜台词往往是——今晚先别急着关电脑。
1.1 企业背景与业务场景
企业做政企客户、售前方案、伙伴筛选和技术路线判断时,资料通常不缺,真正缺的是一张可信、够快、还能解释的行业全景。FaceGraph 把这类工作定义为“行业认知压缩”:把跨源搜索、主体辨认、赛道分类、证据核验、视觉整理和后续更新收拢成一条可复跑研究流水线。
• 业务目标A|覆盖:先回答“行业里到底都有谁”,减少只靠个人记忆、微信群和搜索结果前两页造成的漏项。
• 业务目标B|一致:再回答“为什么这么分”,让同层分类、主体层级和多标签规则能够复核。
• 业务目标C|可信:继续回答“凭什么上图”,关键对象可追回 MOSS 事实、来源与纳入理由。
• 业务目标D|可持续:最后回答“后来变了什么”,同一 MGO 周期重跑,用 Version Diff 记录行业变化。
1.2 业务现状与差距
现在的麻烦,归拢起来就是三个字:散、慢、难复用。资料散在搜索引擎、Excel、收藏夹和同事脑子里;换个人做同一个行业,分类口径也可能跟着换季;图终于画完了,判断依据却躺在聊天记录里。下次再来同一题,熟悉的剧情:重新搜。
|
散|信息像袜子
企业、产业链、招采、知产、关系、Logo 分散在不同来源。最麻烦的从来并不属于“有没有”,是“到底放哪了”。
|
慢|最后10%最磨人
真正费时间的是去重、分类、核验和排版。搜索很快,确认“它到底是谁”常常很慢。
|
难复用|每次像新项目
名单、分类、证据和版式没有统一对象模型,行业一换,前人的经验常常只剩一句“你参考我上次那个”。
|
1.3 工具定位|把一次性研究变成可复跑流水线
给 FaceGraph 定个位:它是一套“基于 MOSS 商业事实的行业研究与图谱生成 Skill”。MOSS 把企业、产业链、招采、知产、关系这些事实端上桌;FaceGraph 再把它们整理成候选全集、标准实体、分类树、证据账本和可读图谱。材料有了,接下来得有人把桌子收拾明白。
一句话:MOSS 像资料室,FaceGraph 像研究组。前者负责把材料找齐,后者负责别让材料堆成一座没人敢碰的山。
1.4 · QUANTIFIED BUSINESS OBJECTIVES
量化业务目标|先分清“已实测、验收目标、计算公式”
• 已实测|首轮 MOSS 最小链路 2分50秒;形成 8 个一级赛道、48+ 代表厂商、19 个信息来源。
• 验收目标|Evidence Coverage ≥ 90%;Entity Merge Accuracy ≥ 95%;Category Revision Rate ≤ 15%。这些指标用于下一阶段验收,不写成当前成绩。
• 计算公式|研究耗时下降率 =(人工基线工时 − Skill运行时间 − 人工复核时间)÷ 人工基线工时;研究节省工时 = 人工基线工时 − Skill运行时间 − 人工复核时间。
• 数据边界|当前缺少足够的人工基线样本和真实人时成本,因此不虚填“降低 X% / 节省 X 元”。下一轮实测补齐基线后,再把公式换成可验证的 Before/After。
二、业务痛点

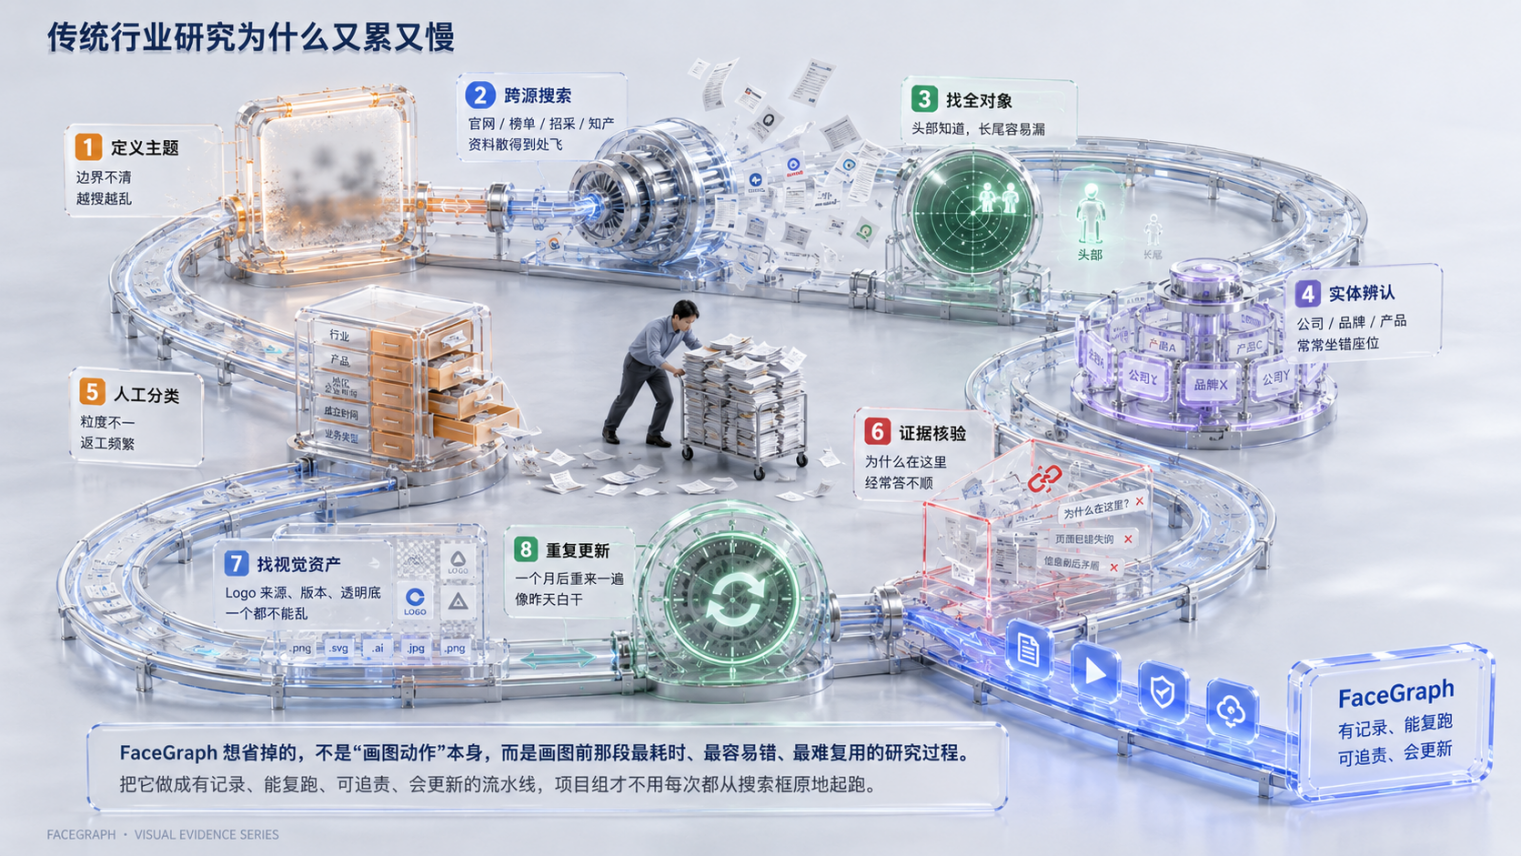
图2 传统行业研究的 8 个典型痛点
“知彼知己,百战不殆。” —— 《孙子兵法·谋攻》
2.1 业务场景还原|老板一句话,团队一串活
这种任务最喜欢临时出现。上午十点,领导来一句:“下午开会前给我一张运维工具全景图。”话只有十几个字,后面跟着的活儿却能排一长串:定范围、搜厂商、查主体、看产业链、核招采、补知产、做分类、找 Logo、排版、写结论。领导说完就走了,清单留下来了。
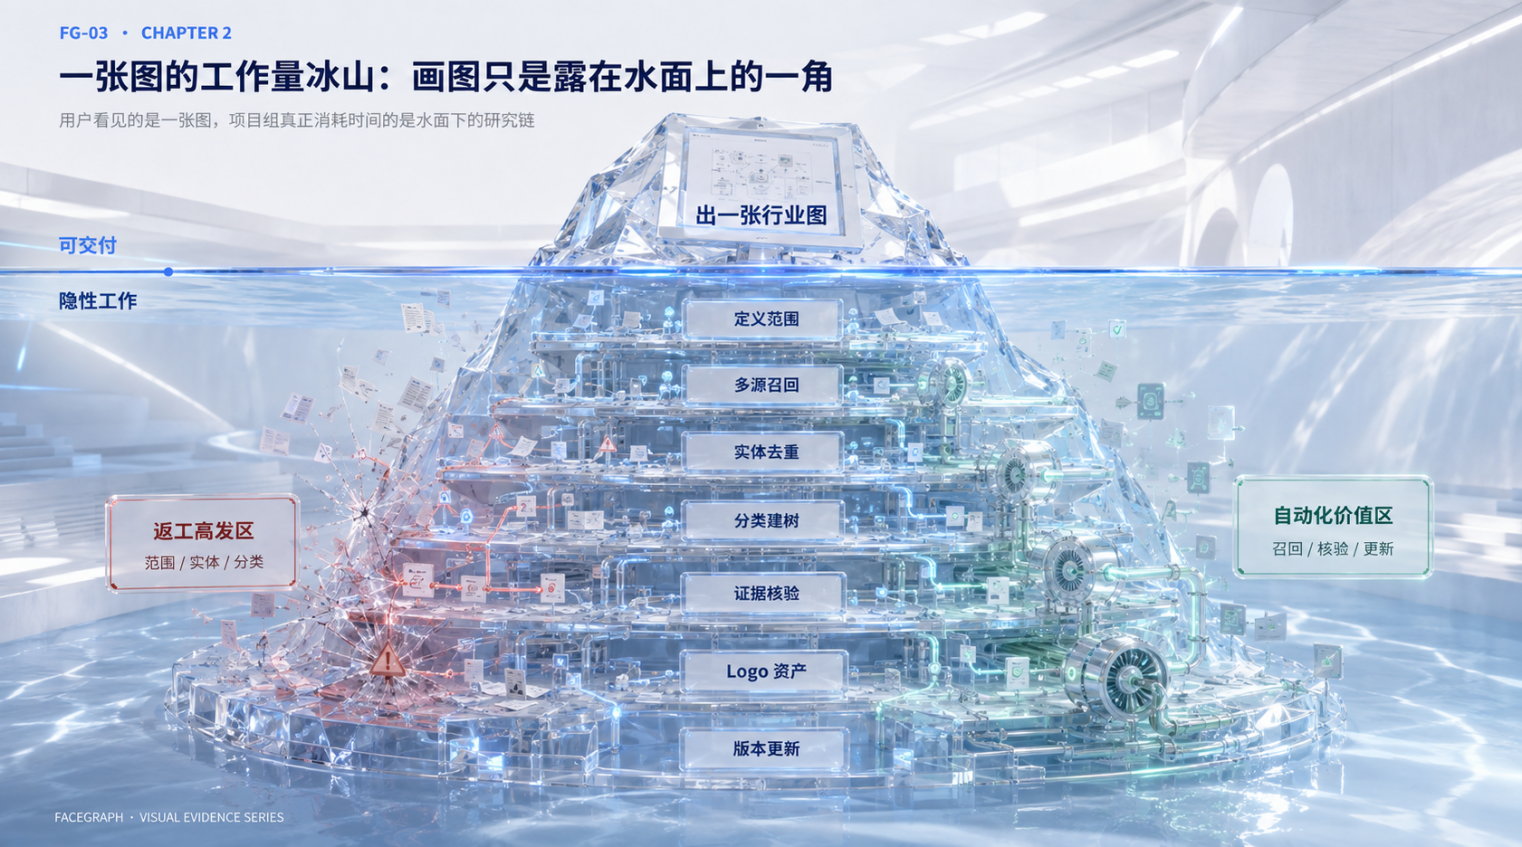
图解增强 03|老板一句话背后的工作量冰山
数据口径:任务结构示意,根据原稿列出的研究步骤归纳。
一句话读图:项目真正要自动化的,是画图之前那串看不见的研究脏活。
MOSS 的实测也很说明问题:第一次拿“运维”这个宽泛词去搜,一口气召回 5,288 条,光伏、风电、建筑运维都来凑热闹。真正值钱的工作从“搜到”之后才开始——得把 IT 运维厂商从这锅信息汤里一条条捞出来。
现场版理解:搜索框把门打开,FaceGraph 站在门口验身份——同行进来,客户进来,隔壁修空调的先等等。
2.2 一号位 / 业务主管焦虑|怕漏、怕错、怕问、怕慢、怕变、怕沉没
|
怕漏
“你说这是全景图,那行业前三怎么少了一家?”——漏一个头部厂商,整张图的气势先漏一半。
|
怕错
公司、品牌、产品、开源项目混在一起,领导看一分钟,团队解释半小时。
|
怕问
最要命的追问通常只有六个字:“为什么放这里?”没有 Evidence Ledger,回答很容易进入玄学。
|
|
怕慢
老板按小时要,人工研究按天算。速度与可信度经常互相拉扯。
|
怕变
行业更新以后,旧图继续流传。半年后再打开,像拿去年的天气预报安排今天出门。
|
怕沉没
做完一张图,底稿没有结构化沉淀;下一个同事接手,又从搜索框重新起跑。
|
2.3 痛点量化影响|从噪声、覆盖、结构、耗时、证据到更新
这部分数字不打肿脸。项目统一用“实测数据 + 项目基线”两套口径:MOSS 真跑出来的就写实测;人工工时这类还需要更多样本的,就老老实实继续积累。表格可以好看,数字别化妆。
|
观察项
|
传统状态
|
FaceGraph方式
|
验证口径
|
|
宽泛召回噪音
|
“运维”召回 5,288 条
|
ZT-01 收窄为 IT运维/AIOps/DevOps/监控等任务槽位
|
MOSS 实测运行记录
|
|
候选覆盖
|
多路来源人工拼接
|
产业链 1,111+2,589 家、画像查询 981/1,221 条等多路召回
|
MOSS 实测运行记录
|
|
最终结构
|
靠人工先列分类
|
8 个赛道、48+代表厂商
|
本次运维工具图谱实测
|
|
生成耗时
|
传统流程按任务统计
|
本次最小链路 2分50秒
|
MOSS 实测
|
|
证据组织
|
来源散在正文
|
Evidence Ledger + E0—E5
|
本次 Skill 输出
|
|
重复更新
|
人工重新对两版
|
ZT-07 生成 Version Diff
|
第二次同主题 Run 验证
|
2.4 · BUSINESS COST
痛点成本|真正贵的不是搜索,而是最后 10% 的反复确认
“欲速则不达。” —— 《论语·子路》
一上来就冲着“画图”跑,返工通常会在主体、分类和证据那里等着。前面省十分钟,后面还两小时,这类利息项目组都交过。
拿“云资源管理工具图谱”举例,分析人员通常要在多个网站和数据库之间来回切:搜、认、去重、分类、找Logo、核实,最后才轮到PPT。项目真正要省的,正是画图之前这段最碎、最磨人的路。
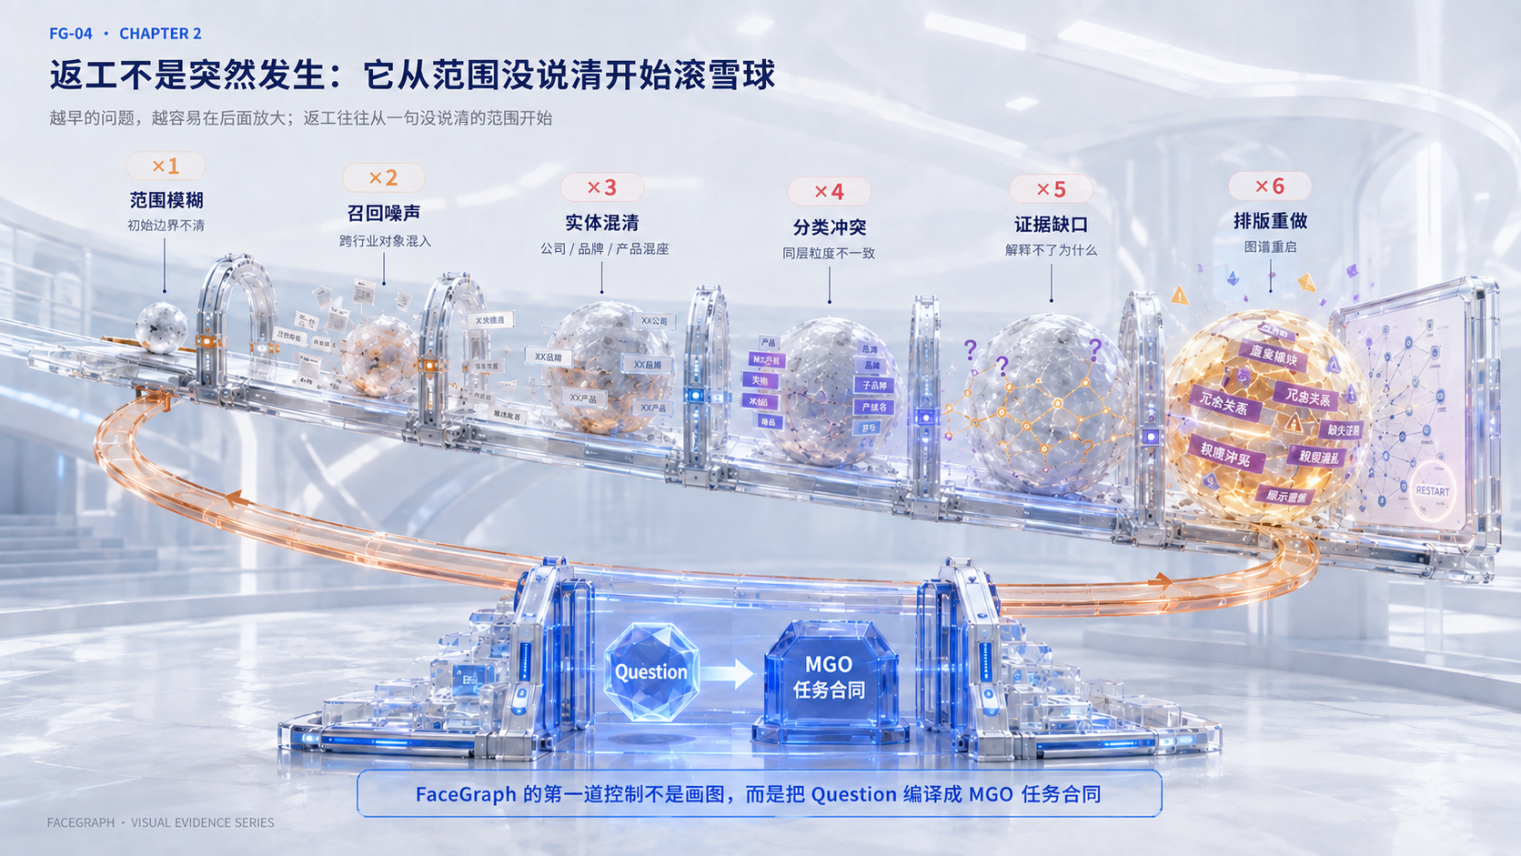
图解增强 04|传统行业研究的返工传导链
数据口径:因果链示意,不表示每个项目都会经历全部节点。
一句话读图:前端范围越模糊,后端实体、分类、证据和排版的返工成本越高。
定义主题
“云管理”到底包含哪些能力,边界和受众不先定,后面越搜越乱。
02
跨源搜索
行业网站、官网、榜单、招投标、知识产权等信息分散。
03
找全对象
只依赖认知会偏向头部品牌,长尾和新玩家容易漏掉。
实体辨认
集团、公司、品牌、产品经常被当作同一级对象。
05
人工分类
分类粒度不一致,一物多类、同名别名带来返工。
06
证据核验
为什么这家公司属于这个类别,往往没有可追溯依据。
07
找视觉资产
Logo版本、透明底、品牌归属要逐一处理。
08
重复更新
一个月后行业变化,传统做法通常只能重新做一遍。
《脸谱》真正想改造的,是那段最耗时、最容易错、做完又最难复用的研究过程。把它变成有记录、能复跑、可抽检的生产流水线,下一次就不用重新翻地。
成本换算口径(计算公式):一次研究人工成本 = 参与人数 × 平均投入工时 × 人时成本;返工成本 = 重复搜索/去重/核验/排版工时 × 人时成本;版本更新成本 = 单次重做工时 × 更新次数 × 人时成本。
本轮项目尚未采集足够的人工基线工时与人时成本,因此这里只给出计算口径,不虚构金额。后续用同一主题“人工完成一次 + FaceGraph 完成一次”形成成对样本,再给出真金白银的节省结果。
2.5 · USER & SCENARIO
受影响角色|同一句“帮我看这个行业”,不同岗位追问的重点不同
所以 Question-to-Map Compiler 得先听懂“谁要看、看了要干什么”,再决定分类结构、对象粒度和视觉模板。需求没听明白,后面搜得越勤快,越容易跑偏。
战略 / 投资
看行业结构、赛道拥挤度、关键玩家、技术变化与潜在空白。
需要:Industry / Evolution Map
采购 / CIO
看有哪些厂商、产品能力怎么分、谁有真实项目和风险标签。
需要:Vendor / Tool Landscape
技术架构
看技术栈、能力层级、产品边界以及技术路线之间的关系。
需要:Layered Stack / Relation Map
销售 / 市场
看竞争格局、目标客户、生态伙伴与不同区域的市场结构。
需要:Vendor / Ecosystem Map
园区 / 招商
看区域产业链、龙头、专精特新、科研、资本和上下游缺口。
需要:Region / Industry Map
三、核心方案
“君子生非异也,善假于物也。” —— 《荀子·劝学》
核心方案只围绕一条主线:MOSS 作为主平台负责商业事实检索与 Skill 运行,FaceGraph 把事实变成候选、实体、分类、证据和图谱,Review Gate 把低置信与冲突项拦在正式发布之前。FineBI / 简道云在本项目中定位为可选扩展承载层,不纳入本轮“已实测”口径。
3.0 · COMPETITION TEMPLATE LINK
作品模板链接
https://www.mossdo.com/share/aTxfbIeg6KlmJCWC
3.1 产品命题与工作边界
3.1.1 · PROJECT THESIS
《脸谱》聚焦“行业认知压缩”
“横看成岭侧成峰,远近高低各不同。” —— 苏轼《题西林壁》
行业研究有个老坑:站在一个角度看久了,就容易把山看成一堵墙。FaceGraph 要做的,是把企业、产业链、招采、知产和关系这些散落的“山头”拼回一张地形图,让人看见高低、远近和路怎么走。
企业手里的信息越来越多,可碰到一个陌生行业,大家还是经常先从搜索框发呆。搜索引擎给资料清单,传统BI给指标,《脸谱》继续往前收拾一层:谁是谁、谁在哪一类、谁和谁有关、这判断到底凭什么。最后留下的是行业结构,少一点资料堆。
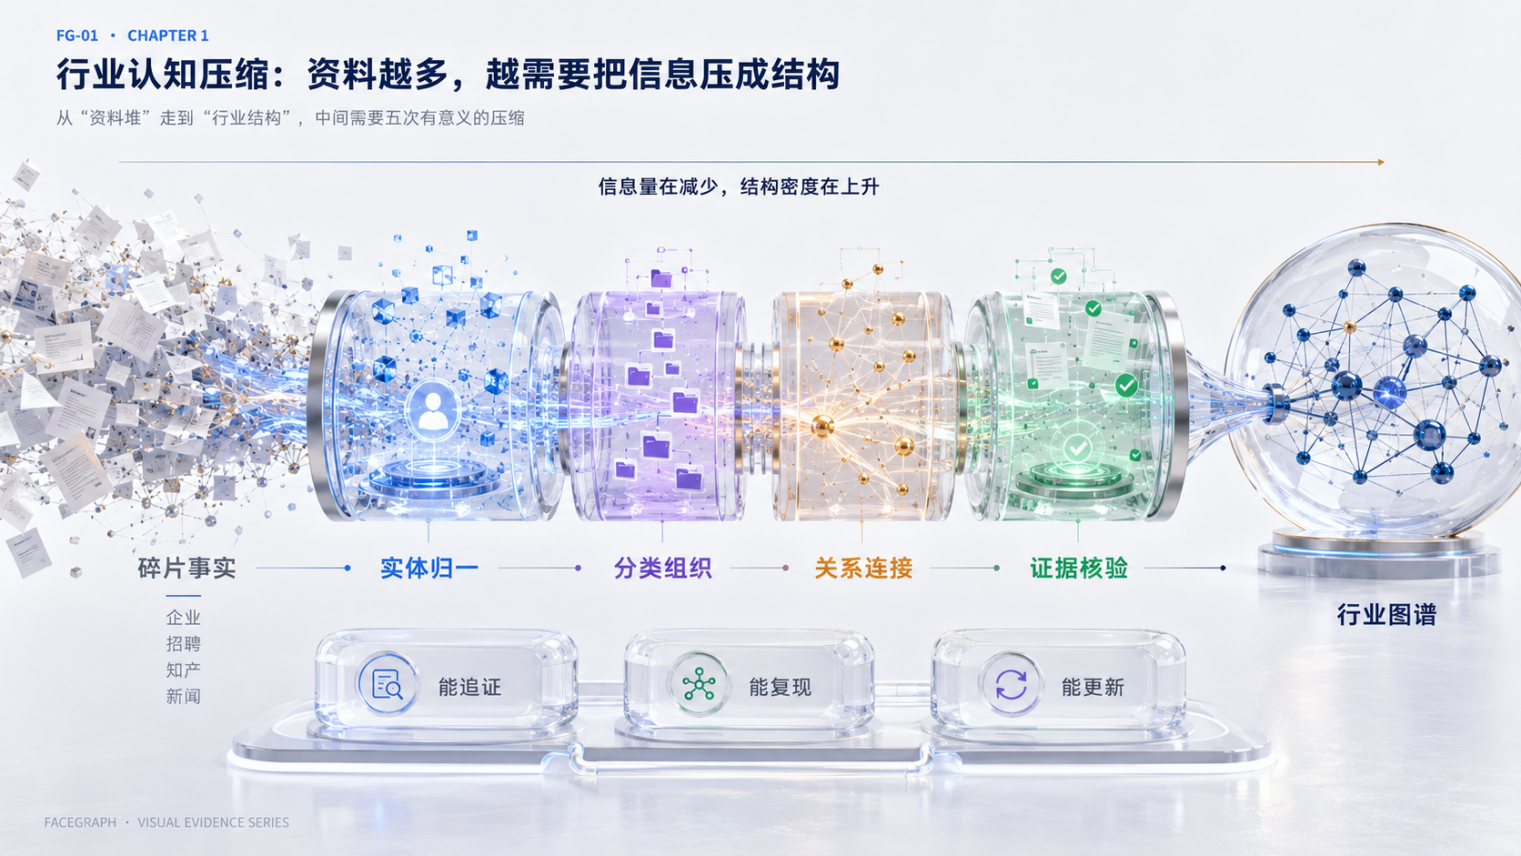
图解增强 01|行业认知压缩模型
数据口径:概念模型,根据本项目的数据对象与生成流程绘制。
一句话读图:FaceGraph 的价值是把碎片资料逐层压缩成能追证、能更新的行业结构。
搜资料,看见的是点;做分类,看见的是面;连关系,看见的是网;还能下钻、追证、更新,才算把这个行业的脸看完整。
项目聚焦一张可直接使用、可继续下钻、可持续更新的专业行业图。
AI Logo 墙里的每个对象都得有“户口”:实体归属、分类依据、证据和视觉资产来源,一个也别糊弄。
行业研究流水线把检索、辨认、分类、校验、设计、更新串成一条可重复运行的工作流。以前靠经验记步骤,现在让流程自己记。
每次运行同步沉淀 Taxonomy、Entity、Evidence、VisualAsset 和 Version,并输出可直接用于业务研判的 PNG。前端是一张图,底层是一套可复用、可追溯的数据资产。
3.1.2 · WHY FACEGRAPH
大模型一秒出图,《脸谱》为什么还要多走几步?
行业图最难的地方,往往还没轮到“画”:厂家从哪来、有没有遗漏、公司和品牌有没有混淆、分类是否处于同一维度、Logo 是否可靠、使用者能否随时追到证据。大模型直接出图适合快速形成草图;《脸谱》把研究底稿、判断过程和后续更新一起留下。图是最终表达,前面的事实治理和结构判断决定了它是否可信。
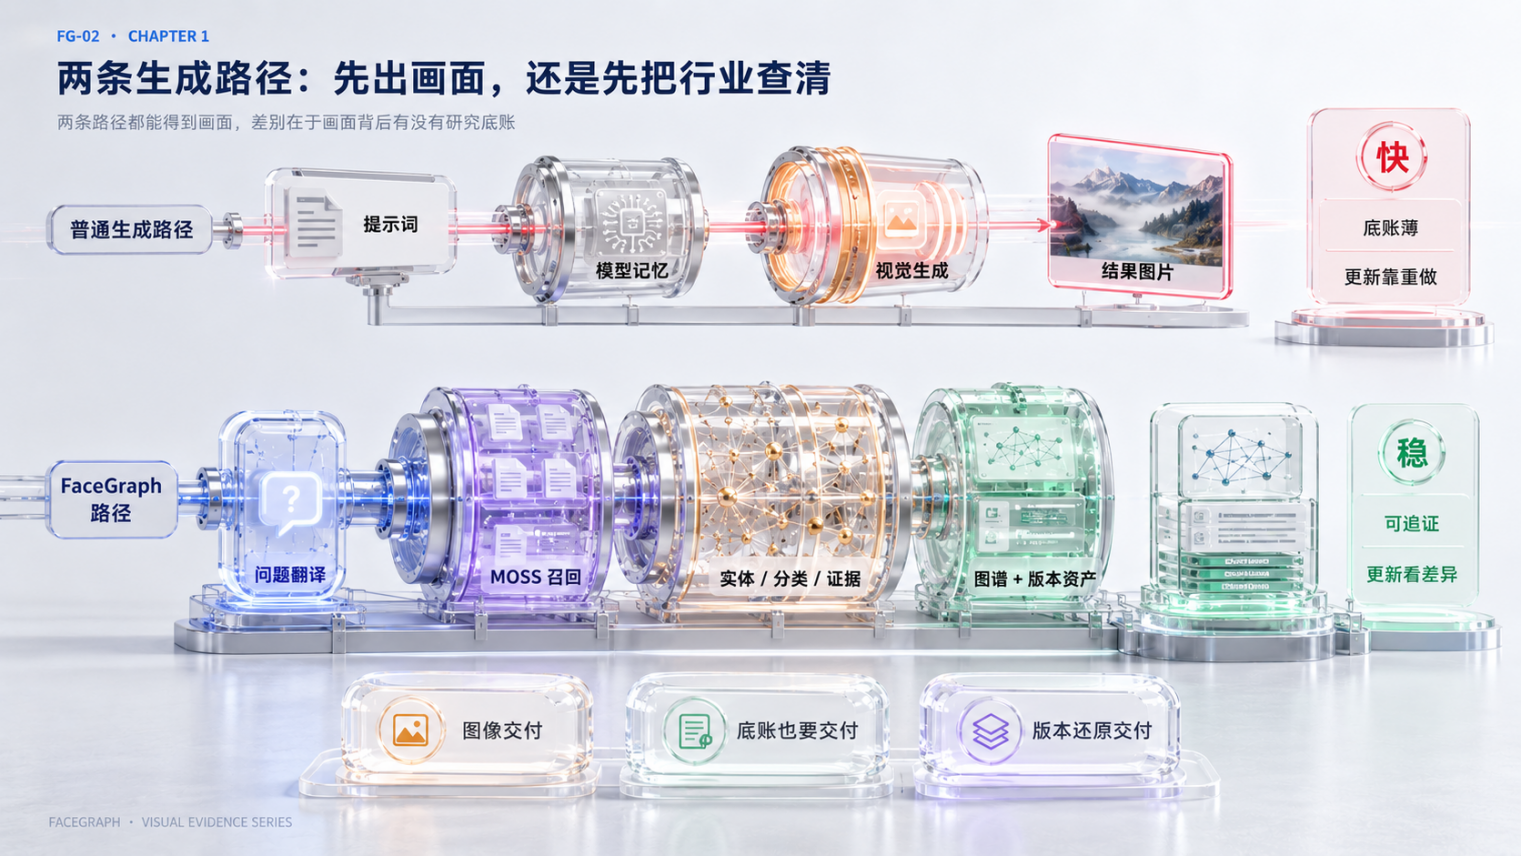
图解增强 02|普通大模型与 FaceGraph 的工作边界
数据口径:方法对比,不表示所有大模型产品均采用同一流程。
一句话读图:普通生成路径追求快速成图,FaceGraph 额外保留实体、分类、证据和版本底账。
大模型擅长先把画面端上来,《脸谱》先把行业查清楚,再让图自己长出来。
|
对比项
|
大模型直接出图
|
《脸谱》Skill + MOSS
|
|
出发点
|
一句 Prompt,直接生成视觉结果
|
一句问题先生成 MGO,明确受众、范围、对象层级、证据和视觉规则
|
|
厂家从哪来
|
模型记忆、公开常识、Prompt 中写到的对象
|
MOSS 企业、产业链、企业筛选、招采、知产、关系等多路召回
|
|
找得全不全
|
常见情况是“想到谁就画谁”
|
先建立 Candidate Universe,再决定谁进主图、谁去下钻、谁待复核
|
|
公司/品牌/产品
|
容易混在同一级
|
Entity Resolver 做标准实体、别名、集团、品牌和产品归属
|
|
分类怎么来
|
模型现场归纳几个类别
|
Taxonomy Builder 做规则先验、语义聚类、层级约束和质量门禁
|
|
为什么上图
|
图片本身通常看不出依据
|
每个关键对象都有 Inclusion Reason、Evidence Score 和 Evidence Ledger
|
|
Logo 怎么管
|
生成式图片可能出现变形、错标或版本混用
|
Logo Ledger 单独记录品牌归属、来源、版本和更新时间
|
|
用户点选对象
|
看到的是一张静态图
|
继续下钻:行业 → 类别 → 厂商 → 产品 → 证据
|
|
下个月再跑
|
通常重新生成一张,新旧逻辑可能变化
|
沿用同一 MGO 和 Taxonomy,形成可比较的新版本
|
|
行业发生什么
|
需要人工重新比两张图
|
Version Diff 自动识别新增、退出、换类、证据更新和趋势信号
|
|
最后拿到什么
|
主要是一张图片
|
总图谱 + 下钻图谱 + Evidence Ledger + Version Diff + 数据底稿
|
3.2 帆软产品融合边界|MOSS 是主平台,其他产品不抢功
当前已实现|MOSS 承担商业事实检索、Skill 安装/运行、候选召回与真实 Run 记录;FaceGraph 在 MOSS 之上组织实体、分类、证据、视觉与版本资产。这部分属于本轮已实测主链。
可选扩展|FineBI 可消费 Entity / Taxonomy / Evidence / Version 等结构化输出,持续观察覆盖率、证据覆盖、分类修订率与版本变化;简道云可承接 Review Queue、责任人、复核状态和发布审批。两者目前未纳入本轮实测,因此不写成“已实现”。
融合原则|先把 MOSS + FaceGraph 的行业研究主链跑通,再把结构化资产接到 BI 与流程闭环;不为了“产品多”而拼装工具。
3.3 MOSS 核心引擎与生成闭环
核心闭环:Question → MGO → MOSS 事实召回 → Candidate Universe → Entity / Taxonomy → Evidence Gate → Visual Compose → Human Review → Version Diff。现有“七步生成链 + 六道 Gate”图作为本章总览图,负责把复杂机制一次收拢。
3.3.1 MOSS 核心引擎|先把研究链跑通
FaceGraph 的发动机还是 MOSS Skill。当前已经把 ZT-01 → ZT-06 真跑通:需求编译、多路召回、实体归一、语义分类、证据审计、HTML 可视化。第一次做运维工具图谱,用时 2分50秒,落下 8 个赛道、48+代表厂商和 19 个信息来源。先不谈想象力,至少这条链已经点着火了。
• ZT-01|先把一句“运维工具图谱”翻译成 Tool Landscape、市场范围、实体层级和视觉模板,别一上来就瞎搜。
• ZT-02|产业链、企业画像、知产、招采、Web补充多路一起找,先把候选池做厚,再谈精选。
• ZT-03|专门处理嘉为科技 / 嘉为蓝鲸 / Canway 这种“一个人好几个名字、一个名字好几层身份”的麻烦。
• ZT-04|把 48+ 对象收进 AIOps、可观测、ITSM、DevOps、APM、IDC运维、安全运维、CMP 八个赛道,大家各坐各的桌。
• ZT-05|上图前先算 Evidence Score,分数心里没底的对象先去 Review,不急着抢镜。
• ZT-06|最后把结构化结果排成 WHITE_LANDSCAPE 行业图谱,让研究底稿真正变成能看的图。
• ZT-07|第二次同主题运行后启用,用于行业变化对比。
3.3.2 FaceGraph 生成链|七步把一句问题压成一张行业脸谱
一句话读图:图谱不是一次生成完成,而是在连续判断和质量门控制下逐步长出来。
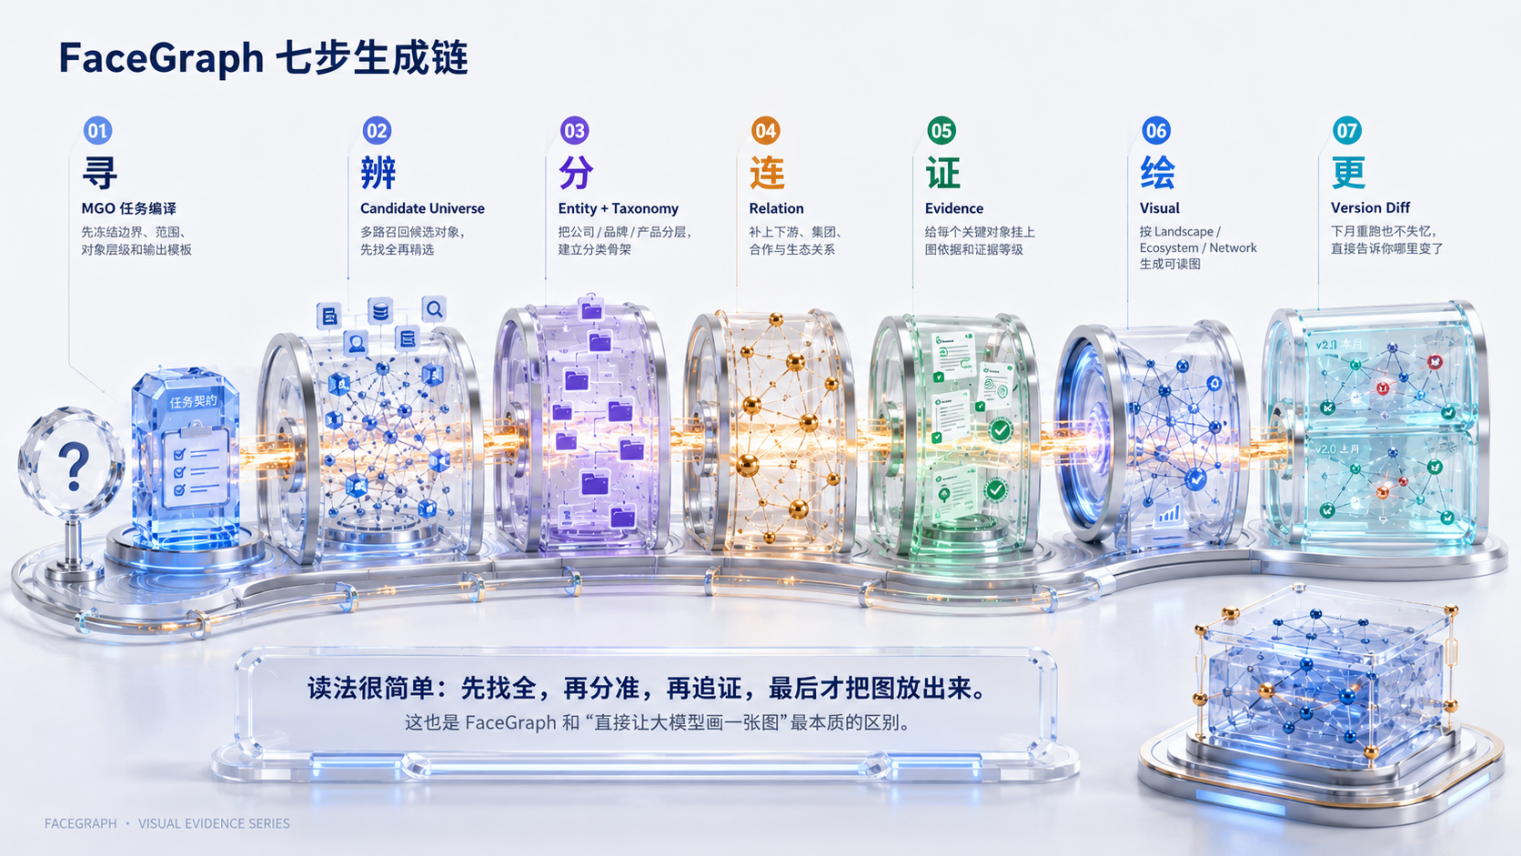
图3 FaceGraph 七步生成链:寻 → 辨 → 分 → 连 → 证 → 绘 → 更
FaceGraph 不把“生成图谱”当成一个大按钮。它拆成七个可检查的小动作:寻、辨、分、连、证、绘、更。每一步都留下中间结果,哪一步翻车,就在哪一步修,别等图画完了再集体返工。
3.3.2.1 MGO 任务编译|先把老板那句话翻译成机器能干的活
输入一句自然语言,先冻结受众、市场范围、对象层级、分类深度、证据门槛和视觉模板。MGO 就像这次研究的“任务身份证”:后面所有 Skill 都按它办事,谁也别临场加戏。
3.3.2.2 Candidate Universe|先把全班点名,再谈谁坐主席台
MOSS 从企业、产业链、画像筛选、招采、知产、关系等多个通道召回候选。候选集负责“尽量别漏”,主图负责“别太挤”。没上主图的对象仍然留在底稿里,长尾不用被排版一脚踢出行业。
3.3.2.3 Entity + Taxonomy|公司、品牌、产品先各坐各的座位
Entity Resolver 处理别名、集团、品牌和产品归属;Taxonomy Builder 再按同层粒度、业务规则和语义相似度搭分类树。拿不准就多标签或 NEED_REVIEW,坚决不让模型把犹豫说成事实。
3.3.2.4 Evidence + Visual|证据先过门,Logo 再上墙
关键对象先算 Evidence Score,再进入视觉编排。来源不够、主体不清、Logo 来路不明,都有明确降级路径:进候选、用文字卡、送人工复核。图可以好看,底账不能靠气氛。
3.3.2.5 Version Diff|下个月再跑,不从失忆开始
同一 MGO 重跑时比较新增、退出、改名、换类、证据变化和风险信号。研究成果从“一张图”变成“一个有版本的行业资产”,这才是长期价值真正开始冒头的地方。
3.3.3 可信交付与人工复核|机器跑流程,人守灰区
自动化负责高频、重复、确定性强的部分;人只处理低置信、冲突和高影响节点。项目把“人工介入”设计成一道质量门,不设计成“最后还是全靠人”。
3.3.3.1 六道 Gate|主体、分类、证据、Logo、去重、发布逐关检查
ENTITY_GATE、CATEGORY_GATE、EVIDENCE_GATE、LOGO_GATE、DUPLICATE_GATE、HUMAN_GATE 六道门把错误尽量挡在正式输出之前。过不了就降级或复核,别硬凑一张“看起来什么都有”的图。
3.3.3.2 Human-in-the-loop|专家只审最值钱的 20%
Review Queue 只收实体冲突、分类争议、证据不足、Top 对象和重大版本变化。人工修订理由继续反哺别名表、分类规则和阈值,让下一次少问人一句。
3.3.3.3 标准交付|台前是一张图,后台是一套能复跑的账
每次 Run 至少留下主图或交互图、Entity Table、Taxonomy、Evidence Ledger、Logo Ledger、Review Queue、MGO Snapshot 和 Version Diff。当前任务形成可用成果,同时为下一次运行保留可继续使用的数据与规则资产。
3.4 产品体验、数字角色与标准交付
3.4.1 · ONE PERSON, ONE RESEARCH TEAM
一个人带着六位“数字同事”:行业研究小组就位
真正的行业研究,很少只是“搜一下”。它同时需要检索员、行业分析师、分类架构师、证据审计员、视觉设计师和情报管理员。《脸谱》把这些角色拆进不同 Skill,一个业务人员也能把原本多人接力的流程跑下来。像一个人进会议室,背后跟着六个数字同事。
01|市场侦察员
负责建立 Candidate Universe。头部厂商当然要找,产业链、招采、知产、相似企业里的长尾也得捞出来,免得图上永远只有那几个熟脸。
产出:候选全集 / Query Log
02|实体校准员
负责认清公司、集团、品牌、产品、别名和归属。名字多不怕,怕的是把一家人认成四家,或者把四家硬凑成一家。
产出:Canonical Entity Set
03|行业架构师
根据用户任务动态设计 Taxonomy,管住同层粒度、完整性和多标签。行业换了,分类也跟着长;不拿一副旧抽屉硬塞所有东西。
产出:Category Tree
04|证据审计员
逐个检查:为什么纳入、为什么属于这类、证据新不新、Logo 来源稳不稳。它的工作有点像检票员——没票的先别往主图里挤。
产出:Evidence / Logo Ledger
05|信息设计师
根据问题选择 Landscape、Ecosystem、Network、Timeline 等图形语法。设计的任务是让人更快读懂,装饰排在后面。
产出:PNG / PPT / HTML
06|情报管理员
保存 MGO 快照,按周期重跑,盯新增、退出、换类、品牌升级和证据过期。图谱从一次性交差,慢慢变成会自己长记性的情报产品。
产出:Version Diff
3.4.2 · USER STORY
老板一句话,后台跑一串:还原真实行业研究现场
项目从一个典型工作任务进入:战略经理临时收到行业研究需求,以往需要跨部门找资料、反复核对主体并手工排版;使用《脸谱》后,系统承担资料召回、实体归一、分类、证据整理和视觉编排,人员主要确认研究边界与争议项。流程没有跳步,只是把重复劳动交给了可复跑的工作流。
14:05
CEO 临时问:
“下周要谈云资源管理合作。国内现在到底有哪些玩家?给我一张能讲清楚、还能经得起问的图。”
传统模式下,战略经理先问同事、搜网站、抄名单、认品牌、找Logo、做PPT。第二天图是出来了,老板也很配合地追问一句:“为什么这家公司在这里?”然后大家开始翻聊天记录。
14:06一句话进入 MGO
确定受众=CIO、范围=中国市场、图型=Vendor Landscape、输出=16:9。先把四个边界钉住,后面少走弯路。
14:10候选全集形成
从多路数据召回厂商、品牌、产品,记录来源和被召回原因。
14:18分类与实体对齐
自动形成10—12类,完成公司/品牌/产品去重;拿不准的对象不硬判,统一进Review。
14:25证据与Logo审计
主图对象必须通过证据门禁;视觉资产单独保存来源。
14:35第一版图谱生成
主图看全貌,点击任一对象可继续下钻到事实和证据。
下月同一 MGO 自动重跑
系统告诉你哪些厂商新增、哪些换类、哪些品牌或证据发生变化。
3.4.3 · TASK CONTRACT
Skill 也要有岗位说明书:输入什么、干什么、交什么
稳定的 MOSS 项目不能只看 Agent 输出了什么,还要确认它每次是否按同一套专业方法运行。因此,每次运行都生成 Run Manifest,记录输入、处理状态、质量门和输出清单,让过程可复核、结果可复现。
{ } INPUT CONTRACT
任务输入
question: 云资源管理工具图谱
audience: CIO / 云平台负责人
market_scope: 中国市场为主
time_scope: 当前有效
entity_level: Brand / Product
category_depth: 10-12
style: white_16_9
need_logo: true
need_evidence: true
RUN CONTRACT
运行过程
1. compile_question
2. discover_universe
3. resolve_entities
4. build_taxonomy
5. extract_relations
6. verify_evidence
7. audit_visual_assets
8. compose_map
9. human_review
10. save_snapshot
OUTPUT CONTRACT
标准交付
map.png
map.pptx / map.html
entity_table.csv
taxonomy.json
evidence_ledger.csv
logo_ledger.csv
review_queue.csv
mgo_snapshot.json
version_diff.json
3.4.4 · PRODUCT EXPERIENCE
六类图谱 + 六页体验|同一套研究底账,换不同的“脸”
视觉语法先服从业务问题。工具/厂商类优先清爽的 Logo Landscape;产业生态用中心 + 角色分区;只有遇到股权、供应、合作、风险传导这类“关系本身就是问题”的场景,才请关系网络上场。
TOOL
工具图谱
回答:这个能力域有哪些工具?
- 分类框 + Logo矩阵
- 适合运维、数据、AI工具
- 强调分类与覆盖
VENDOR
厂商图谱
回答:市场有哪些厂商阵营?
- 类别 + 厂商Logo + 标签
- 可加入地区、规模、风险
- 采购/竞争分析友好
ECOSYSTEM
产业生态图
回答:产业由哪些角色组成?
- 中心主题 + 生态环
- 上游/制造/渠道/客户/政策
- 适合产业全景
RELATION
关系图
回答:谁与谁有关?
- 节点 + 关系边 + 证据弹窗
- 股权 / 招采 / 合作 / 风险
- 关系必须有证据
REGION
区域产业图
回答:区域有哪些产业集群?
- 区域 + 赛道 + 企业簇
- 园区招商 / 区域比较
- 支持产业链缺口
TIMELINE
演化图
回答:市场结构如何变化?
- 时间切片 + 新增/退出/迁移
- 季度/年度行业更新
- 从行业照片变行业电影
01|我要一张什么图 Question
02|MOSS 正在找市场 Universe
03|AI 正在分类 Taxonomy
04|图谱生成 Compose
05|为什么在这里 Evidence
06|版本与洞察 Update
6-PAGE PRODUCT DEMO
我要一张什么图
用户先用一句自然语言说需求,再补市场范围、受众、风格和输出格式。系统第一步生成 MGO Blueprint,把边界钉住;搜索稍后再开工,免得一上来就满世界捞东西。
下钻体验|从一张行业脸,点到每一家厂商的证据底账
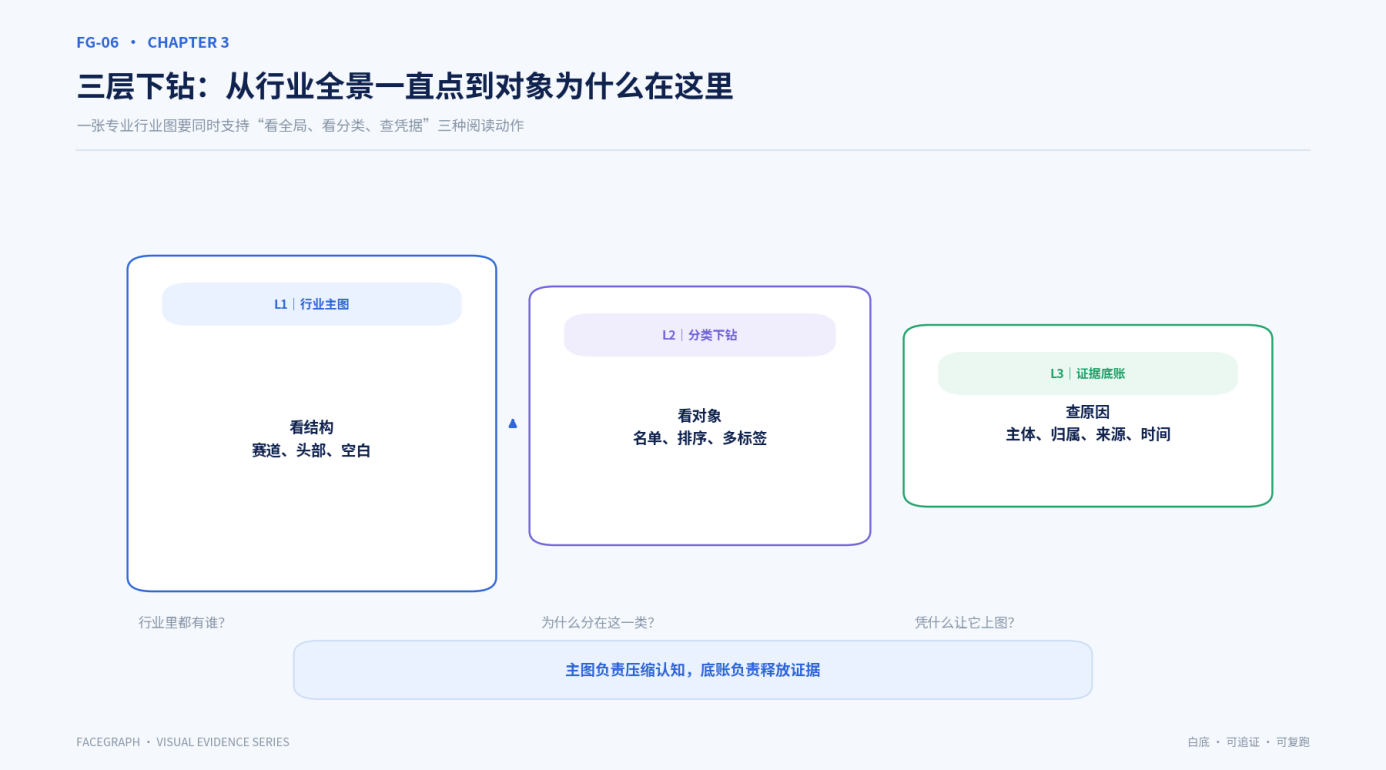
图解增强 06|从主图到证据底账的三层下钻
数据口径:产品信息架构示意。
一句话读图:主图负责看结构,下钻负责回答主体、分类和证据三类追问。
主图负责“一眼看懂”,交互层负责“继续刨根”。长尾对象、复杂证据都放到下钻里。点一个节点试试:行业 → 类别 → 企业/产品 → 证据,顺着走就能看到底。
下钻层级:行业 → 一级类别 → 二级类别 → 企业 → 品牌 → 产品 → 证据 / Logo 来源 / 更新时间。
3.5 数据底座与可信机制
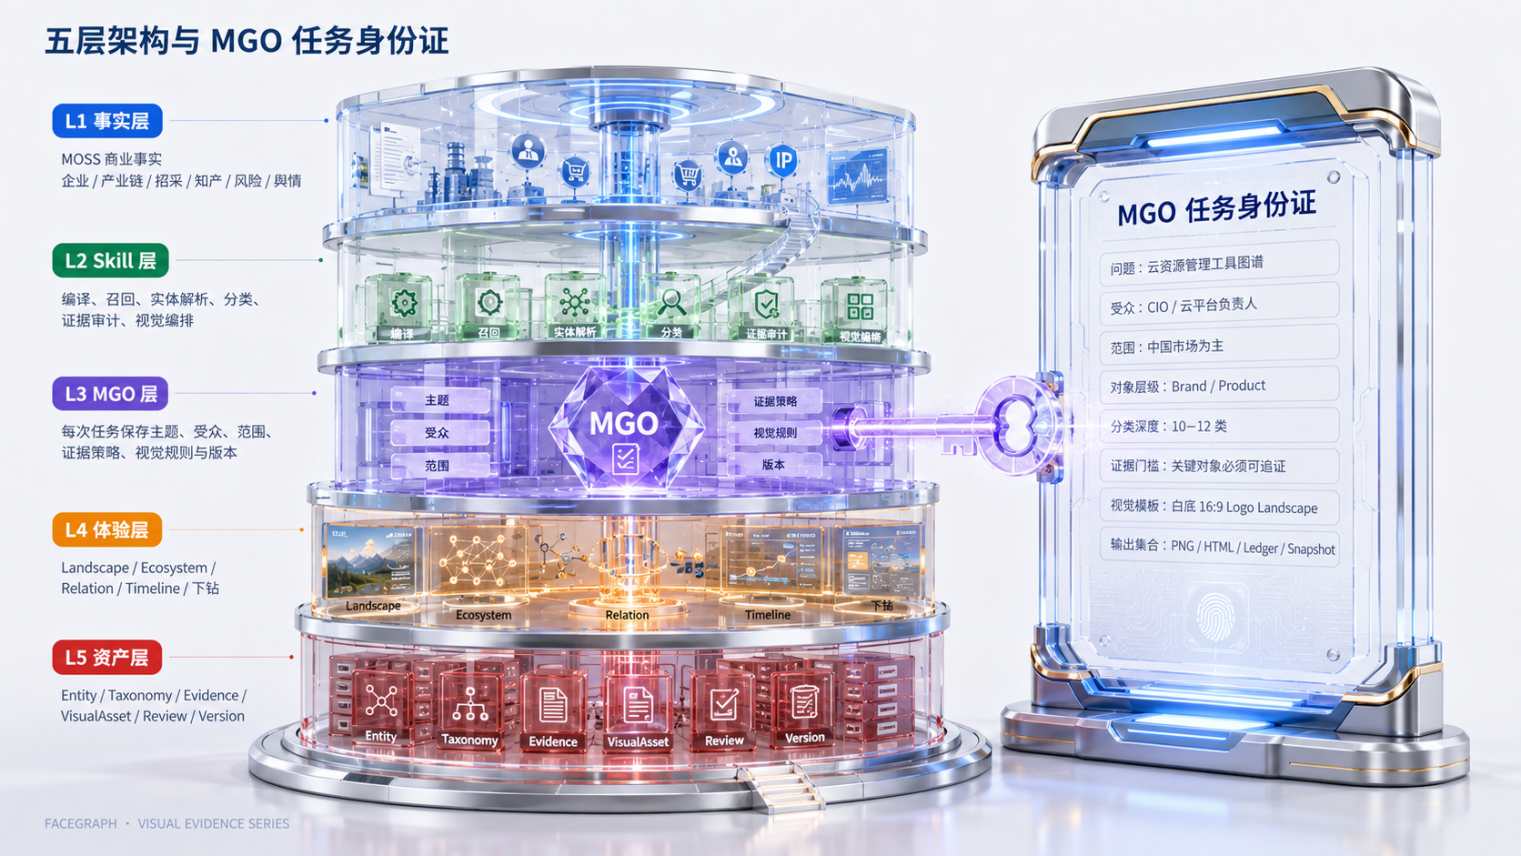
图4 五层架构与 MGO 任务身份证
3.5.1 · SOLUTION ARCHITECTURE
五层架构|谁找事实、谁做判断、谁记住版本、谁把图排明白
项目把“商业事实”“模型推断”“视觉资产”三层分开存。这样图再好看,Logo 来源、模型分类和推断关系也不会混进 MOSS 事实里冒充亲戚。哪一层说的话,就盖哪一层的章。
05
L1 · FACT
MOSS 事实层
企业、产业、招采、知产、财务、风险、关系、政策、舆情等商业事实。
- 事实优先从MOSS获取
- 保留查询日志和时间
- 不足时显示缺口
L2 · SKILL
Skill 处理层
问题编译、候选召回、实体解析、分类、关系、证据审计、视觉编排。
- 少而清晰的职责
- 共享Schema
- 冲突进入Review
L3 · MGO
生成对象层
保存主题、受众、范围、分类、实体集、证据策略、视觉规则与版本。
L4 · EXPERIENCE
图谱体验层
工具Landscape、产业生态、关系图、区域图、时间演化和下钻详情——用户看到的是这些可读的图谱体验。
L5 · ASSET
资产与版本层
Evidence Ledger、Logo Ledger、Taxonomy Template、MapVersion 与 Diff——真正能留下来继续复用的资产,主要在这里。
- PNG/PPT/HTML输出
- 30/60天重跑
- 形成行业资产
3.5.2 · DATA ASSETS
八类数字资产|图会过期,底账可以继续长
这一部分决定《脸谱》能否在企业中持续运行。每次图谱任务都把隐性的研究经验转成结构化资产,后续既能跨主题复用,也能接入 FaceGraph Ops 管理任务、证据、复核与版本状态。
01 · MGO
图谱任务资产
保存问题、受众、范围、策略、模板和版本。
mgo_id / scope / template / snapshot
02 · ENTITY
实体主数据
企业、集团、品牌、产品的标准名称和别名。
entity_id / canonical_name / aliases
03 · TAXONOMY
行业分类资产
一级/二级类别、标签和分类规则。
category_id / parent / rule / version
04 · RELATION
关系资产
归属、上下游、合作、客户、技术、竞争等关系。
source / relation_type / target
05 · EVIDENCE
证据账本
事实摘要、来源、时间、置信度和纳入理由。
evidence_id / source / time / score
06 · VISUAL
品牌视觉资产
Logo、版本、品牌归属、来源和使用状态。
asset_id / brand_owner / source / version
07 · REVIEW
人工复核资产
争议对象、处理意见、责任人和复核结果。
issue / reason / reviewer / status
08 · VERSION
行业版本资产
新增、删除、迁移、改名、证据变化和趋势信号。
old / new / diff_type / changed_at
3.5.3 · MOSS DATA LINEAGE
《脸谱》到底基于 MOSS 的什么数据?把每一条数据血缘写清楚
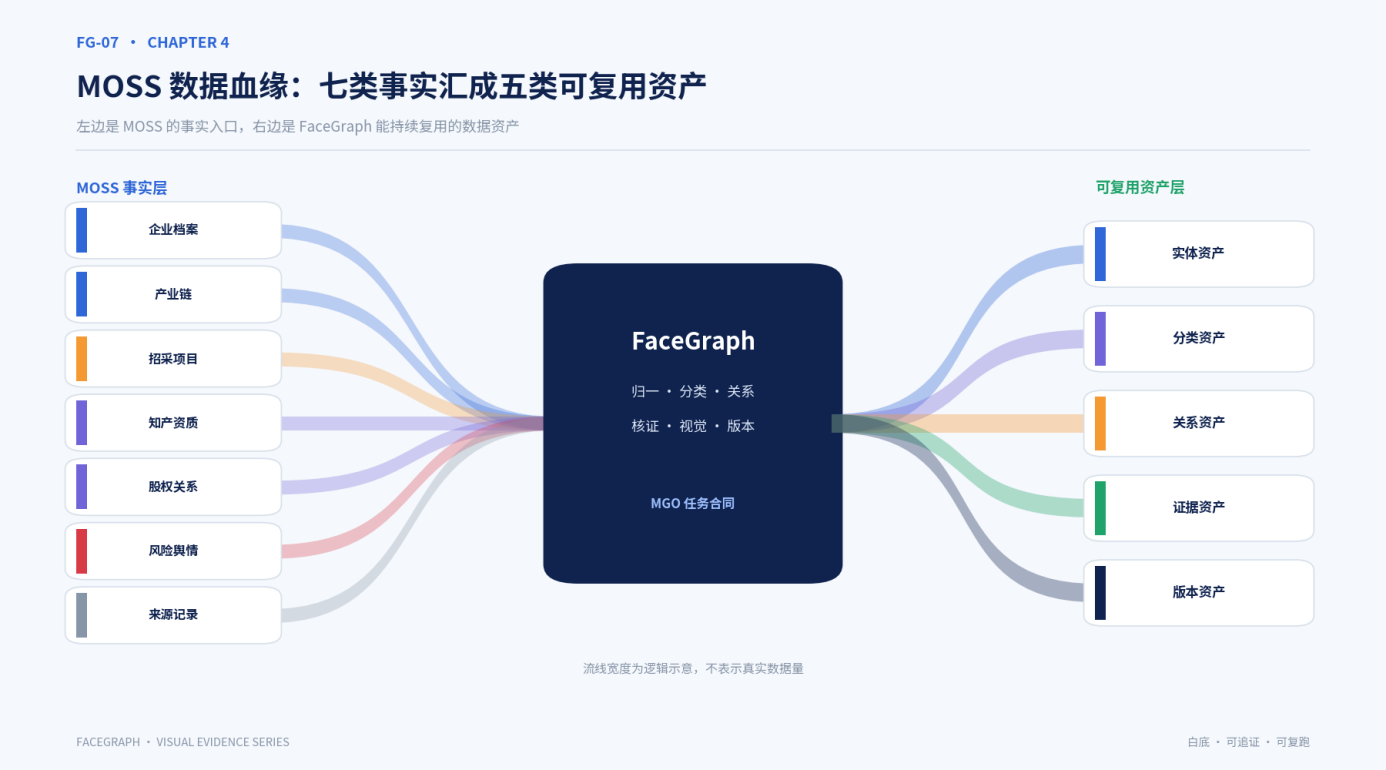
图解增强 07|MOSS 数据血缘河流图
数据口径:数据类型来自原稿的数据血缘清单,流线宽度只表达逻辑汇聚,不代表真实数据量。
一句话读图:MOSS 提供事实河流,FaceGraph 把它们沉淀成实体、分类、关系、证据和版本资产。
《脸谱》先用 MOSS 事实数据建立候选厂商全集。企业、产业链、关系、知识产权、招投标、财务规模、风险司法、舆情政策等数据域提供事实;Skill 再完成召回、实体解析、分类、证据评分、排版和版本更新。实际可使用的数据字段以 MOSS 接口返回为准,缺失字段进入能力检查与降级流程,不把推测写成事实。
MOSS-01
企业身份与基础档案
用于确认“主体是谁”:企业全称、地区、成立时间、经营范围、集团/分支先对齐,后面分类和证据才有地方落脚。
主要支撑Entity Resolver / Candidate Universe
典型用途:主体确认、企业去重、地区过滤、行业经营范围辅助判断。
MOSS-02
产业链图谱 / 产业节点
用于理解行业由哪些上下游环节构成,并发现各产业节点中的代表企业。
主要支撑Taxonomy Builder / Universe Discovery
典型用途:构建分类先验、上下游角色、细分赛道和候选企业。
MOSS-03
企业画像 / 筛选 / 商机类数据
按行业、地区、规模、科技属性等条件批量筛选企业,形成候选对象全集。
主要支撑Multi-channel Recall
典型用途:覆盖中腰部企业、区域厂商、专精特新和技术型长尾。
MOSS-04
股权 / 集团 / 关系穿透
用于识别母子公司、实控、投资关系和集团层级,主要任务是别把集团、子公司、品牌一股脑数成三四家。先把家谱理顺,后面的统计才不串辈。
主要支撑Entity Resolver / Relation Graph
典型用途:集团去重、主体归并、品牌所有者背景核验。
MOSS-05
知识产权 / 专利 / 软件著作权 / 资质
用于验证企业是否真的拥有某种技术或软件能力,而同时依据官网宣传文案。
主要支撑Evidence Scoring / Tech Relevance
典型用途:技术能力佐证、技术型长尾发现、能力标签和赛道归类。
MOSS-06
招投标 / 中标 / 采购项目
用真实采购和项目交付来验厂商的“落地成色”。宣传页谁都会写,招采和项目记录更接近真刀真枪,是判断有没有真实业务的重要事实。
主要支撑Candidate Ranking / Evidence Score
典型用途:代表性判断、真实应用证明、客户场景和项目活跃度。
MOSS-07
财务 / 规模 / 经营状态
用于辅助判断代表性、企业规模和市场成熟度。网络热度可以参考,但别把“最近很红”直接翻译成“市场很强”;规模、项目和业务事实得一起看。
主要支撑Representativeness Score
典型用途:头部/中腰部/长尾分层、上市/非上市对照、规模辅助排序。
MOSS-08
风险 / 司法 / 经营异常
在供应商、合作、采购、投资类图谱里叠加风险标签,用来观察经营异常和版本变化。风险是提醒灯,不是一票否决按钮。
主要支撑Risk Tag / Version Diff
典型用途:异常、诉讼、执行、失信等状态变化提醒;只做风险提示,不直接下否决结论。
MOSS-09
舆情 / 新闻 / 政策 / 市场情报
捕捉新品发布、品牌更名、技术热点、政策变化、市场进入退出等动态信号。
主要支撑Update / Timeline / Novelty
典型用途:新玩家、新产品、新技术类别、政策驱动变化和版本Diff。
MOSS-10
人物 / 机构 / 关联主体
图谱如果继续扩到创始人、专家、科研机构、投资机构或生态伙伴,人物和机构就作为二级节点接进来。行业不只由公司组成,背后还有一张“谁和谁有关系”的人网。
主要支撑Relation Map / Ecosystem Map
典型用途:产业生态、专家网络、科研合作和资本关系。
MOSS-11
行业 / 企业关系图谱能力
快速查看企业与产业节点、股权、关联公司等关系结构,为关系图和生态图打地基。关系没理清,生态图很容易画成一团毛线。
主要支撑Graph Relation / Community
典型用途:上下游、生态阵营、集团关系、合作网络等关系边。
MOSS-12
来源溯源 / 查询记录
每条事实都要留下“从哪来”的脚印:MOSS 数据域、查询时间、对象ID、原始事实摘要一起记进 Evidence Ledger。以后追问时,别靠记忆指路。
主要支撑Evidence Ledger / Audit
3.5.4 · EVIDENCE MATURITY
Evidence Score|上图之前先查“证件”
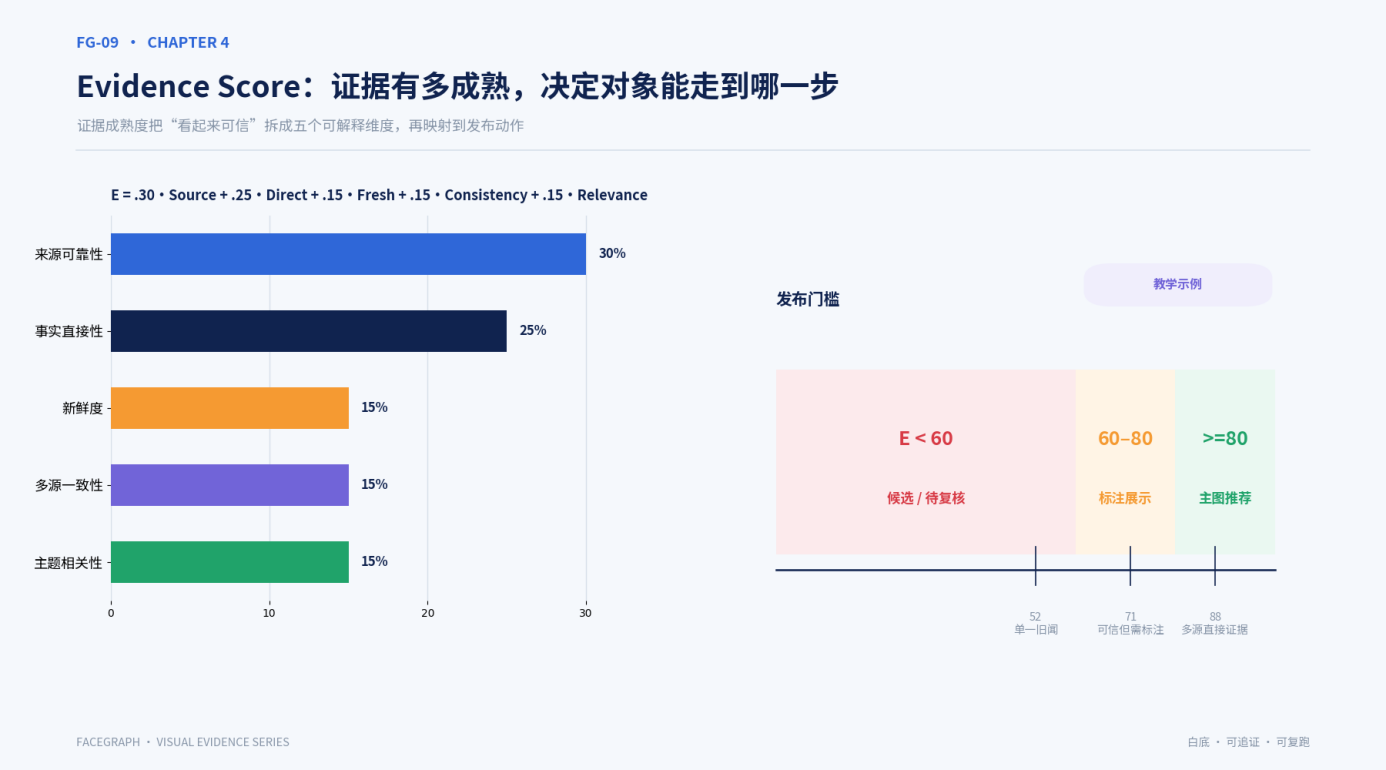
图解增强 09|证据成熟度的组成与发布门槛
数据口径:权重与阈值直接取自原稿公式;示例分数用于解释流程。
一句话读图:来源可靠、事实直接只是起点,证据还要经得住时间和多源一致性检查。
主图最怕“语气很确定,证据很心虚”。《脸谱》把证据质量拆成来源可靠性、事实直接性、时间新鲜度、多源一致性和业务相关度,合成 Evidence Score。分数负责质量门禁,专家仍然保留最后判断。
Evidence Score|示例
示例权重:来源可靠性30% + 事实直接性25% + 新鲜度15% + 多源一致性15% + 业务相关度15%。这只是初始尺子,正式项目还得拿真实样本校准,别把第一版权重当祖训。
E ≥ 80:主图推荐
60 ≤ E < 80:可展示但标注
E < 60:候选/待复核
E0|模型推测仅有LLM描述,无可核验事实;禁止作为正式上图依据。
E1|单一公开信号官网、新闻或单条公开材料,适合进入候选集。
E2|结构化事实企业、产业链、招采、知产等结构化事实支持。
E3|多源交叉至少两类独立事实相互支持,分类和代表性更稳健。
E4|业务确认专家或业务人员抽检确认,适合正式发布与业务使用。
E5|运行验证后续真实采购、项目、客户或运营结果继续反哺图谱。
3.6 Skill 架构与算法实现
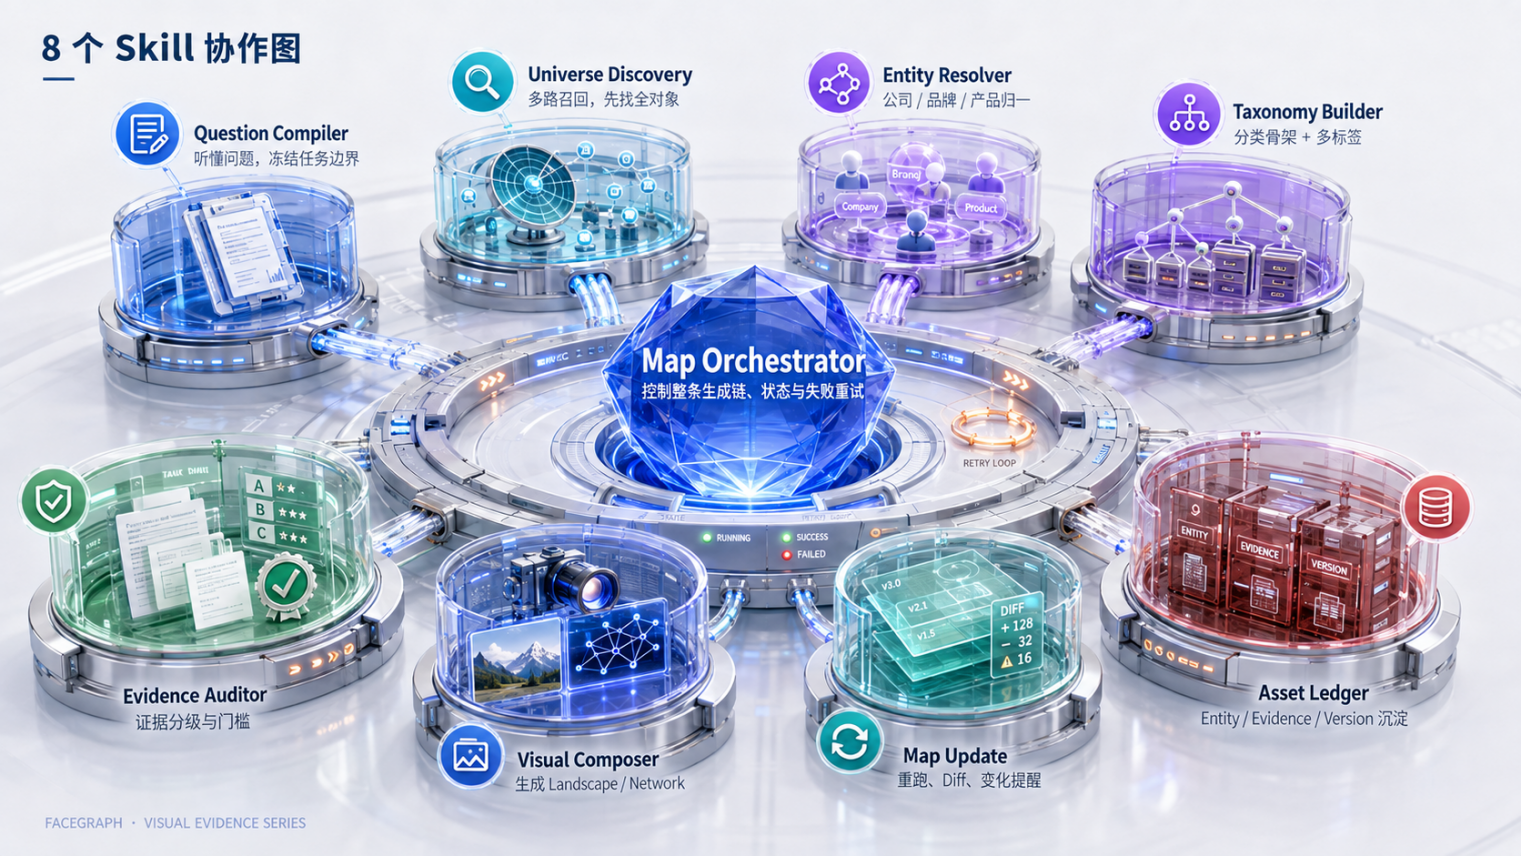
图5 8 个 Skill 协作关系图
3.6.1 · SKILL DESIGN
八个 Skill|八个人各管一摊,少开跨部门大会
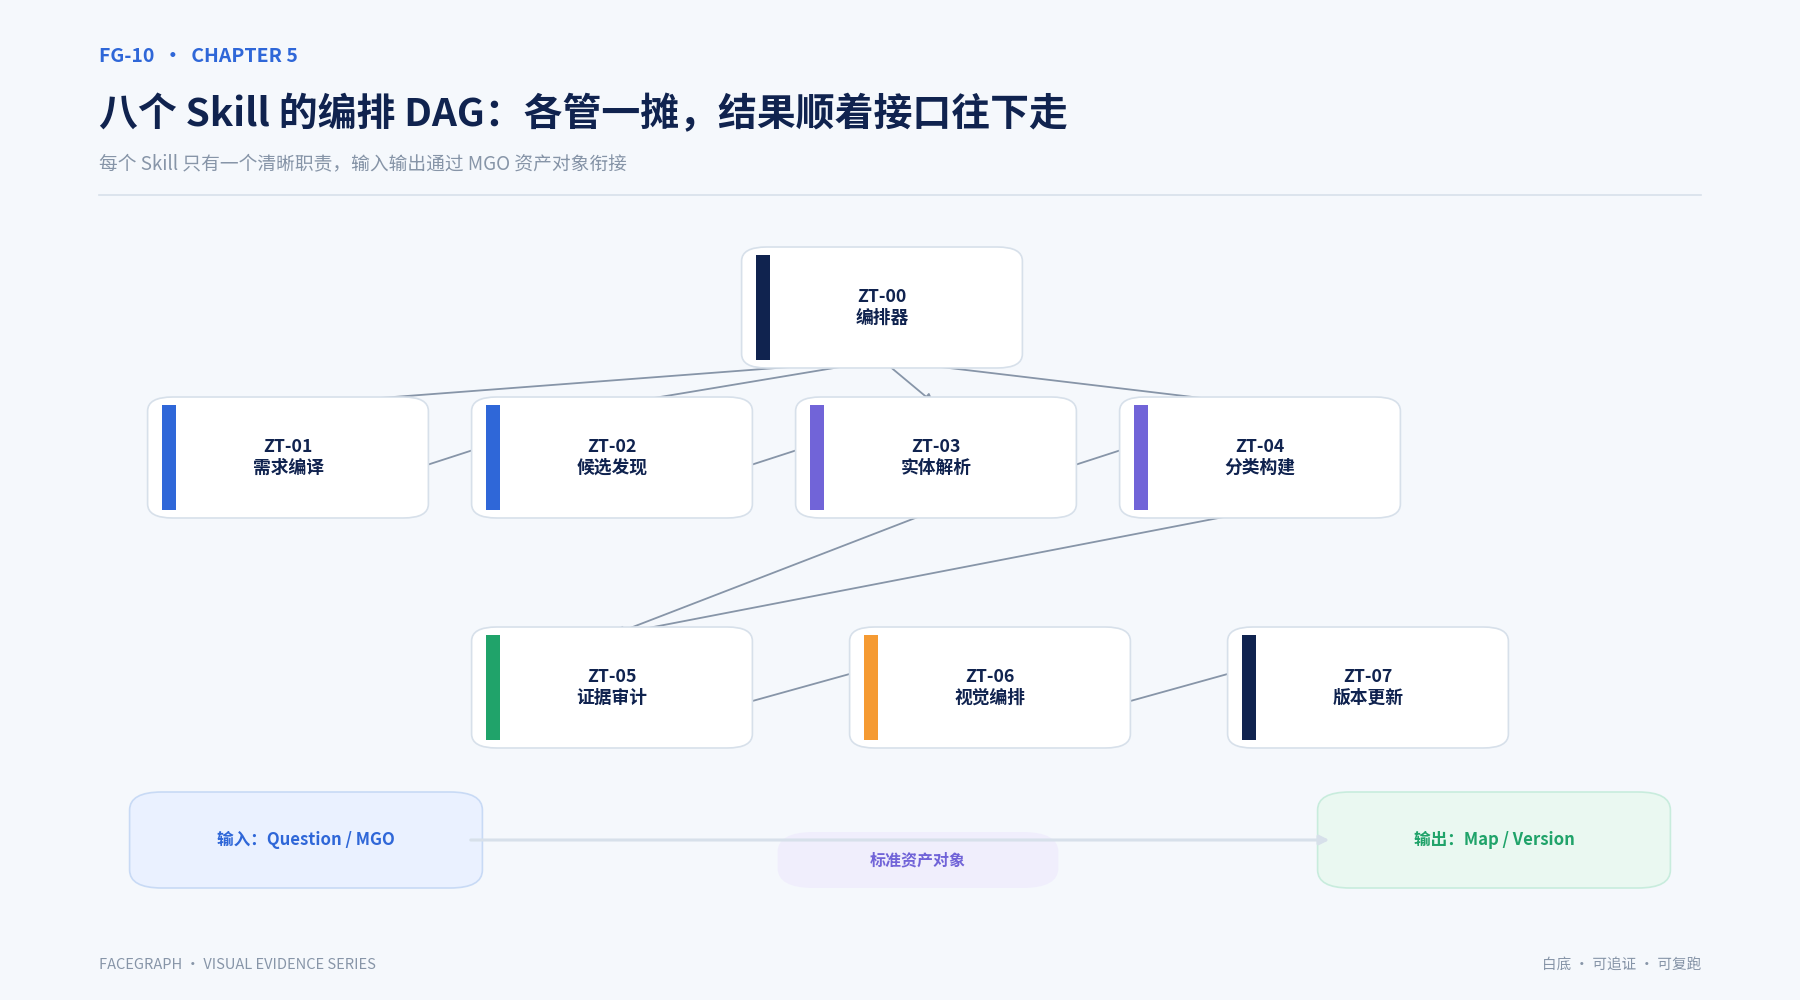
图解增强 10|八个 Skill 的编排关系
数据口径:根据 ZT-00 至 ZT-07 的职责、输入与输出绘制。
一句话读图:编排器管状态,其余 Skill 通过标准对象传递结果,人工复核只接住灰区。
使用者不需要记住 Skill 编号,但项目必须明确每一层的输入、输出和边界。MGO、Entity、Brand、Product、Category、Evidence、VisualAsset、MapVersion 共用一套 Schema;各 Skill 只加工职责范围内的数据,不能越权修改来源事实。
ZT-00
Map Orchestrator
map-orchestrator
控制整条生成链、状态和失败重试。
输入
用户问题 / 上下文 / 模板偏好
输出
Run Manifest / MGO / Skill调用顺序
边界
只编排,不擅自创造事实
ZT-01
Question-to-Map Compiler
topic-map-compiler
把自然语言需求编译成图谱蓝图。
输入
Question + Template Library
输出
Purpose / Scope / Audience / Taxonomy Plan
边界
不负责外部事实查询
ZT-02
MOSS Universe Discovery
entity-finder
多路召回候选企业、品牌、产品和技术对象。
输入
Blueprint / MOSS Sensors
输出
Candidate Entities / Query Log
边界
候选对象需要经过正式上图审核
ZT-03
Entity Resolver
entity-resolver
公司、品牌、产品、集团、别名映射。
输入
Candidate Universe
输出
Canonical Entity Set / Alias Map
边界
不猜品牌归属
ZT-04
Taxonomy Builder
taxonomy-builder
生成同层分类树并支持多标签。
输入
主题 + 实体集 + 受众
输出
Category Tree / Multi-label
边界
冲突进入Review
ZT-05
Evidence & Asset Auditor
evidence-verifier
检查上图理由和视觉资产来源。
输入
分类实体 + Evidence + Logo
输出
Evidence Ledger / Logo Ledger
边界
Logo来源单独记录
ZT-06
Visual Map Composer
visual-composer
根据问题选择最合适的专业图谱语法。
输入
MGO + Template + Asset
输出
PNG / PPT / HTML / 交互图
边界
受密度和可读性规则约束
ZT-07
Map Update & Insight
map-updater
重跑旧MGO并形成版本差异和增强洞察。
输入
Old MGO + New Data
输出
Version Diff / Gap / Change
边界
变化仅作为趋势信号,不直接形成未来预测结论
3.6.2 · ALGORITHM ARCHITECTURE
算法层|把“我觉得”改成“按规则算”
《脸谱》的算法走混合路线:结构化事实打底,规则和打分管边界,轻量聚类/相似度帮忙找结构,LLM 做语义理解,Human-in-the-loop 收拾灰区。MVP 阶段不忙着训练一个“大而全”的模型,先把可解释、可复现、能抽检这三件事做扎实。MOSS 提供商业事实和关系数据,Skill 负责组织、计算和图谱生成。
01
事实优先于生成
能从结构化事实直接拿到的实体、关系、时间、招采、知产,优先用事实。LLM 主要做语义理解和辅助归纳,别让擅长说话的模型去抢数据库的饭碗。
02
打分优先于拍脑袋
候选入图、实体合并、证据质量、分类一致性都给出可解释分数和阈值。
03
不确定显式化
低置信对象直接进 NEED_REVIEW。数据心里没底,就把没底写出来;别让模型靠语气把不确定说得像盖过章。
算法服务业务图
聚类、相似度和图布局都只是工具,目标还是那六个字:找全、分准、证清、排美。算法复杂不复杂,排在后面;有没有把问题解决,排在前面。
版本变化Diff / Novelty / Drift
ZT-01|需求编译算法
ZT-02|市场对象发现算法
ZT-03|实体解析算法
ZT-04|分类树构建算法
ZT-04B|关系提炼算法
ZT-05|证据质量算法
ZT-06|自动排版算法
ZT-07|版本Diff算法
ALGORITHM DETAIL
ZT-01|Question-to-Map Compiler
先把用户一句话拆成意图、受众、范围、对象层级、分类深度、证据要求、视觉约束和输出格式,再决定查什么数据。这一步相当于先看导航再踩油门,属于任务规划算法。
① Intent Classification
把需求识别成 Tool Landscape、Vendor Landscape、Industry Ecosystem、Relation Map、Region Map、Timeline Map 等图型。先认题型,后面才知道该怎么答。
② Slot Filling
抽取 audience、market_scope、time_scope、entity_level、category_depth、style、need_logo、need_evidence 等关键槽位,把一句话变成能执行的字段。
③ Constraint Validation
检查“分类不少于10类”“国内品牌优先”“白底16:9”等约束会不会互相打架。缺字段就走默认策略或追问,别靠猜。
④ Template Retrieval
Map Purpose 和受众一确定,视觉模板就别靠灵感抽签。系统从模板库里找最合适的图形语法,再把默认密度参数一起带出来。
Compiler Confidence = 0.35×Intent + 0.25×Slot Completeness + 0.20×Constraint Consistency + 0.20×Template Match
每个算法都要回答四件事:输入什么、怎么算、输出什么、什么时候交给人
下面给出项目使用的算法目录。正式实现时,阈值统一设置为可配置参数,不把数字固定在 Prompt 中,以便根据行业、数据规模和验收结果持续校准。
|
Skill / 算法
|
主要输入
|
核心算法
|
核心输出
|
人工介入条件
|
|
ZT-01 需求编译
intent + slot + rule
|
Question、上下文、模板偏好
|
意图分类、槽位抽取、约束校验、模板匹配
|
Map Blueprint、Query Plan、Visual Plan
|
关键槽位缺失、约束冲突、置信度低
|
|
ZT-02 多路召回
multi-channel recall
|
MGO Blueprint、MOSS事实通道
|
产业链召回、画像筛选、招采召回、知产召回、相似企业扩展、Seed融合
|
Candidate Universe、Recall Source、Relevance Score
|
候选规模异常、召回高度偏向单一来源
|
|
ZT-03 实体解析
normalize + match
|
候选实体、集团/品牌/产品事实
|
文本标准化、别名映射、Blocking、字符串相似度、属性一致性、关系验证
|
Canonical Entity、Alias Map、Merge Decision
|
同名异体、归属冲突、合并置信度低
|
|
ZT-04 分类构建
cluster + hierarchy
|
实体、能力文本、产业节点、用户任务
|
规则先验 + 语义向量聚类 + 层次聚类 + LLM类名归纳 + Coherence Gate
|
Taxonomy Tree、Multi-label、Review Queue
|
轮廓系数低、类间重叠高、同层粒度冲突
|
|
ZT-04B 关系提炼
rule + graph
|
企业关系、上下游、招采、品牌归属、文本事实
|
结构化关系优先、规则映射、共现辅助、关系置信度聚合
|
Relation Edge、Relation Type、Evidence Link
|
关系来源仅有文本推断、冲突事实存在
|
|
ZT-05 证据算法
evidence scoring
|
来源、事实、时间、多源信息
|
来源可靠性、直接性、新鲜度、多源一致性、业务相关度加权
|
Evidence Score、Evidence Level、Gate Result
|
E<60、核心对象仅单源证据、事实过期
|
|
ZT-06 视觉排版
layout optimization
|
Taxonomy、实体数、关系数、Logo资产、模板
|
模板选择、类别面积分配、Logo尺寸归一、密度控制、碰撞检测、可读性目标优化
|
16:9 Map、Layout Spec、Overflow List
|
主图密度超阈值、Logo缺失率高、文字碰撞
|
|
ZT-07 版本更新
entity/taxonomy/evidence diff
|
Old MGO、New MGO
|
实体集合差异、类别漂移、关系变化、Logo变更、证据新鲜度、Novelty Score
|
Version Diff、Change Log、Update Priority
|
大规模分类漂移、关键节点退出、证据冲突激增
|
四个评分模型|把主观判断拧成可调参数
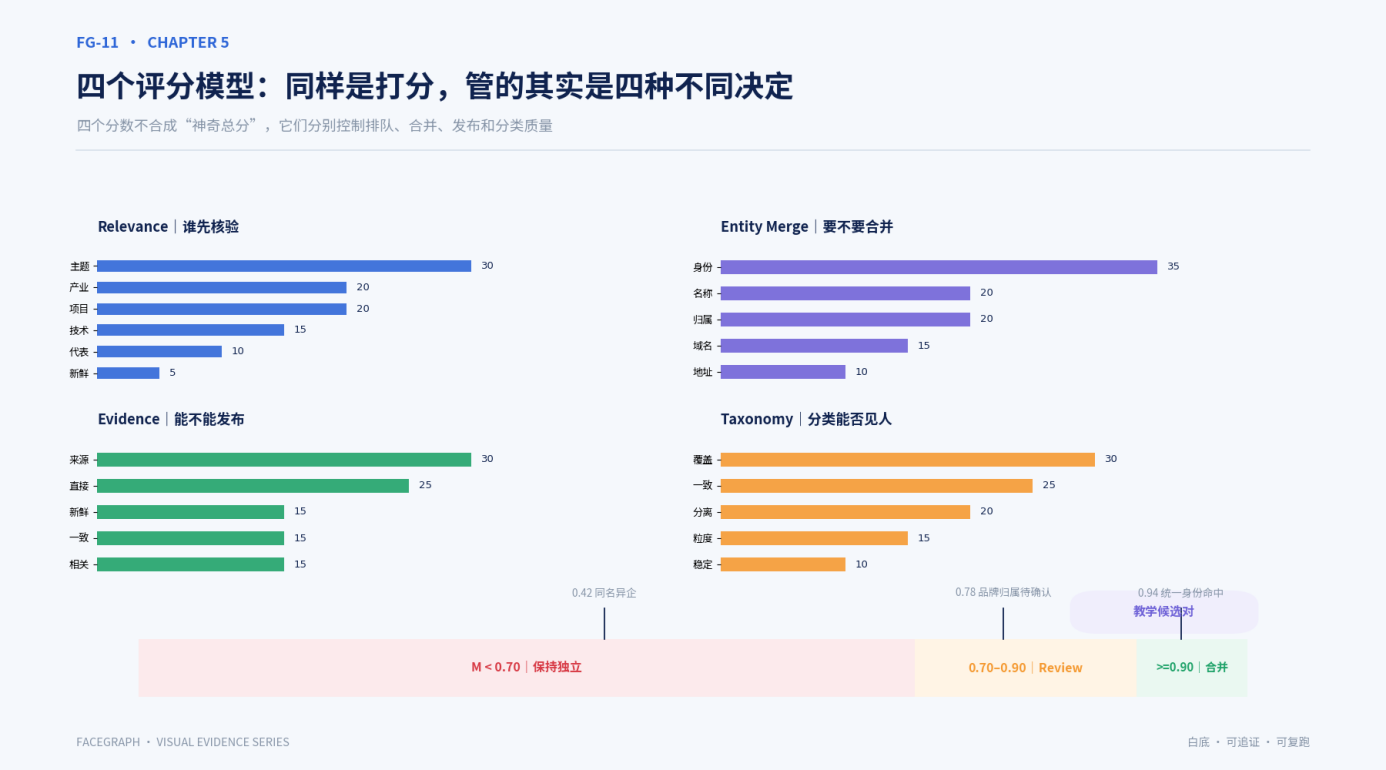
图解增强 11|评分模型的权重指纹与阈值动作
数据口径:四组权重与实体合并阈值取自原稿;候选对为教学示例。
一句话读图:相关度管排队、实体分管合并、证据分管发布、分类分管结构是否可用。
这些分数没打算把商业世界压成一个“总分”。它们更像交通灯:谁留在候选池、谁能上主图、谁去 Review、哪张图该重跑,一眼知道往哪走。
01 · RELEVANCE
候选对象相关度分
Relevance Score 先给 Candidate Universe 排队。主题相关、产业节点、真实项目、技术能力、代表性和新鲜度一起看,免得“网上声量大”直接坐到第一排。
R = .30·Topic + .20·Industry + .20·Project + .15·Tech + .10·Represent + .05·Fresh
使用:高分优先进入证据核验,不等于一定上主图。
02 · ENTITY MATCH
实体合并置信度
Entity Merge Score 解决一个很朴素的问题:这两个名字到底是不是同一个对象。统一身份、品牌归属这些硬事实权重大,名字长得像只能算辅助,不能靠“面相”认亲。
M = .35·ID + .20·NameSim + .20·Owner + .15·Domain + .10·Address
使用规则很直白:M≥0.90 自动合并;0.70—0.90 先送 Review;低于 0.70 各坐各的位置,暂不硬凑一家人。
03 · EVIDENCE
证据成熟度分
Evidence Score 决定对象有没有资格正式上图。来源可靠性和事实直接性排在前面,新鲜度与多源一致性负责防两件事:旧闻当新闻,孤证当铁证。
E = .30·Source + .25·Direct + .15·Fresh + .15·Consistency + .15·Relevance
使用规则:E≥80,主图推荐;60—80,可以展示但要标注;E<60,先留在候选区或待复核。证件没带齐,先别进贵宾席。
04 · CATEGORY QUALITY
分类质量分
Taxonomy Quality Score 管的是“这套分类能不能见人”。既要把对象接得住,也要避免类别互相踩脚,还得保证同一层说的是同一粒度。
C = .30·Coverage + .25·Coherence + .20·Separation + .15·Granularity + .10·Stability
使用:低分Taxonomy不进入排版,先回到分类重构或人工确认。
3.6.3 · TAXONOMY & ENTITY
分类采用规则先验 + 聚类 + 层级约束
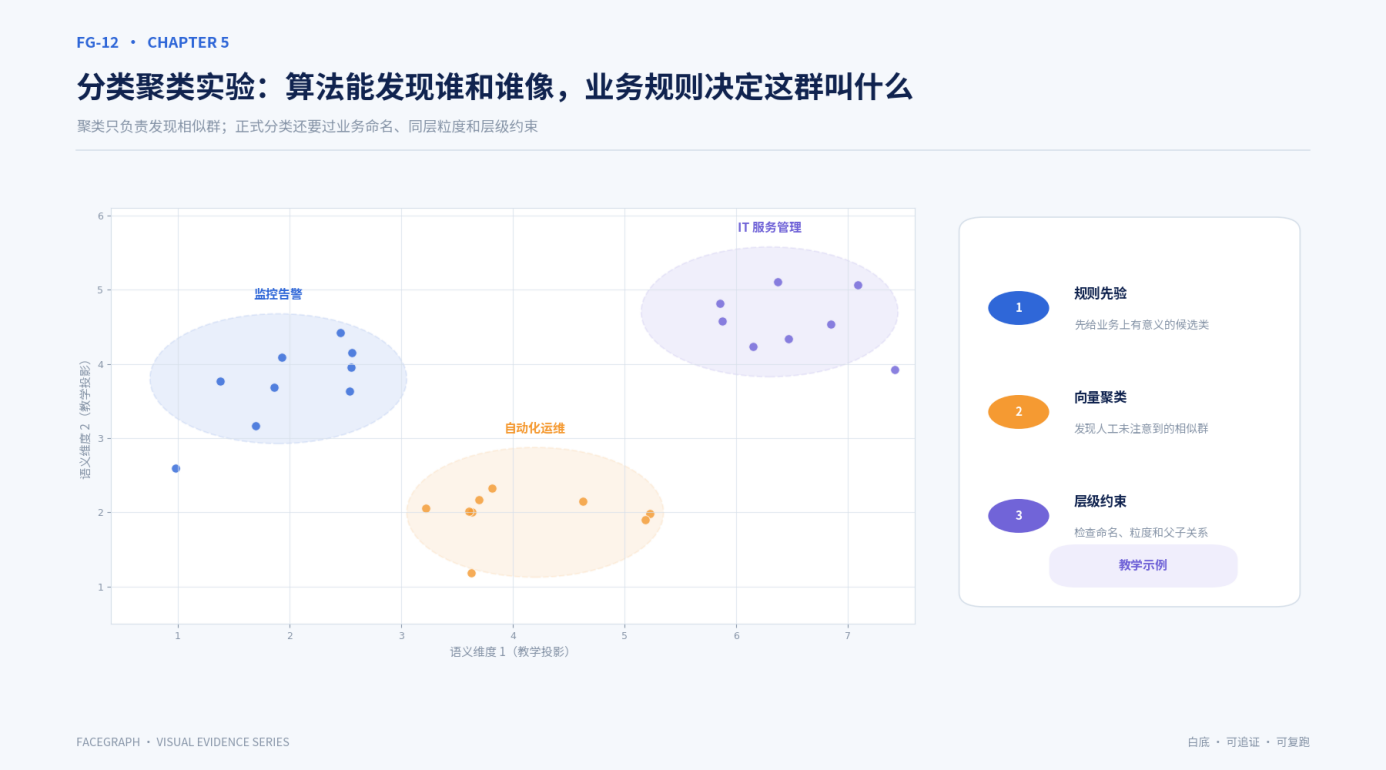
图解增强 12|规则先验、聚类与层级约束的二维教学实验
数据口径:二维点位为教学示例,仅解释分类机制。
一句话读图:聚类提供相似群线索,正式分类仍要经过受众目标、业务语义和同层粒度检查。
分类是《脸谱》最关键的一层,因为用户第一眼就是靠它认识行业。MVP 采用“业务先验打底、聚类辅助找群、LLM 负责起名和解释”。聚类只提供线索,最后还要过业务规则和 Taxonomy Gate,才能变成正式分类。
TREE
|
阶段
|
算法/方法
|
作用
|
关键检查
|
|
1|候选类生成
|
产业链节点 + 业务规则 + 高频能力词
|
先给出有业务意义的分类先验
|
是否覆盖用户核心问题
|
|
2|语义表示
|
产品/企业能力描述向量化(Embedding)
|
把相似业务能力映射到相近空间
|
文本是否足够、噪声是否过多
|
|
3|聚类辅助
|
层次聚类 / K-means(作为辅助)
|
发现人工先验没有注意到的对象簇
|
Silhouette、簇规模、稳定性
|
|
4|层级构建
|
Hierarchical Clustering + Parent Rule
|
形成一级类 / 二级类结构
|
同层粒度、父子关系合理性
|
|
5|类名归纳
|
LLM Summary + Keyword Contrast
|
把对象簇总结为业务可读的类名
|
类名是否互斥、是否过宽/过窄
|
|
6|多标签分配
|
Top-k similarity + Rule Override
|
允许一物多类,但保留主分类
|
主分类必须唯一,标签数量受限
|
|
7|Taxonomy Gate
|
Coverage / Coherence / Separation / Granularity
|
决定分类树能否进入正式排版
|
低分→重构或人工复核
|
这里有条硬规矩:聚类只能告诉我们“谁跟谁像”,它没有资格单独决定“业务上这群人叫什么”。最终 Taxonomy 还得过受众目标、业务规则和同层粒度三道检查。
实体解析:解决“阿里巴巴 / 阿里云 / 某云产品”被当成同一层对象的问题
实体解析先认身份证,再看名字像不像。结构化身份、集团与品牌归属放在前面,名称相似度放在后面,可以少掉很多“名字像就合并”和“品牌跟工商主体坐一桌”的事故。
STEP 1
Normalize
统一中英文、大小写、全半角、常见公司后缀、空格和符号。
输出:normalized_name
STEP 2
Blocking
按地区、域名、集团、品牌关键词等先分块,避免全量两两比较。
输出:candidate_pairs
STEP 3
Name Similarity
编辑距离、Token相似、别名表等用于计算名字相似度。
输出:name_sim
STEP 4
Attribute Match
企业身份、品牌owner、官网域名、地址、集团关系等事实交叉核对。
输出:attribute_score
STEP 5
Merge Gate
高置信自动合并,中间区间进入Review,低置信保持独立。
M≥.90 / REVIEW .70-.90
3.6.4 · VISUAL & VERSION
自动排版|好图的第一原则:别让眼睛加班
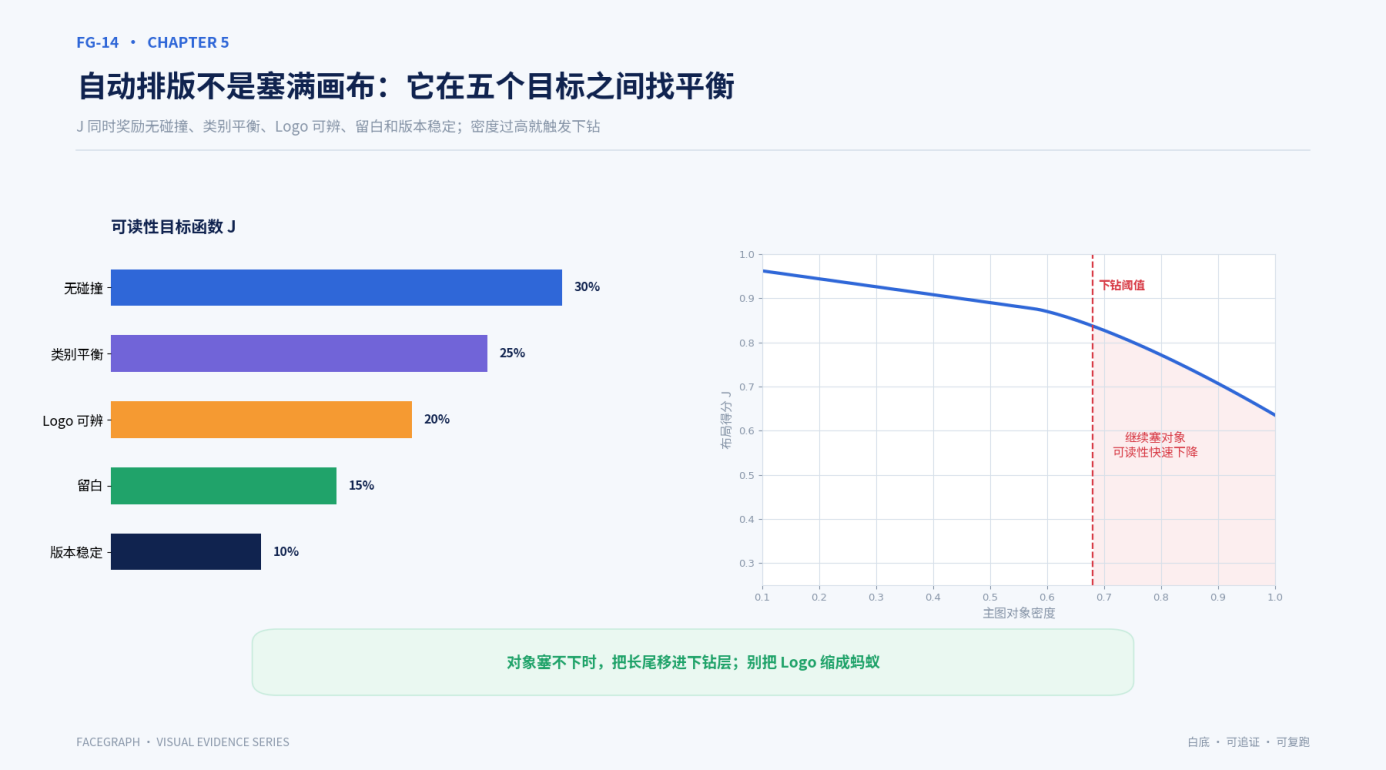
图解增强 14|自动排版的多目标权衡
数据口径:目标函数权重取自原稿;密度响应为教学示意。
一句话读图:当密度继续上升并伤害可读性时,正确动作是把长尾移入下钻层。
视觉引擎先看图谱类型,再选布局。它同时照顾分类稳定、Logo 可辨、文字不撞车、主次清楚和 16:9 空间利用。对象塞不下时,长尾往下钻层走,别把 Logo 缩成蚂蚁。
LAY
|
图谱类型
|
首选布局算法
|
优化目标
|
溢出策略
|
|
Tool / Vendor Landscape
|
分类矩阵 + Bin Packing / Grid Packing
|
类别面积与对象数成比例、Logo视觉高度一致、阅读路径稳定
|
每类Top-N主图,其余进入“更多”
|
|
Industry Ecosystem
|
Radial / Sector Layout
|
中心主题明确、一级角色等角分区、层级距离一致
|
二级对象收进扇区下钻
|
|
Layered Stack
|
DAG Topological Layout
|
基础→平台→应用→治理的方向性清楚
|
同层按代表性排序
|
|
Relation Network
|
Force-directed + Community Constraint
|
减少边交叉、突出社群与桥接节点
|
低权重边默认隐藏,点击展开
|
|
Timeline Map
|
Temporal Lane Layout
|
时间顺序稳定、变化类型可比较
|
事件聚合 / 只标重点变化
|
READABILITY OBJECTIVE
可读性目标函数
J = .30·NoCollision + .25·CategoryBalance + .20·LogoLegibility + .15·Whitespace + .10·VisualStability
当J下降时,优先减少主图对象,而继续压缩字号和Logo。
DENSITY RULE
密度控制
Density = VisibleObjects / EffectiveCanvasArea
超过模板阈值时,将低优先级对象移入下钻层,并保留在底稿数据中。
LOGO NORMALIZATION
Logo视觉归一
VisualHeight = TargetHeight × BrandAspectCorrection
避免宽Logo显得过大。
STABILITY
版本布局稳定
Stability = 1 - MeanPositionShift(existing_nodes)
月度更新时尽量保持老对象位置,保持用户对图谱结构的连续认知。
更新算法|行业每天都在动,提醒只挑值得看的
版本更新做的事像“逐层对账”。Old MGO 和 New MGO 从实体、分类、关系、证据、Logo 到风险状态一层层比,再算变化重要度和新颖度。这样每次重跑不会满屏都是“有变化”,真正值得看的才响铃。
ENTITY DIFF
对象变化
集合差异检测负责认出 NEW / REMOVED / RENAMED / MERGED / SPLIT。行业一动,它先告诉你动的是谁、怎么动的。
ΔEntity = NewSet ⊖ OldSet
TAXONOMY DRIFT
类别漂移
检测对象从A类迁到B类、类新增、类合并和层级变化。
Drift = ChangedAssignments / StableEntities
EVIDENCE FRESHNESS
证据新鲜度
时间衰减用于识别“以前证据很强,但现在已经过期”。
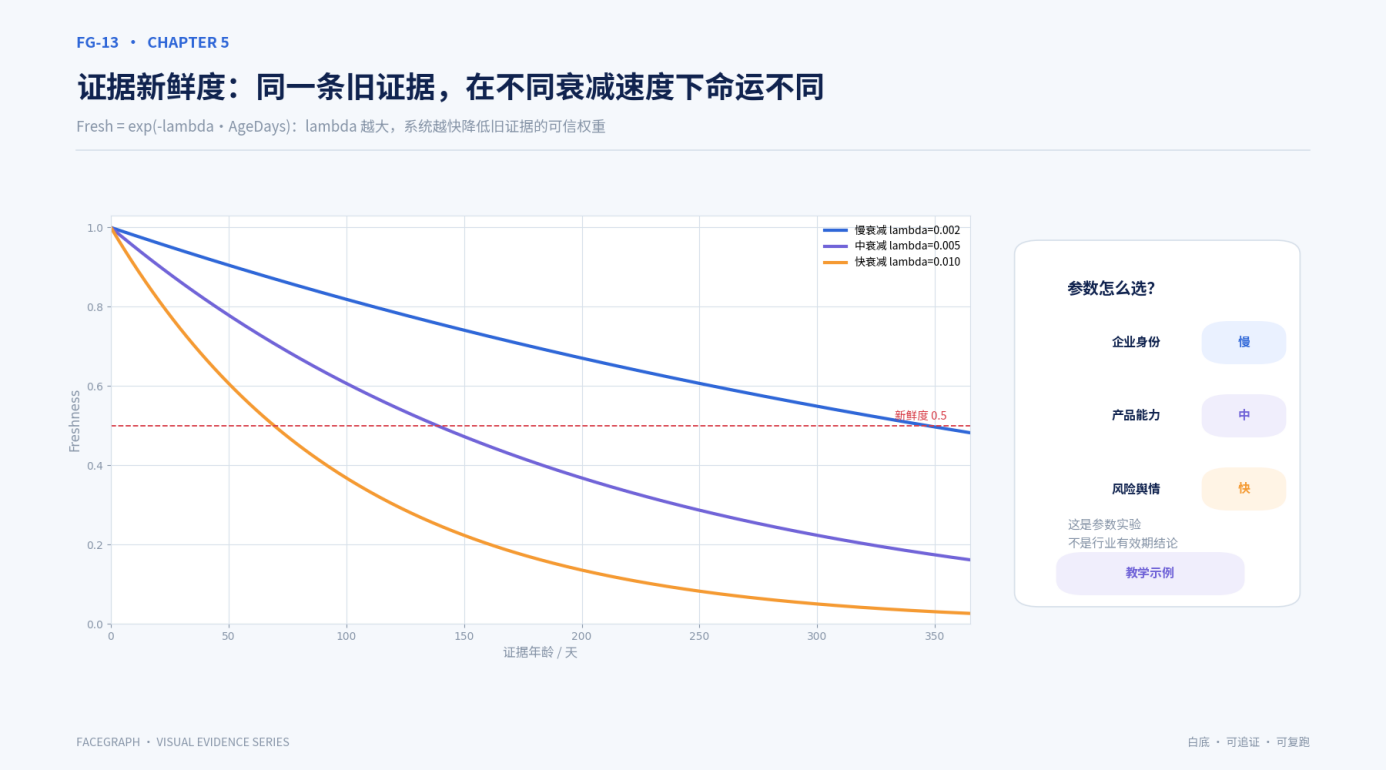
图解增强 13|证据新鲜度参数扫描
数据口径:Fresh = exp(-λ·AgeDays) 的数学参数实验,不代表特定行业的真实有效期。
一句话读图:λ 越大,系统越不信任旧证据;不同事实类型应配置不同衰减速度。
Fresh = exp(-λ·AgeDays)
NOVELTY SCORE
变化提醒优先级
Novelty Score 把新对象的代表性、证据质量、结构影响和变化幅度放在一起算。目的很简单:从一堆“发生了变化”里,捞出真正值得业务人员抬头看的那几条。
N = .30·Impact + .25·Evidence + .25·Rarity + .20·Recency
3.7 MOSS 实测、案例与版本
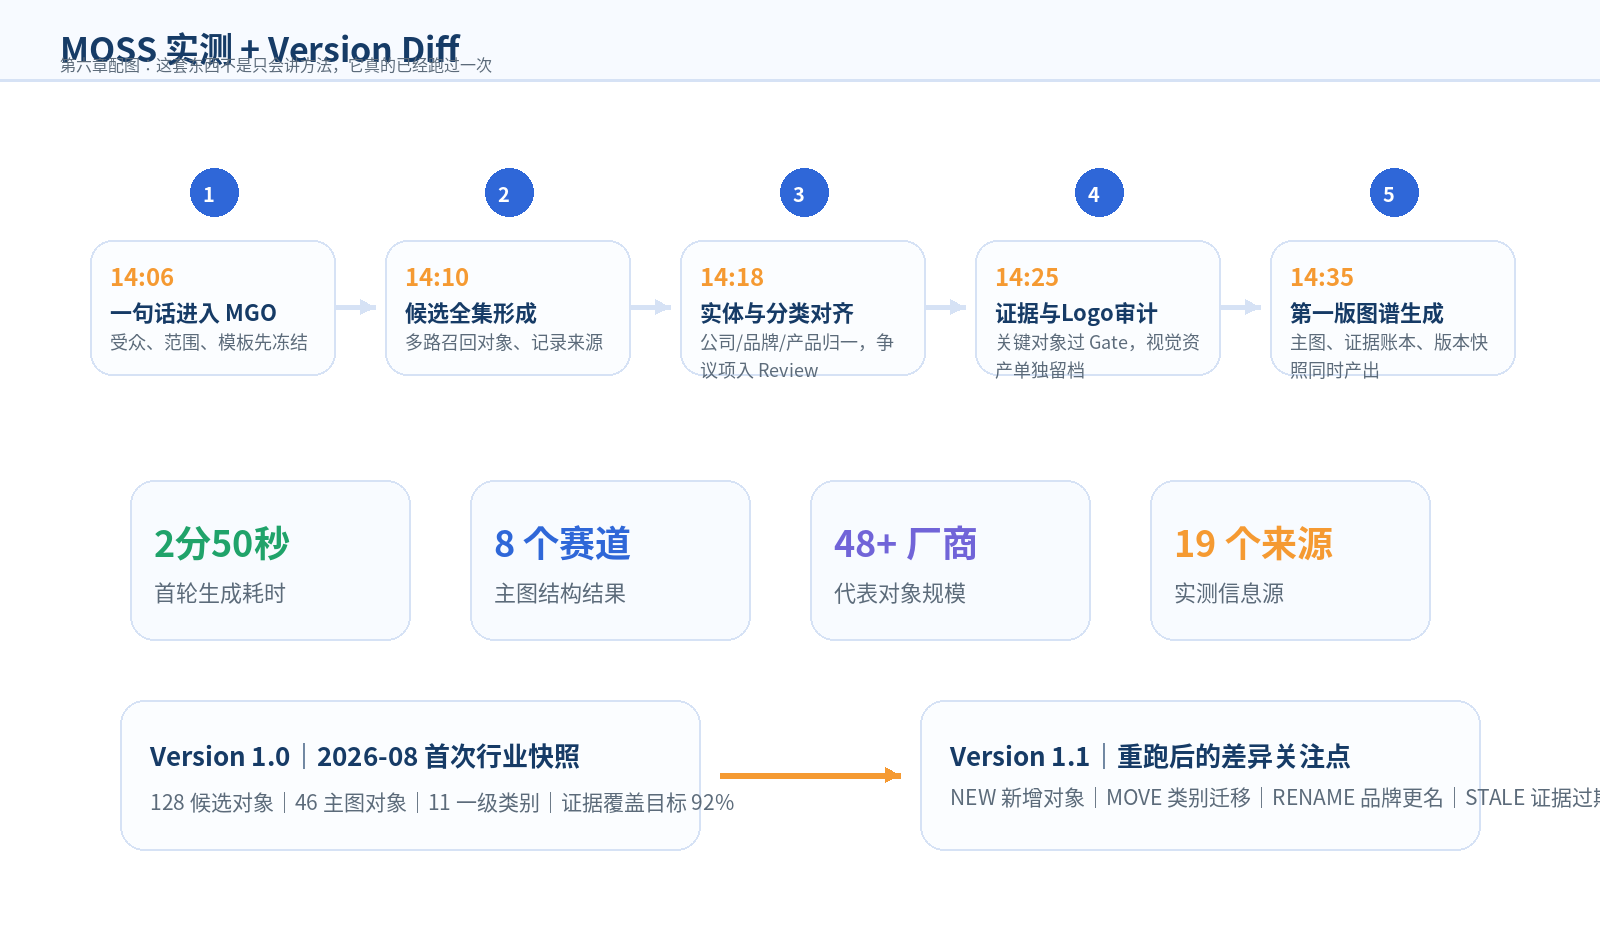
图6 MOSS 实测时间线与 Version Diff 逻辑
3.7.1 · MOSS REAL RUN
MOSS 首次实测|2分50秒后,图谱出来
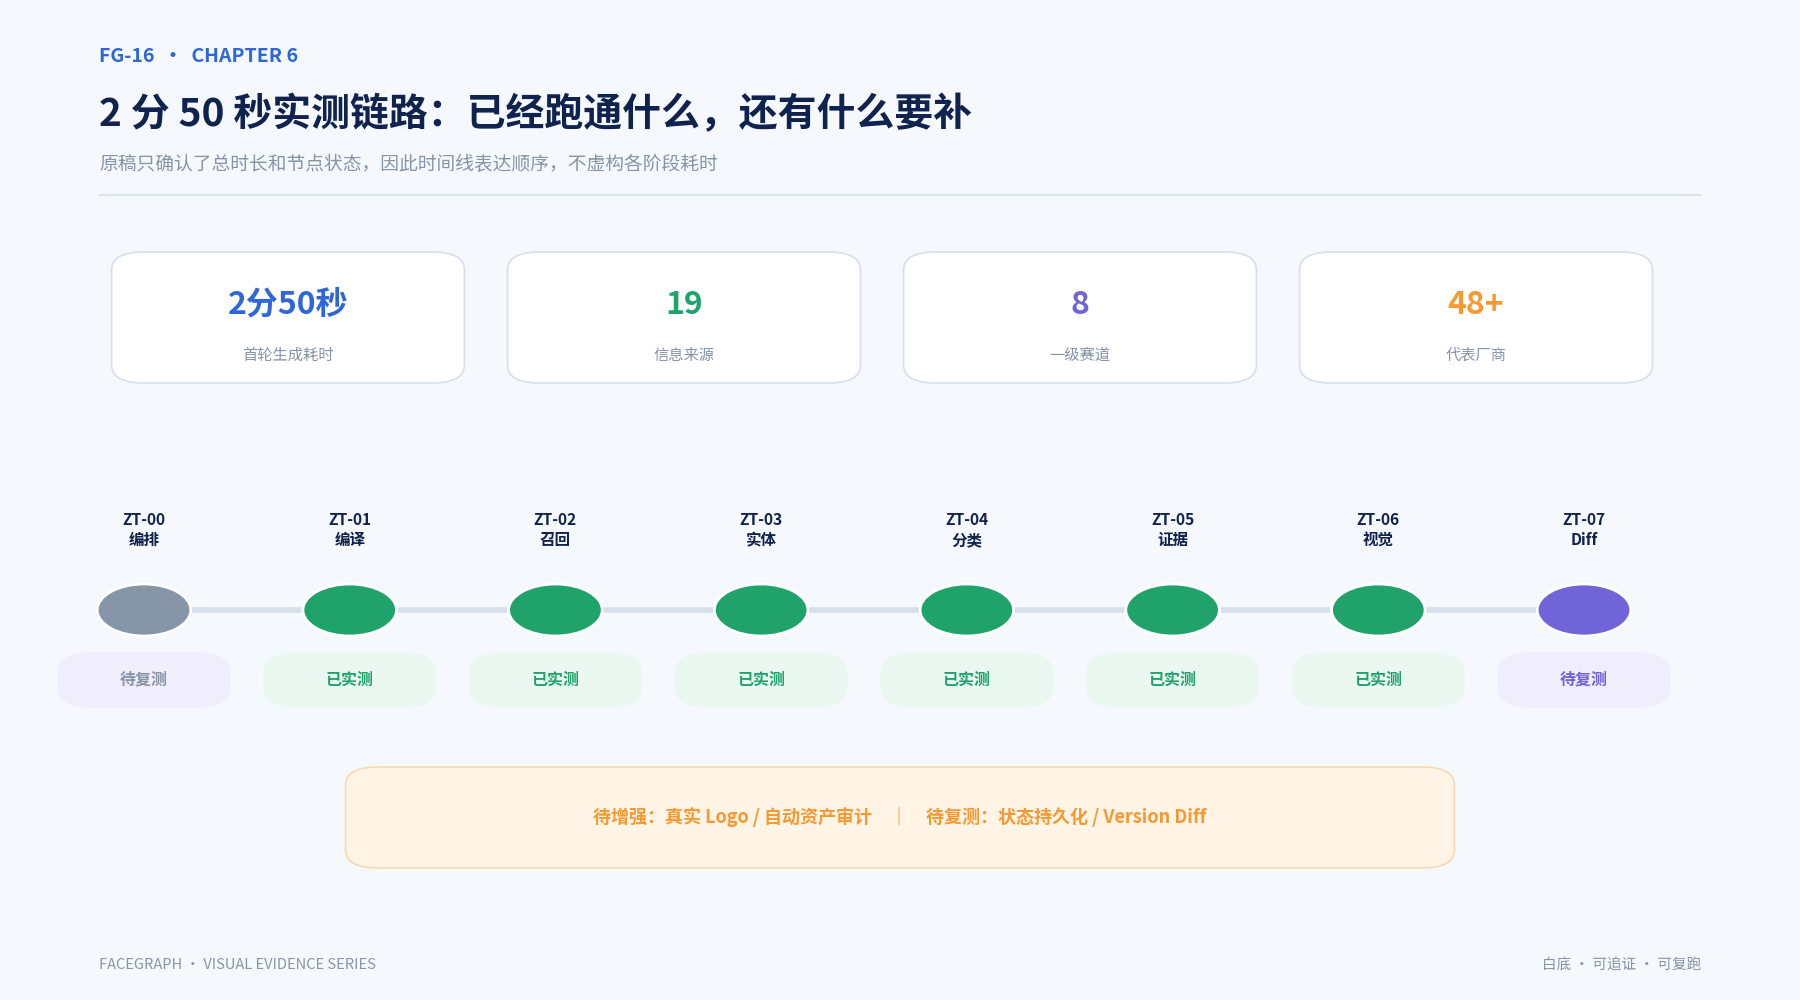
图解增强 16|MOSS 首次实测状态时间线
数据口径:总时长、来源、赛道、厂商规模及各 Skill 状态取自原稿;未掌握阶段耗时,因此只表达顺序。
一句话读图:ZT-01 至 ZT-06 已走通最小路径,资产审计、状态持久化和版本 Diff 仍需继续补证。
这次项目书把真实运行证据补进来了。Skill Pack 已在 MOSS 当前智能体中保存并启用,随后直接输入“运维工具图谱”。安装、召回、归一、分类、证据审计、HTML 可视化一路跑下来,项目终于从“架构图上看着能跑”走到了“系统里确实跑过”。
|
实测来源|MOSS 分享记录 · 2026-08-12 · 当前智能体“客户洞察”
|
先看成绩单:2分50秒,8个赛道,48+厂商,19个信息来源
|
2m50s
|
19
|
8
|
48+
|
|
首轮生成耗时
MOSS 界面显示
|
信息来源
本次运行
|
一级赛道
Taxonomy 输出
|
代表厂商
图谱规模
|
01|Skill 先装上:这一步已经从 ZIP 走到 MOSS
MOSS 先判断 FaceGraph 和“客户洞察”怎么衔接,再生成技能草稿。实测记录里共有 7 个文件:1 个 SKILL.md 统领 8 个子模块,外加 6 个 references。确认后保存并启用,触发词包括“行业图谱”“生态图”“厂商全景图”“Landscape”等。
|
能力
|
客户洞察
|
FaceGraph
|
|
数据获取
|
按需查企业事实、产业链、商机与合作线索
|
批量消费已确认事实,组织成行业结构
|
|
研究加工
|
连点成线、形成商业判断与行动建议
|
实体归一、研究级分类、Evidence Ledger
|
|
长期沉淀
|
单次分析/客户洞察记录
|
MGO、Taxonomy、Version Diff、行业图谱资产
|
02|一句“运维工具图谱”,真实走通了 ZT-01 → ZT-06
第一次真实任务已经把六段主链串起来:需求编译、候选召回、实体归一、语义分类、证据审计、HTML 可视化。ZT-07 需要历史快照,首跑没有旧账可对,所以先不登场;等同一主题第二次运行,再验 Version Diff。
|
Skill
|
实测状态
|
本次做了什么
|
本次交付
|
|
ZT-00
|
待二次确认
|
实测记录后段给出 Run ID 与状态流转;前段总结又写明状态管理未启用
|
按“编排逻辑已验证、状态持久化待复测”处理
|
|
ZT-01
|
已实测
|
把“运维工具图谱”编译成 Tool Landscape;Confidence 0.90
|
Map Blueprint / Query Plan
|
|
ZT-02
|
已实测
|
产业链、企业画像、知产、公开研报等多路召回
|
Candidate Universe
|
|
ZT-03
|
已实测
|
处理嘉为科技/嘉为蓝鲸/Canway等名称与层级
|
Canonical Entity
|
|
ZT-04
|
已实测
|
形成 8 个一级赛道、48+ 代表厂商
|
Taxonomy / Assignment
|
|
ZT-05
|
已实测
|
输出 E0-E5 Evidence 体系;关键对象进入证据审计
|
Evidence Ledger / Review
|
|
ZT-06
|
已实测
|
采用 WHITE_LANDSCAPE,生成交互 HTML 与独立 HTML
|
HTML 图谱 + Evidence 表
|
|
ZT-07
|
待第二次运行
|
首次建图缺少历史 MGO Snapshot
|
Version Diff 尚未实测
|
03|每一步到底干了什么:用实测数字说话
ZT-01|需求编译 直接搜“运维”,第一网捞上来 5,288 条,光伏、风电、建筑运维全来凑热闹。Compiler 把范围收紧到 IT 运维管理软件、智能运维、DevOps 和监控,候选池立刻从“大杂烩”变成能用的材料。
ZT-02|候选召回 产业链节点返回 1,111 + 2,589 家关联企业;企业画像“智能运维+高新技术企业”返回 981 条,“IT运维管理+软件开发行业”返回 1,221 条;境外厂商再用公开研报和行业资料补位。先广撒网,再做筛选。
ZT-03|实体归一 嘉为科技 / 嘉为蓝鲸 / Canway 的 Merge Score=0.95,自动合并;ManageEngine / 卓豪 / Zoho=0.78,送 Review;蓝鲸智云 / 腾讯蓝鲸 / BK-CI=0.88,同样先复核。分数负责分流,灰区留给人。
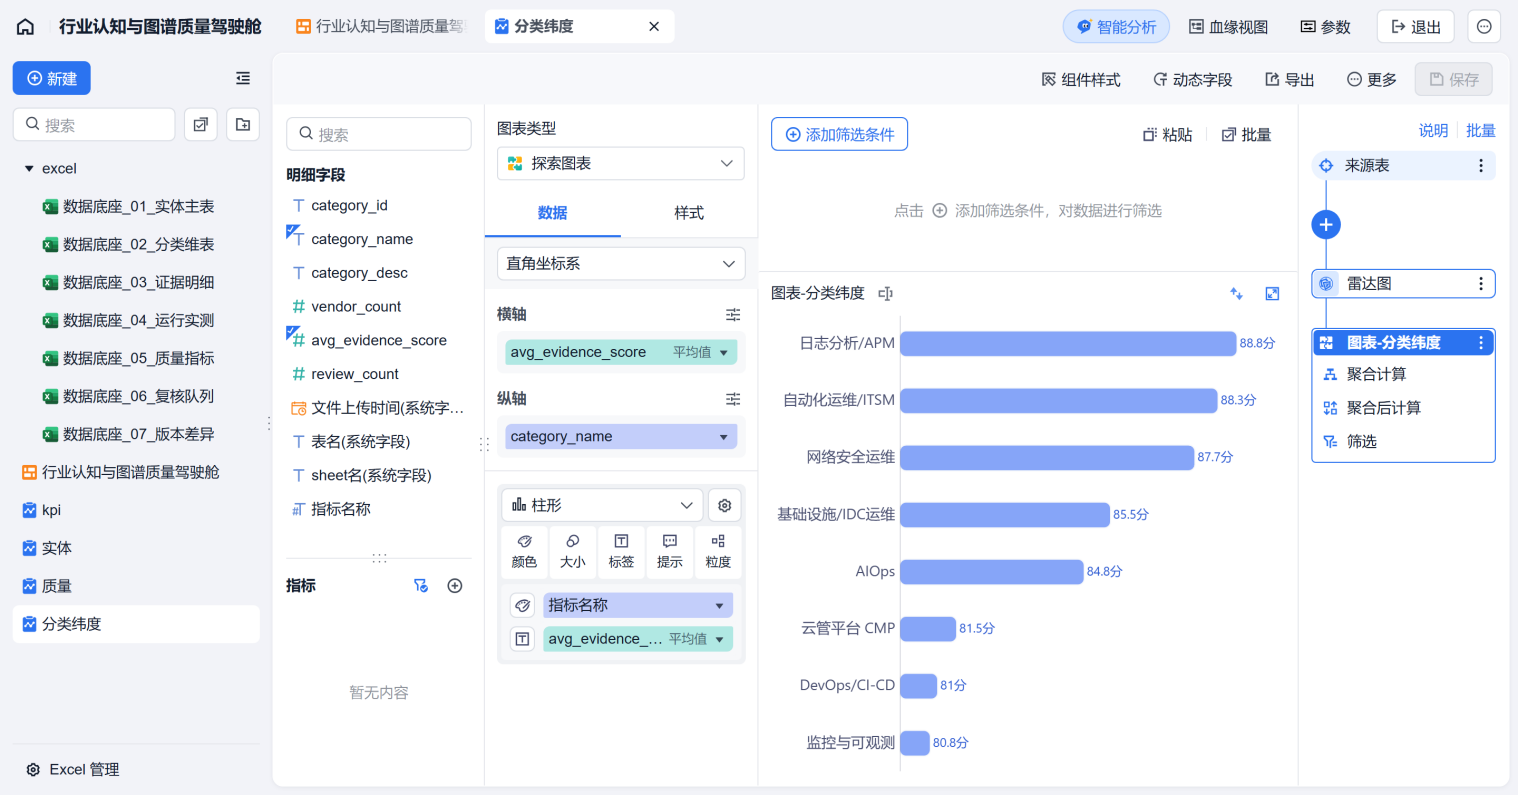
ZT-04|语义分类 最终收敛成 8 个一级赛道:AIOps、监控与可观测、自动化运维/ITSM、DevOps/CI-CD、日志分析/APM、基础设施/IDC运维、网络安全运维、云管平台 CMP。候选多,主骨架得清楚。
ZT-05|证据审计 嘉为蓝鲸 E92、博睿数据 E90、深信服 E95、Dynatrace E85、Zabbix E82;Jenkins 示例 E68。过去“看着靠谱”很难说清,现在证据强弱直接摆在桌上。
ZT-06|视觉交付 采用 WHITE_LANDSCAPE,每个赛道挑 5—8 个代表厂商做 Grid Packing。本轮真实输出是交互 HTML + 独立 HTML,并带完整 Evidence Ledger。图能看,账也能查。
04|这次实测最值钱的地方:它也暴露了三件必须继续补的事
Logo 这关还欠作业。本轮没有采集真实 Logo,48 条视觉资产统一使用 TEXT_CARD fallback。事实链已经跑通,品牌资产自动化还要继续接官网或可信品牌库,再走 Logo Ledger 审核。
Version Diff 也还没轮到上场。第一次建图没有历史 MGO Snapshot,ZT-07 暂时无账可对。下一次再跑“运维工具图谱”,新旧版本坐到一张桌上,才算正式验收。
第二次测试还要把两处口径钉牢。首版 Taxonomy Quality=0.886,但 Stability 标记 N/A;同时存在“主图对象均 E2+”和 Jenkins E1/68 示例的边界差异。下一版把归一规则、主图与辅助对象边界直接写进 Gate,别让口径自己长腿。
05|实测结论:项目现在有了“能跑”的证据,下一步要补“重复跑得稳”
这次运行已经验证三件事:Skill Pack 可以安装和调用,主链能够完成端到端运行,并能把几千条宽泛候选压缩成有分类、有证据的行业图。下一阶段补两轮验证:一轮完成真实 Logo 审计和 Review,一轮对同一主题重跑以验收 Version Diff。运行问题、修订记录和验证结果全部纳入项目底账。
|
已实测
ZT-01~ZT-06
最小可运行路径已经走通
|
待增强
真实 Logo / 自动资产审计
当前使用 TEXT_CARD fallback
|
待复测
ZT-00 状态持久化 / ZT-07 Version Diff
下一轮同主题重跑验证
|
06|和 MOSS“客户洞察”怎么接:保持独立 Skill,底层能力共享
P0|独立安装 FaceGraph 保留自己的 MGO、状态机和交付清单,通过编排层调用 MOSS 数据工具。主线自己管,事实能力按需调用。
P1|共享 Entity Resolver ZT-03 可以反哺多实体对比、产业链拓客等客户洞察场景。一套实体规则,多处少返工。
P2|Evidence Ledger 可选增强 深度行业报告打开结构化证据账本;轻量查询继续走快车道,不强迫每个问题都背一只大书包。
P3|Version Diff 接自动任务 重点行业按周期重跑,把真正有价值的变化推送给业务团队,免得大家每月手工对两张图找不同。
3.7.2 · MAIN CASE
主案例:从一句“运维工具图谱”,跑到一张真实 MOSS 行业脸谱
运维工具案例作为项目主案例,因为它已经在 MOSS 中完成真实运行。案例覆盖安装、触发、召回、归一、分类、证据和 HTML 交付的完整链路,可用于检验流程是否打通、输出是否可追溯。
USER REQUEST
“运维工具图谱”
MOSS 把“运维工具图谱”编译成 Tool Landscape,随后完成候选召回、实体归一、8 赛道分类、Evidence Ledger 和 HTML 可视化。输入很短,后台这趟活可一点不少。
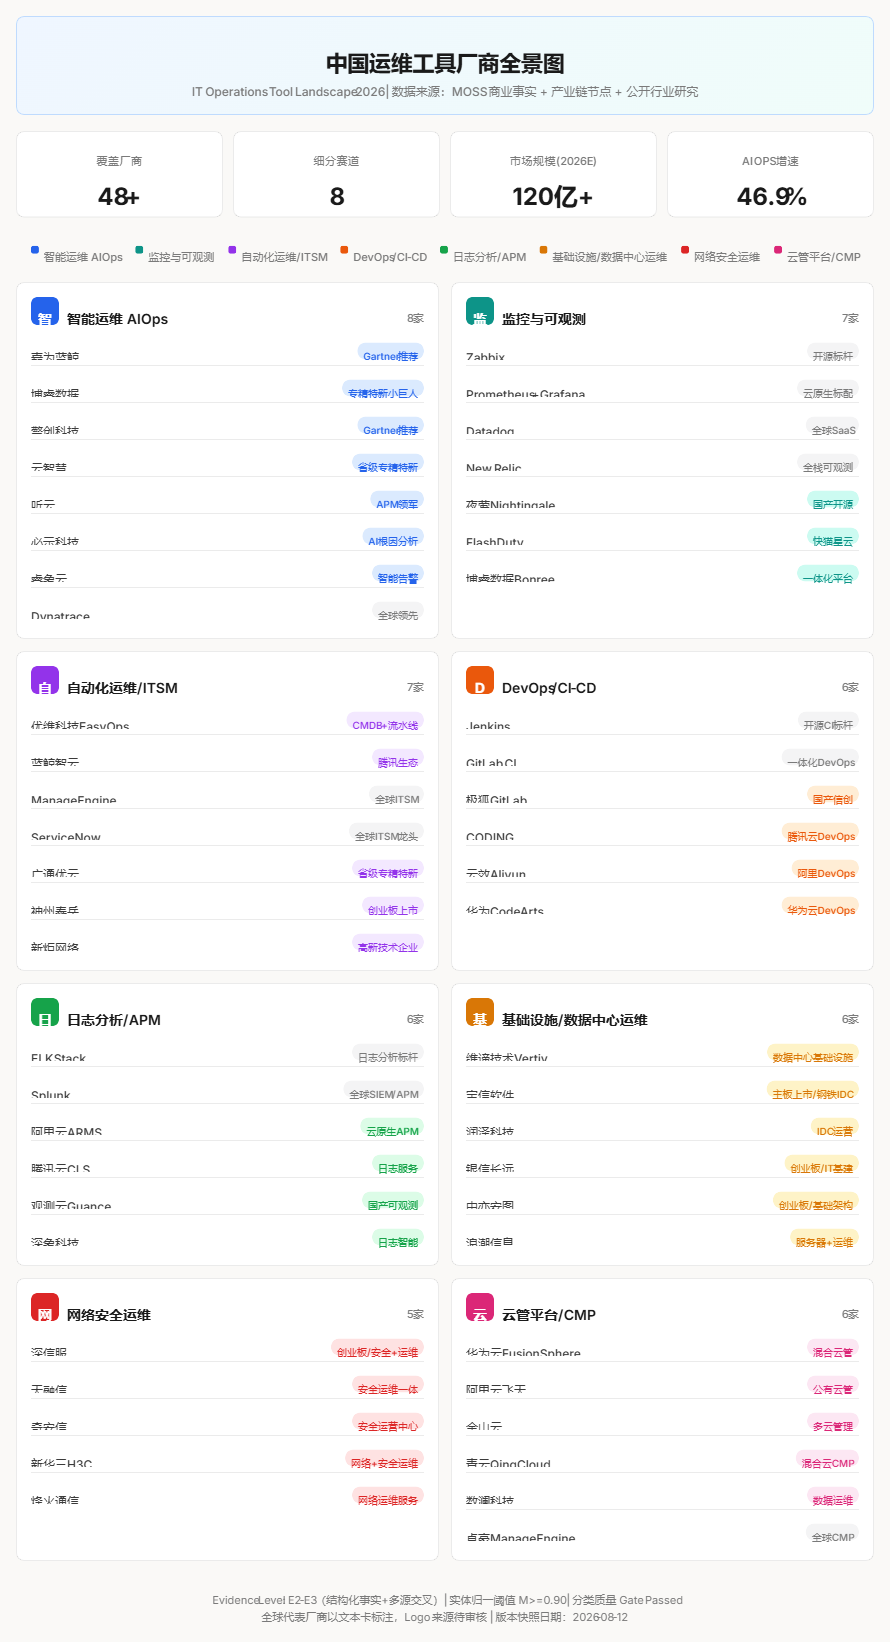
本次实际交付:交互 HTML + 独立 HTML + Evidence Ledger。真实 Logo 资产还要补,Version Diff 等第二次同主题运行后再验。已经完成的写完成,没完成的就留张待办单。
STEP 01需求编译
STEP 01|需求编译 识别 Tool Landscape;中国市场为主,补充全球代表;entity_level=Brand/Product;视觉走 WHITE_LANDSCAPE;Compiler Confidence=0.90。先把题目框住,后面才不跑偏。
STEP 02市场发现
STEP 02|候选召回 产业链、企业画像、知产和公开行业资料多路一起找。宽泛“运维”先捞出 5,288 条,再按主题收窄进入候选筛选。网可以撒大,主图不能乱。
STEP 03分类生成
STEP 03|分类成骨架 最终形成 8 个一级赛道、48+ 代表厂商。AIOps、可观测、ITSM、DevOps、APM、安全运维、IDC 运维、CMP 等边界统一送进 Taxonomy Gate 检查。
STEP 04实体解析
STEP 04|实体解析 嘉为科技 / 嘉为蓝鲸 / Canway 等完成实体归一;0.70—0.90 的灰区对象进入 Review。机器拿不准,就别装得很笃定。
STEP 05证据校验
STEP 05|证据校验 Evidence Ledger 给关键对象计算 E0—E5 等级与分数,同时把“为什么上图”记下来。Logo 看着再熟,也得带依据。
STEP 06Logo资产审计
STEP 06|Logo 审计 本轮真实 Logo 还没采集,48 条视觉资产统一走 TEXT_CARD fallback,并进入 Logo Ledger 后续审核。缺什么就写什么,别拿生成图蒙混过关。
STEP 07图谱排版
STEP 07|图谱排版 WHITE_LANDSCAPE + Grid Packing,每个赛道摆 5—8 个代表厂商,输出交互 HTML。能看全,也给长尾留了下钻入口。
STEP 08保存版本
STEP 08|保存版本 首次建图没有历史快照,ZT-07 先不上场;下一轮同主题重跑,再正式验证 Version Diff。第一次没有“前任”,自然没法比。
主案例首轮实测:2 分 50 秒、19 个信息来源、8 个一级赛道、48+ 代表厂商。下一轮重点补三件事:真实 Logo、Gate 口径、Version Diff。成绩写在这儿,作业也写在这儿。
|
可复制主题
|
自动分类示例
|
典型用户
|
|
运维工具图谱
|
监控告警 / 日志 / 链路 / 自动化 / ITSM / K8s / 安全 / 数据库 / 备份 / 网络
|
运维负责人 / 架构师
|
|
数据库与数据平台图谱
|
数据库 / 数仓 / ETL / 湖仓 / 治理 / 指标 / AI分析
|
数据平台负责人
|
|
供应链软件图谱
|
SRM / WMS / TMS / OMS / 计划 / 采购 / 风控
|
供应链负责人
|
|
AI Agent 工具图谱
|
模型 / Agent框架 / RAG / 评测 / 可观测 / 安全
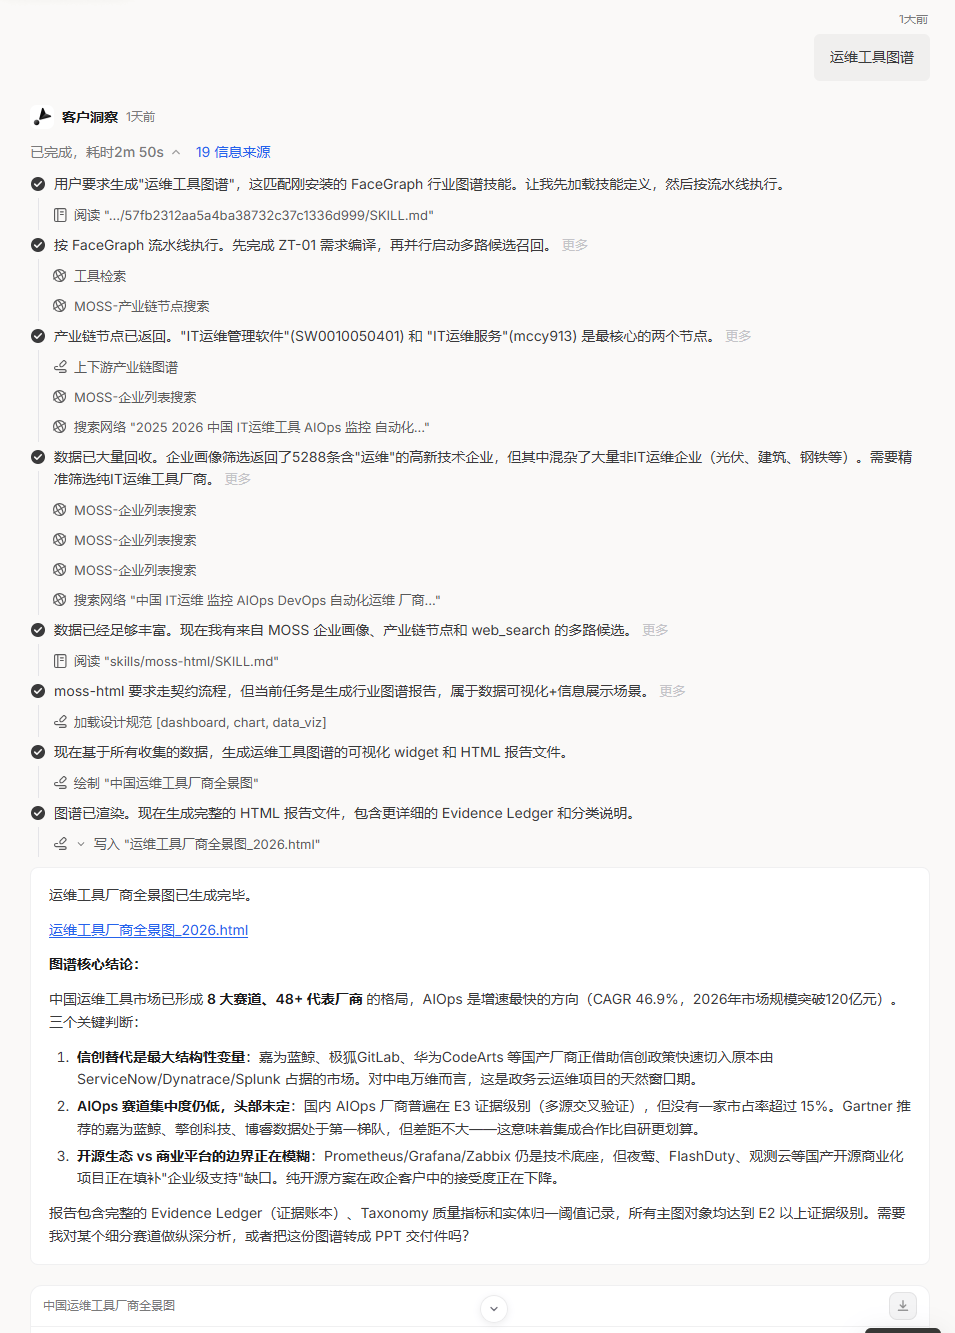
|
AI团队
|
|
快消数字化工具图谱
|
SFA / DMS / CRM / 促销 / 渠道 / 预测 / 终端识别
|
快消数字化负责人
|
|
区域产业生态图
|
龙头 / 专精特新 / 上下游 / 园区 / 科研 / 资本
|
招商 / 园区
|
3.8 MOSS 平台实操与复现记录
3.8.1 · FaceGraph 行业图谱 Skill 安装
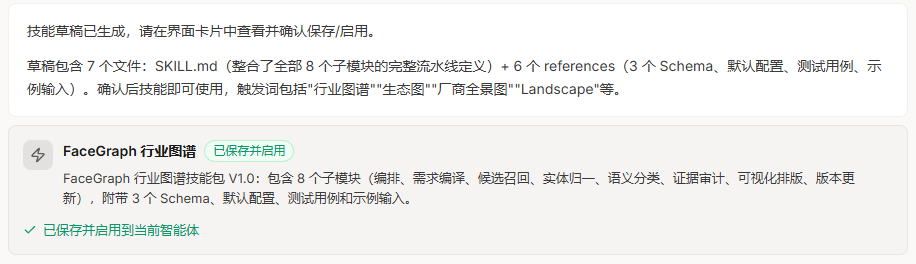
3.8.2 · 运行结论
3.9 FineNext展示
链接:https://next.finebi.com/decision/application/3afeb732e6e34b539847db869e4d24
制作步骤:MOSS生成数据导入FineNext
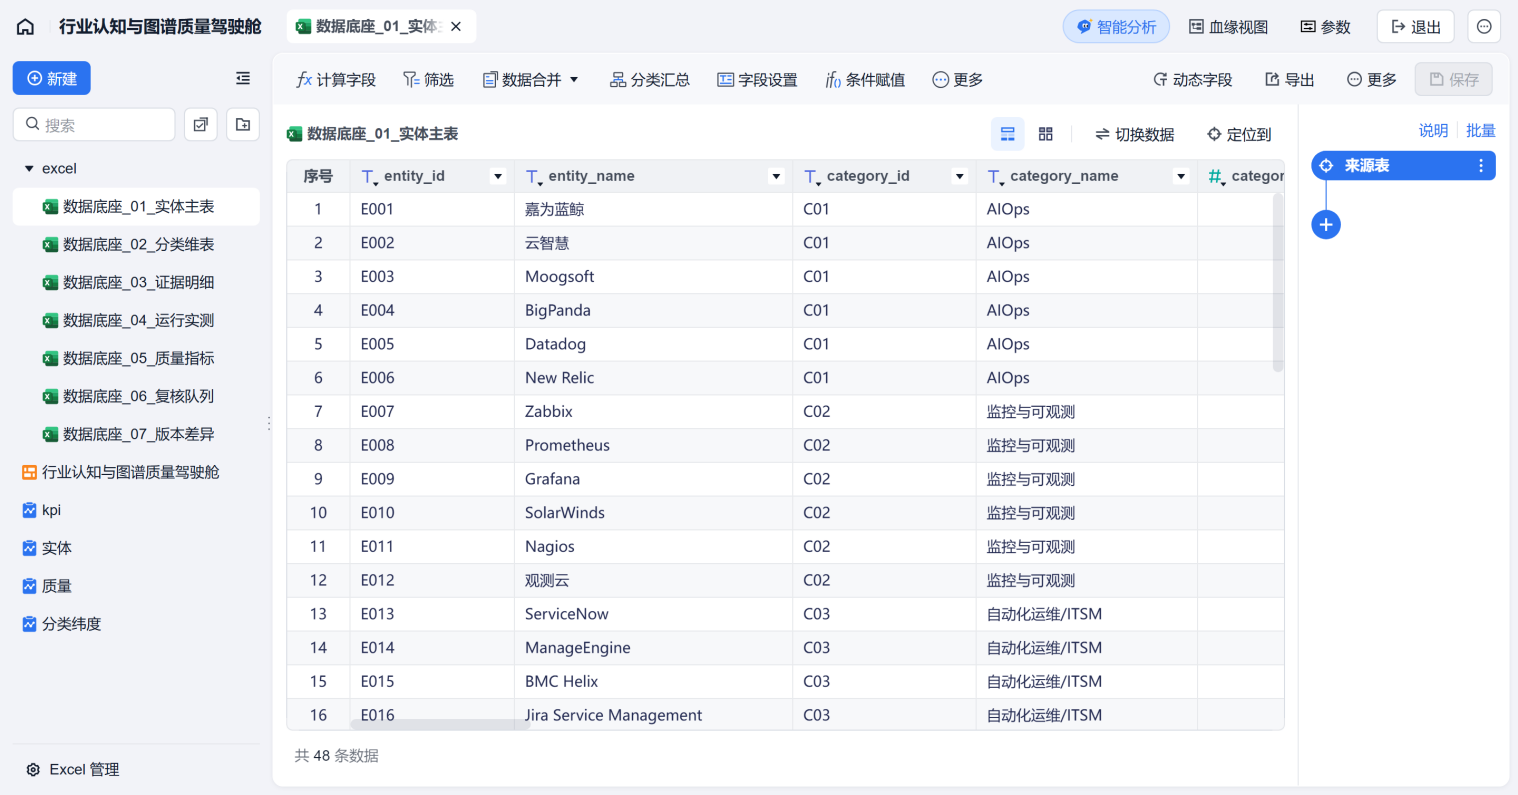
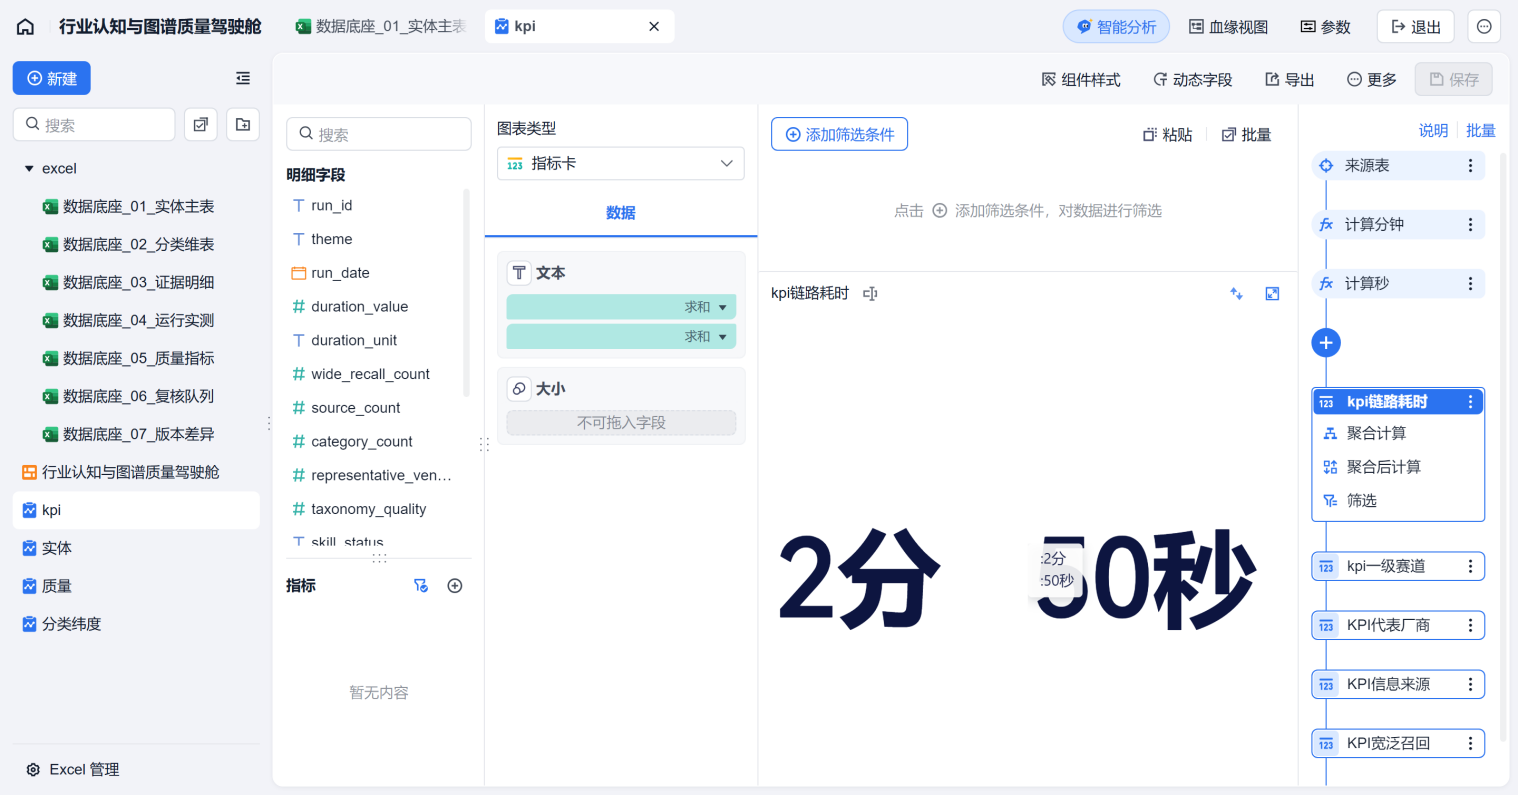
然后进行简单的数据处理,新增计算字段
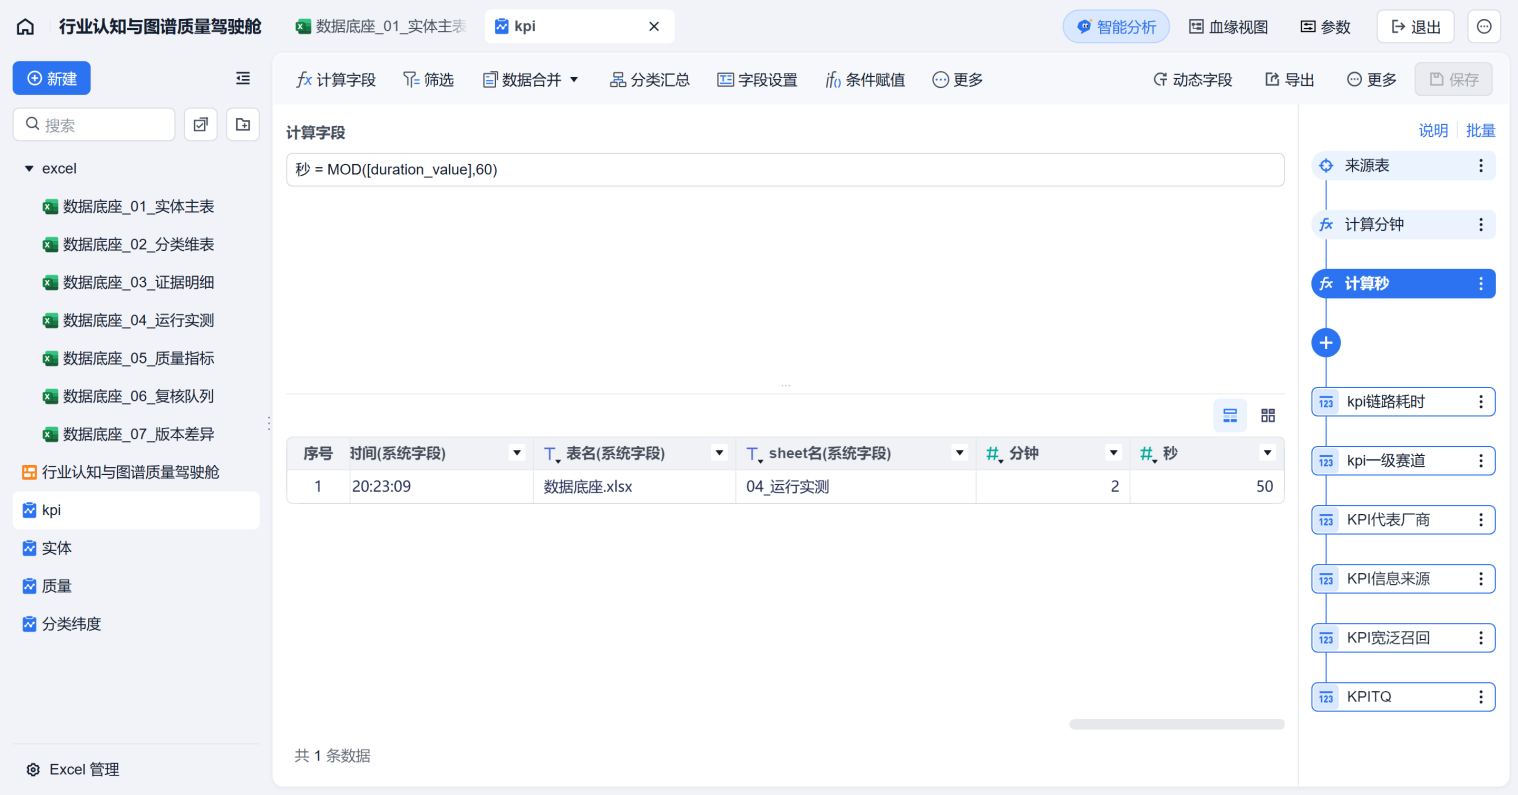
制作多个kpi组件
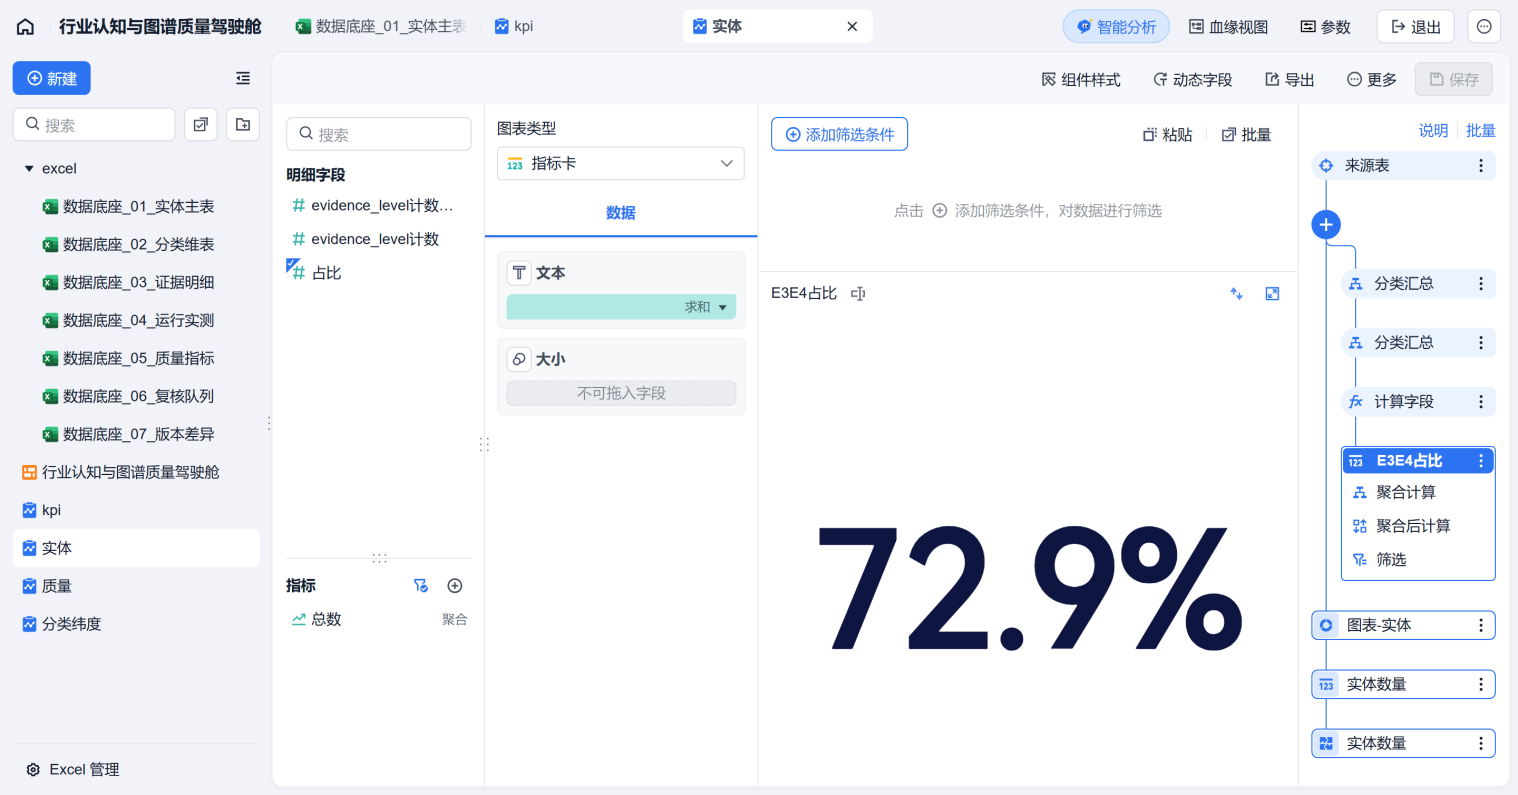
制作实体占比KPI组件
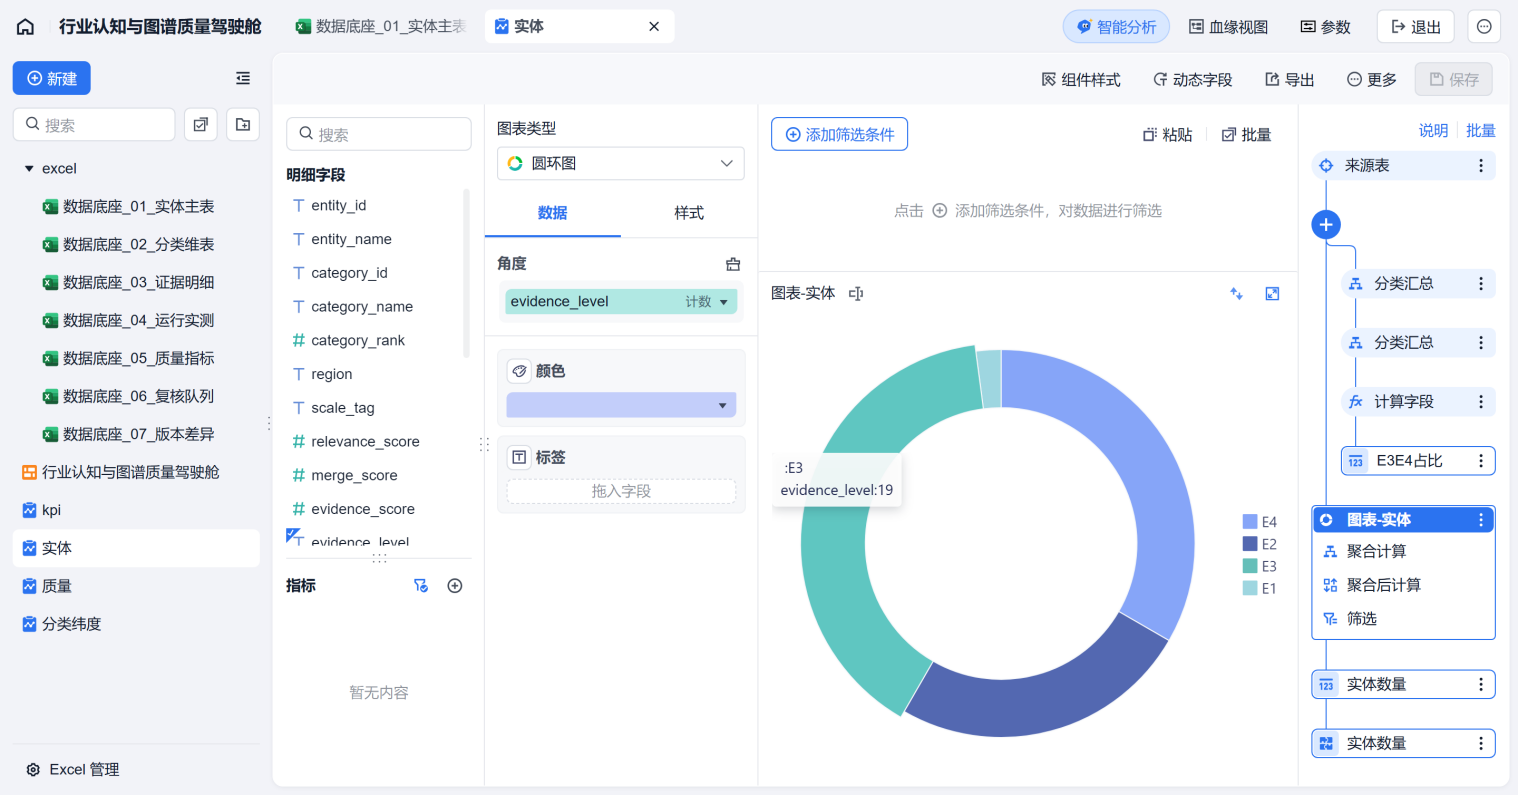
制作实体饼图组件。
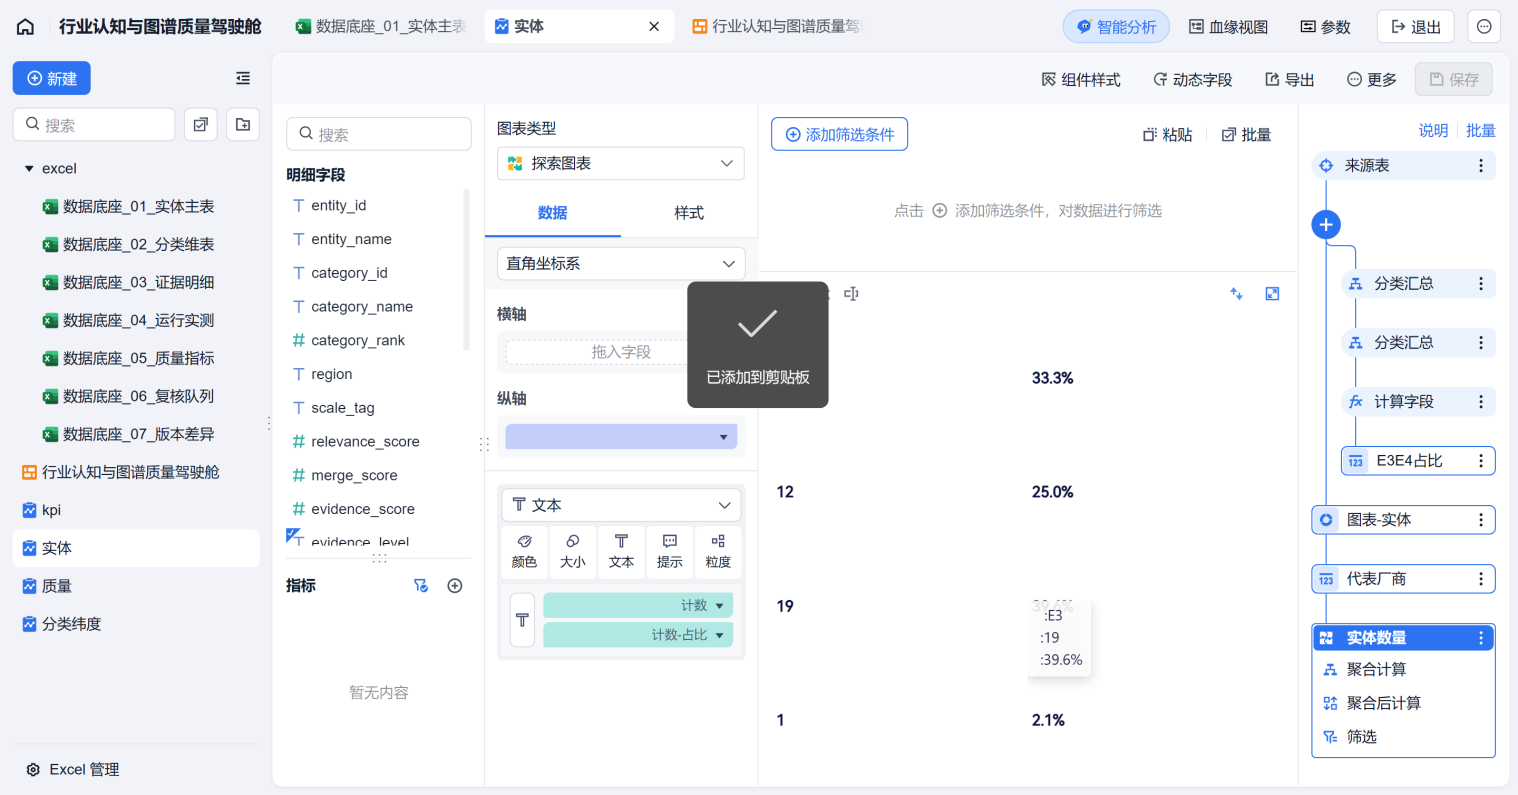
制作KPI组件展示占比。
制作质量条形图展示。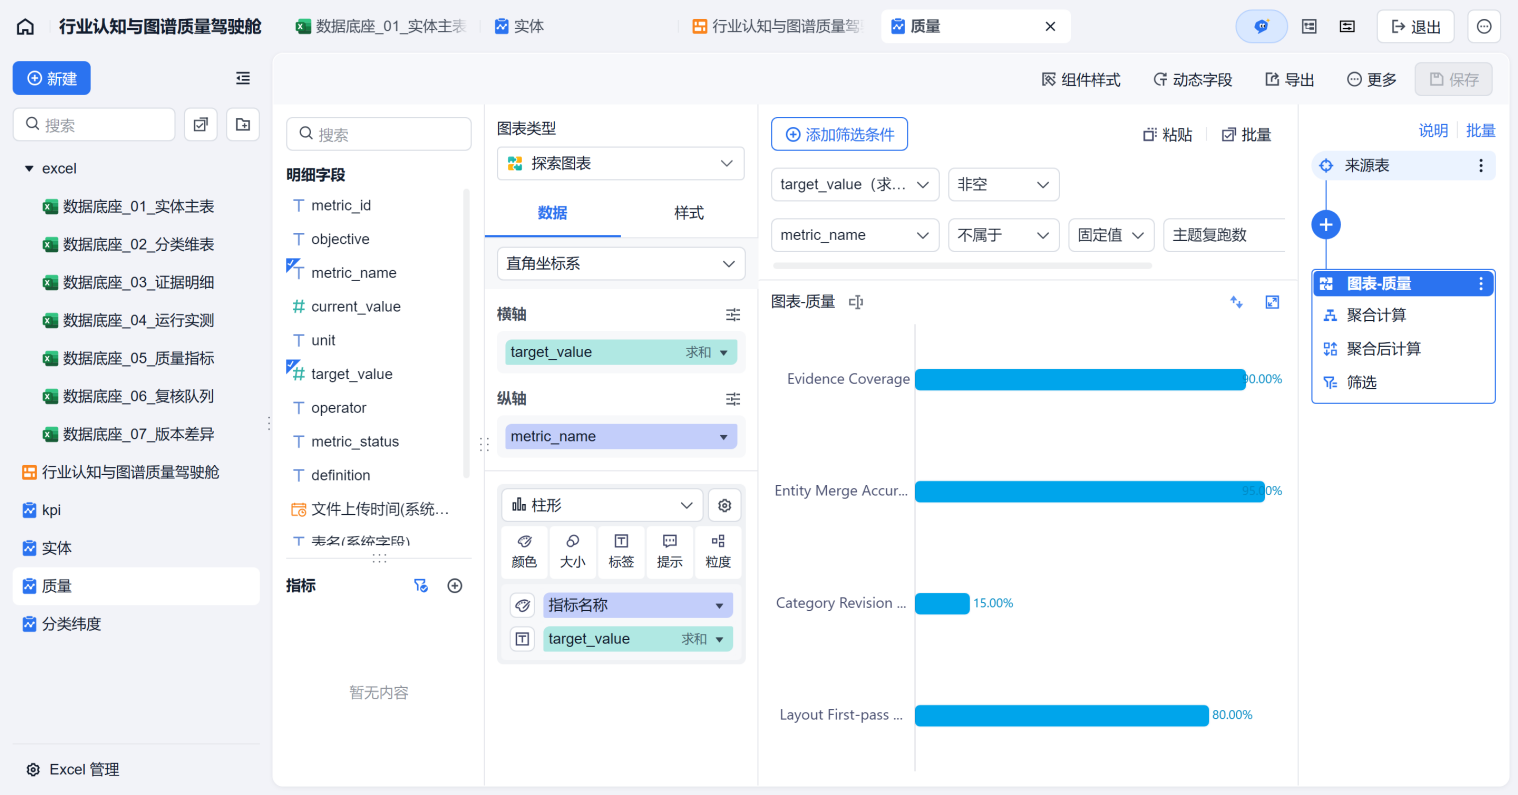
制作雷达图组件。
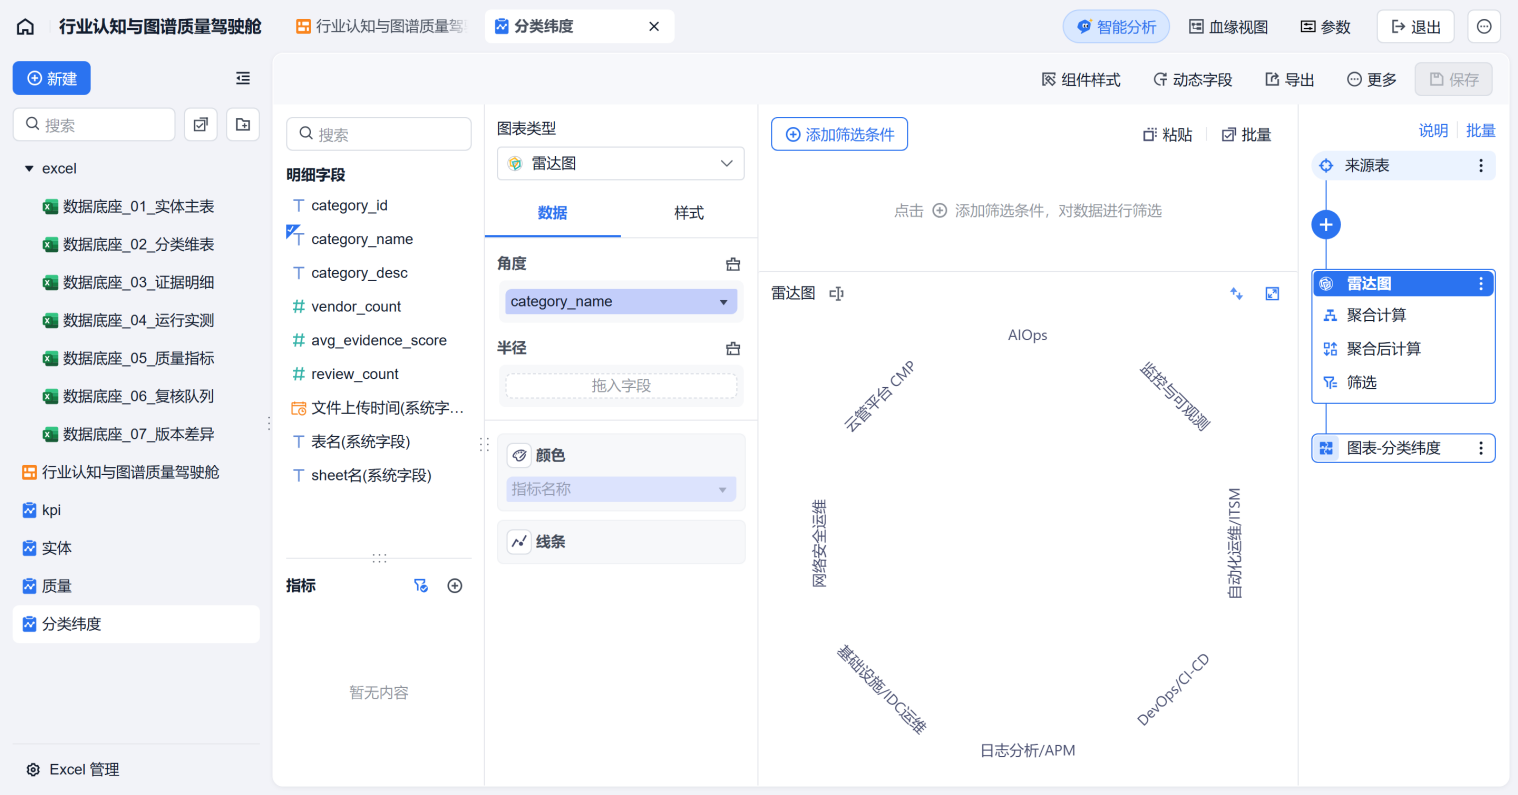
制作分类纬度条形图。
最后制作仪表板展示,调整背景图及项目说明。
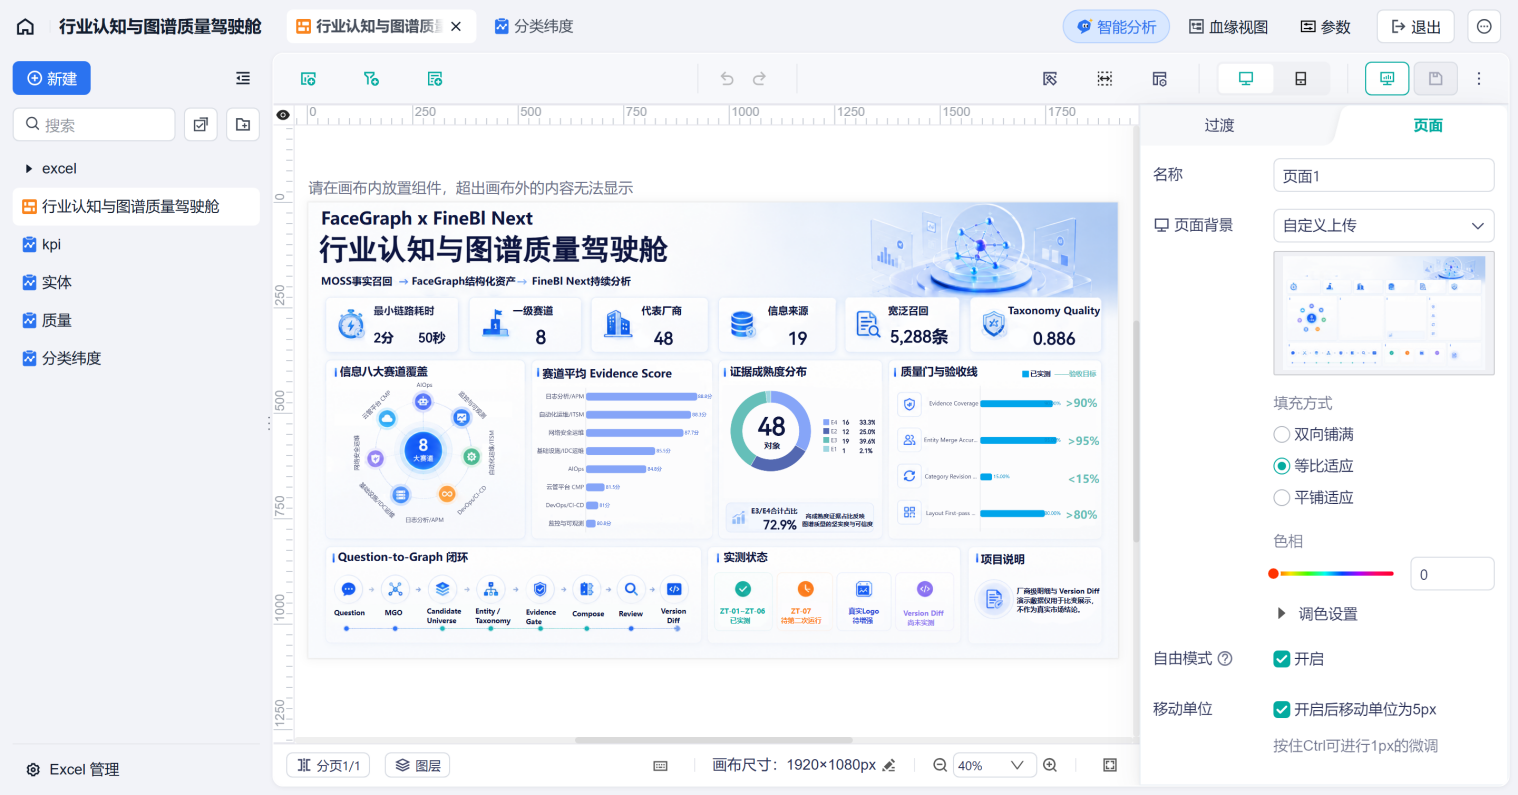
四、价值量化
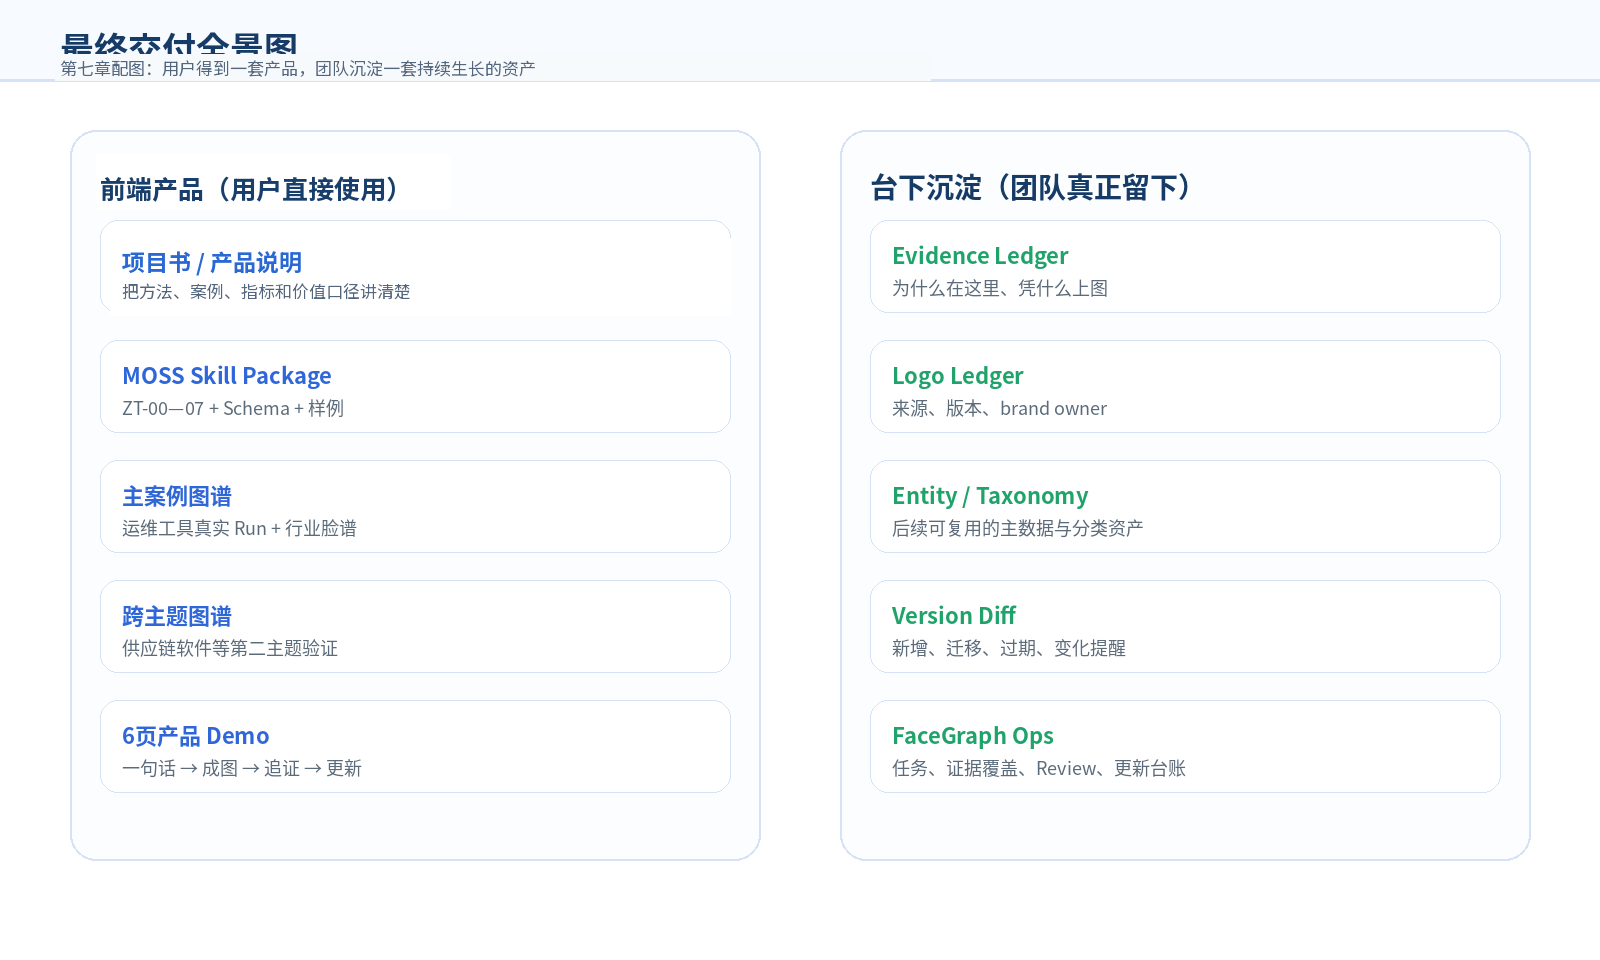
图7 最终交付全景图:前端成果与后台资产如何对应
4.1 · VALUE
“纸上得来终觉浅,绝知此事要躬行。” —— 陆游《冬夜读书示子聿》
价值验证先统一口径:已经测得的数据标为实测,预期达到的数据标为目标,尚未验证的内容放入验证计划。展示方式可以优化,数据口径不能混用。
4.1.1 核心业务价值
• 更快形成行业全景:本次 MOSS 实测中,运维工具图谱最小可运行链用时 2分50秒。这个数字是跑出来的,不是拍脑袋。
• 更完整地发现对象:宽泛关键词先捞出 5,288 条噪声,再靠多路召回和相关度筛选,最后收敛为 8 个赛道、48+代表厂商。先把海捞一遍,再挑能上桌的。
• 更容易解释结论:Evidence Ledger 把“为什么它在这里”从临场发挥,变成可以直接翻账本的结构化答案。
• 更适合持续观察:同一 MGO 重跑形成 Version Diff,行业研究从“一张截图”升级成“会继续长的版本资产”。
4.1.2 管理效率价值
• 一个人带六个虚拟研究角色:市场侦察、实体校准、行业架构、证据审计、信息设计、情报管理。人没变多,分工先变清楚。
• 人工时间只花在争议项和高影响节点上;重复搜索、复制粘贴、格式整理这些体力活,尽量交给 Skill。
• 统一 MGO、Review Queue 和发布状态,让不同团队少一点“我这版和你那版怎么又不一样”。
• MOSS / FaceGraph 负责发现与生成,Review Queue 承接复核动作,串起“发现 → 复核 → 修订 → 发布 → 再观察”。红灯亮了,后面必须有人处理。
管理上的小确幸也很具体:以前问“谁改了这张图”要靠大家努力回忆;以后翻 Version 和 Review Log 就行。人的记忆挺贵,尽量留给更重要的事,比如中午到底吃面还是吃饭。
4.1.3 数字资产价值
每次研究都会留下 8 类可计算资产:MGO、Entity、Taxonomy、Relation、Evidence、VisualAsset、Review、Version。图是给人看的门面,这些资产才是下一次还能接着干的地基。门面会过时,地基最好别丢。
• MGO:保存问题、范围、受众、数据策略和版本。
• Entity:保存企业、集团、品牌、产品的标准身份。
• Taxonomy:保存行业分类体系和分类规则。
• Evidence:保存上图依据、来源、时间和成熟度。
• Review:保存人工修订理由,让规则越来越懂业务。
• Version:保存新增、删除、迁移、改名和证据变化。
• VisualAsset:保存 Logo、品牌归属、版本和来源。
• Relation:保存上下游、品牌归属、招采、集团等关系。
4.1.4 价值验证口径|三种数字,三种标签
项目书中的数字统一分为已实测、验收目标和计算公式三类。2分50秒、19个信息来源、8个一级赛道、48+代表厂商属于真实运行结果;Evidence Coverage ≥ 90% 等属于下一阶段验收线;工时与成本节省采用公式计算。每个数字先标明身份,避免把当前成果、预期目标和推算结果混在一起。
|
标签
|
指标
|
数值 / 公式
|
口径
|
|
已实测
|
单轮生成耗时
|
2分50秒
|
本次 MOSS「运维工具图谱」真实 Run
|
|
已实测
|
信息来源
|
19个
|
MOSS 运行页面记录
|
|
已实测
|
结构结果
|
8赛道、48+代表厂商
|
本次图谱生成结果
|
|
已实测
|
召回噪音样本
|
宽泛“运维”5,288条
|
用于证明需求编译与去噪价值
|
|
验收目标
|
Evidence Coverage
|
≥90%
|
主图中具备有效证据对象 / 主图对象总数
|
|
验收目标
|
Entity Merge Accuracy
|
≥95%
|
Golden Set 人工确认样本
|
|
验收目标
|
Category Revision Rate
|
≤15%
|
专家复核后改类对象 / 已分类对象
|
|
验收目标
|
Layout First-pass Rate
|
≥80%
|
无需设计师大改即可发布的图谱比例
|
|
计算公式
|
研究节省工时
|
人工基线工时 - Skill运行时间 - 人工复核时间
|
按10个真实主题做 Before/After
|
|
计算公式
|
可复用价值
|
复用次数 × 单次重复制作成本
|
MGO / Taxonomy / Template 分别统计
|
一句不太学术、但很管用的话:目标值可以有野心,实测值必须有良心。数字最怕借别人的西装穿,站着挺体面,一走路就露裤脚。
4.2 Before / After|价值怎么计算
价值量化不直接拿“2分50秒”去和一个没有记录的人工流程硬比。先建立人工基线,再把 Skill 运行、人工复核和后续更新拆开计算;这样既能看自动化速度,也能看最后需要人花多少时间。
|
维度
|
Before:传统方式
|
After:FaceGraph方式
|
当前口径
|
|
研究耗时
|
跨源搜索 + 去重 + 分类 + 核验 + 排版
|
Skill运行 + 人工复核 + 发布
|
已实测最小链路 2分50秒;人工基线待采集
|
|
对象覆盖
|
人工名单与经验补充
|
Candidate Universe 多路召回后再筛选
|
首轮收敛为 8赛道、48+代表厂商
|
|
证据追溯
|
来源散在正文/聊天记录
|
Evidence Ledger + Evidence Score
|
结构已输出;Evidence Coverage 验收目标≥90%
|
|
版本更新
|
重新搜索、重新对两版
|
同一 MGO 重跑 + Version Diff
|
ZT-07 需第二次同主题 Run 复测
|
核心公式:研究节省工时 = 人工基线工时 − Skill运行时间 − 人工复核时间;研究耗时下降率 = 研究节省工时 ÷ 人工基线工时;人力成本节省 = 研究节省工时 × 人时成本。
4.3 · OBJECTIVES & ACCEPTANCE
成功标准就看六件事:找得全、分得准、证得清、排得美、更得快、能复用
项目把质量拆成覆盖、实体、证据、视觉、更新和复用六类指标,既用于 Before/After 对照,也用于后续运行的持续质量管理。
|
目标
|
定义
|
核心指标
|
建议验收
|
|
O1|找得全
|
核心厂商与长尾代表对象覆盖充分
|
Coverage@K、新发现率、候选全集规模
|
专家名单 / 公开榜单 / 历史图对照
|
|
O2|分得准
|
公司-品牌-产品与多标签分类合理
|
实体修订率、分类一致性、NEED_REVIEW率
|
双人抽检 + 业务专家复核
|
|
O3|证得清
|
每个关键卡片都有来源与纳入理由
|
Evidence Coverage、可追溯率
|
随机点选10个对象回溯证据
|
|
O4|排得美
|
自动生成可直接用于业务研判的专业图
|
一次通过率、人工排版时长、设计盲评
|
设计评分 / 用户盲评 / 修改轮次
|
|
O5|更得快
|
同一主题可按时间自动更新
|
变化捕获率、版本对比耗时
|
30/60天后自动重跑并核验Diff
|
|
O6|可复用
|
跨主题复用同一生成机制
|
模板复用率、行业迁移时间
|
至少3类不同主题复跑
|
4.4 · METHOD & TRANSFERABILITY
方法论沉淀|FaceGraph 留下的不只是一张图,而是一套可迁移研究方法
FaceGraph 的可复用核心不是某个固定行业分类,而是 Question → MGO → Universe → Entity → Taxonomy → Evidence → Compose → Review → Version 这条方法链。跨主题时保留 Schema、Gate、Evidence 口径、Review 机制和视觉模板,只替换主题范围、行业规则与分类先验。
可迁移价值分三层:第一层复用流程,避免每次从搜索框重新起跑;第二层复用资产,MGO、Entity、Evidence、Version 能继续积累;第三层复用质量标准,用同一套覆盖率、实体准确率、证据覆盖和分类修订率做跨主题验收。
现阶段已经证明“运维工具图谱”的最小链路可跑;跨主题复用与 Version Diff 仍按项目书原有验证计划继续复测。这里把“已经做到”和“下一步要验证”分开写,避免把工程设想提前包装成结果。


