知行 ZhiXing
AI 知行合一学习智能体
学习科学解释、课程使用方式、工程假设与真实场景实践
从“知道”到“会用”:先解释学习机制,再讨论 AI 如何提供外部支架
尝试把已有学习科学发现转成可观察、可检验的学习过程,并把尚未验证的部分明确标成工程假设。
2026 年 8 月 · V11.0
摘要
知行 ZhiXing 是一个面向学习过程的智能体。它从一个常见现象出发:一个人可能知道学习重要,却迟迟没有开始;可能看过很多内容,却无法独立提取;可能短期答对,过一段时间又忘;也可能在练习题中表现不错,换到真实工作却不会使用。本文不把这些现象简单归因于“懒惰”或“意志力不足”,而是分别从努力成本、任务感知、认知负荷、注意漂移、元认知错觉、遗忘与迁移等研究方向解释。
在工程层面,项目把这些研究线索转成一组可执行干预:缩小首次任务、减少一次输入的信息关系、要求学习者主动提取、安排跨时间复测、逐步减少提示、把知识放入真实任务中检验。这里必须区分三类内容:已有实验研究直接支持的学习效应;由相关研究推导出的设计原则;以及知行项目自己提出、仍需验证的工程假设。18 个 Skill、E0-E5 证据等级、KAG、学习行为模型和 Human Judgment Gate 都属于第三类,不应被写成已经得到科学验证的结论。
因此,同时承担四个功能:用科普语言解释学习现象;给出相应的科学证据与边界;说明如何把研究机制转成可测试的 AI 学习流程;最后说明不同知识源、真实材料和平台能力在工程实现中的位置。MOSS 只在适合的企业与商业学习场景中作为可选材料与分析环境之一,不构成学习科学的理论基础,也不是知行成立的前提。 对普通学习者而言,知行可以从一门课程、一份教材或一个工作能力目标开始:有指定教材时以教材为主源,没有教材时也可以先建立通用学习框架,再逐步补充材料。
关键词:知行合一;学习科学;努力成本;主动检索;间隔学习;学习迁移;AI 学习支架;Agent
一页看懂知行
|
项目项
|
解释
|
|
项目名称
|
知行 ZhiXing——AI 知行合一学习智能体
|
|
解决的问题
|
知道学习重要,却开始不了、坚持不了、记不住、用不上
|
|
核心用户
|
职场学习者、考试学习者、专业能力提升者、终身学习者
|
|
核心观察单位
|
一次可观察的 Learning Action:用户在具体时间完成的一项学习行为
|
|
过程模型
|
区分学习现象 → 选择干预 → 用户行动 → 记录结果 → 延迟复测/迁移验证
|
|
真实世界来源
|
用户文件与真实项目、教材/题库、公开或经授权知识源;在企业与商业学习场景中,可按需接入 MOSS 作为真实材料与分析环境之一
|
|
内部证据框架
|
E0-E5:用于组织从口头知道到陌生场景表现的证据;尚需效度验证
|
|
建议观察指标
|
TTA、首步完成、主动提取、延迟保持、真实任务、迁移、提示依赖
|
|
工程原型
|
主 Agent、可测试 Skill、学习界面、状态数据、评估方案;可部署在具备 Agent/Tool 能力的适当环境中
|
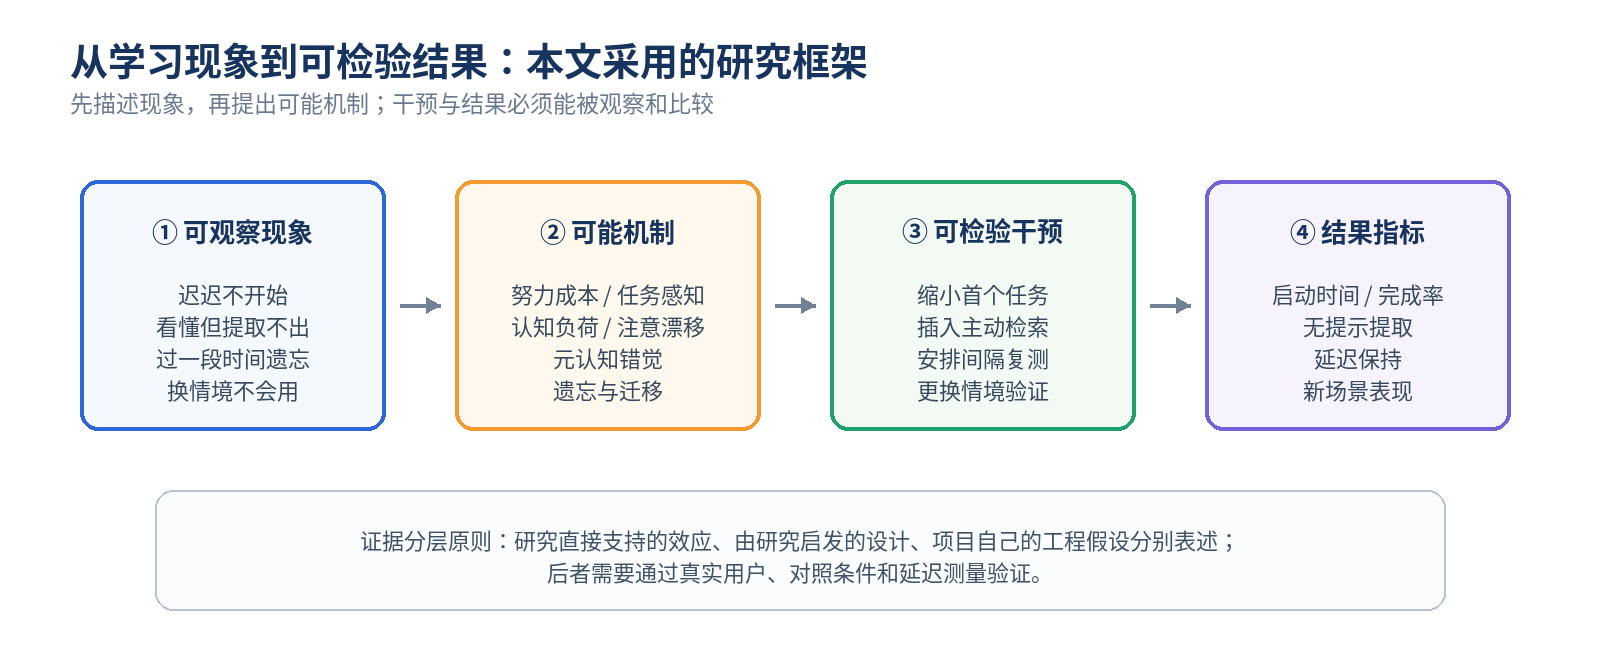
研究框架:把可观察现象、可能机制、干预和结果证据分开
|
工程分层
学习科学/认知科学解释机制;知行负责把机制转成可测试的学习任务和证据;织界等工具可提供知识结构;用户文件、真实项目、公开或授权资料以及 MOSS 等按场景提供真实材料。MOSS 是可选的工程输入,不是学习机制来源。
|
目录
01 从科学问题开始:为什么“知道”不等于“会做”
02 学不进去:六个真实的学习断点
03 从研究结论到工程干预:哪些有证据,哪些仍是假设
04 跟着小陈走一遍:30 天如何从想学到会用
05 怎样证明“真的学会了”
06 真实世界为什么重要:MOSS 在知行中的边界与作用
07 从上传一本教材开始:普通人到底怎么使用知行
08 工程实现:1+6 Skill 架构与学习状态数据
08 悟道平台部署与实测
09 怎样建设、验收与控制风险
结语 AI 不替你知,也不替你行
附录 科学依据、术语与项目边界
01 从科学问题开始:为什么“知道”不等于“会做”
“知道”“认得”“能回忆”“会判断”“会应用”“能迁移”并不是同一个心理过程。本文先把这些层次拆开,再讨论 AI 能否在其中提供外部支架。
1.1 “会了”不是一个二元状态
学习者看到答案时产生的熟悉感、在没有提示时独立回忆、在相似问题中判断、在真实情境中应用,以及在陌生情境中迁移,要求的加工深度并不相同。Koriat 与 Bjork 关于元认知错觉的实验表明,学习阶段可见的线索会使人高估之后独立提取的能力;Roediger 与 Karpicke 的实验则显示,主动检索本身能够改善之后的长期保持。因此,“看懂了”只能算一种学习状态,不能直接等同于“会了”。
课程完成率、阅读时长和 AI 对话轮数可以描述学习活动,却不能单独证明能力。若要讨论“学会”,至少需要观察:能否在没有答案时提取、隔一段时间是否仍能提取、提示减少后能否完成、换到新任务是否仍能使用。本文后面的 E0-E5 只是把这些观察组织起来的内部量表,不是已经验证的心理测量工具。
1.2 王阳明提供问题框架,不提供实验结论
王阳明“知行合一”的启示:如果到了真实事情上仍不会做,所谓“懂了”还需要继续被检验
知是行之始,行是知之成。
“知行合一”在本文中主要承担一个哲学问题框架:如果一个人声称“知道”,但在真实事情上完全无法判断和行动,那么我们需要继续追问这种“知道”的性质。现代学习科学能够研究的是提取、保持、迁移、任务选择等可测过程;二者可以对话,但不能相互替代。
因此,用“知 → 做 → 证据 → 反省 → 再做”作为工程过程模型。它的作用是组织数据和学习任务,而不是宣称这就是大脑真实运行的神经环路。
1.3 为什么费脑子的事容易被推迟:努力成本与时间距离
王煜全《如果大脑骗了你,让 AI 还你真相》的价值主要在于把“明知长期有利,却仍选择眼前轻松”这个现象讲得直观。科学上更稳妥的说法是:人会对需要认知努力的任务进行主观成本评估。Johnson 与 Most 的实验发现,认知努力的时间位置会影响人对需要付出努力的选项的估值;Song 与 Schwarz 的实验还表明,处理流畅性会影响人对完成任务所需努力和时间的预测。
这类研究可以帮助解释一个常见现象:同样是“备考”,836 页教材和一道 20 秒判断题在开始之前就会产生不同的主观成本。但这并不证明所有拖延都由同一种机制引起,更不能把拖延直接解释成某种固定的大脑缺陷。
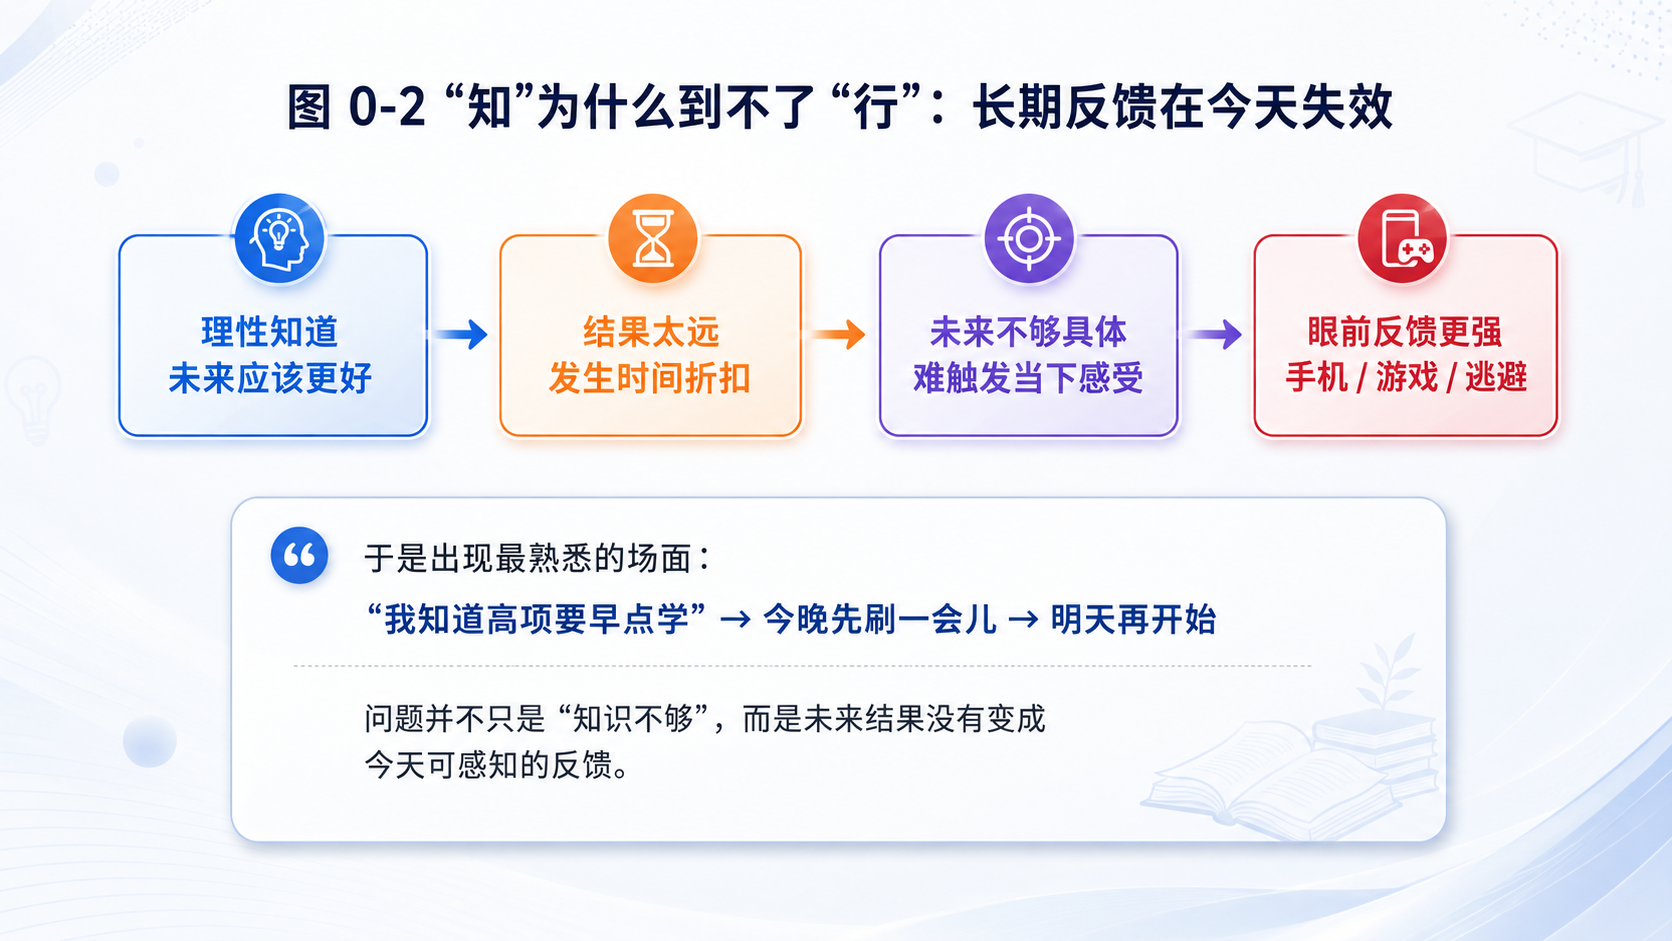
任务的即时成本与远期收益不在同一时间尺度上:图示是行为解释模型,不是神经机制图
因此,本文把“大脑骗你”仅当作科普比喻。正文尽量改用可测量的语言:任务规模、主观努力成本、处理流畅性、反应时间、错误率、提示需求、延迟保持和新场景表现。
1.4 AI 能做的是外部学习支架,不是读取大脑
AI 可以记录可观察的学习行为,例如任务是否完成、答题是否正确、用了多少提示、隔多久还能否提取;也可以据此选择下一项任务、生成新案例或提醒复测。但它无法直接知道用户“真实的认知状态”,只能根据行为数据做暂时推断。这样的推断需要允许被后续证据修正。
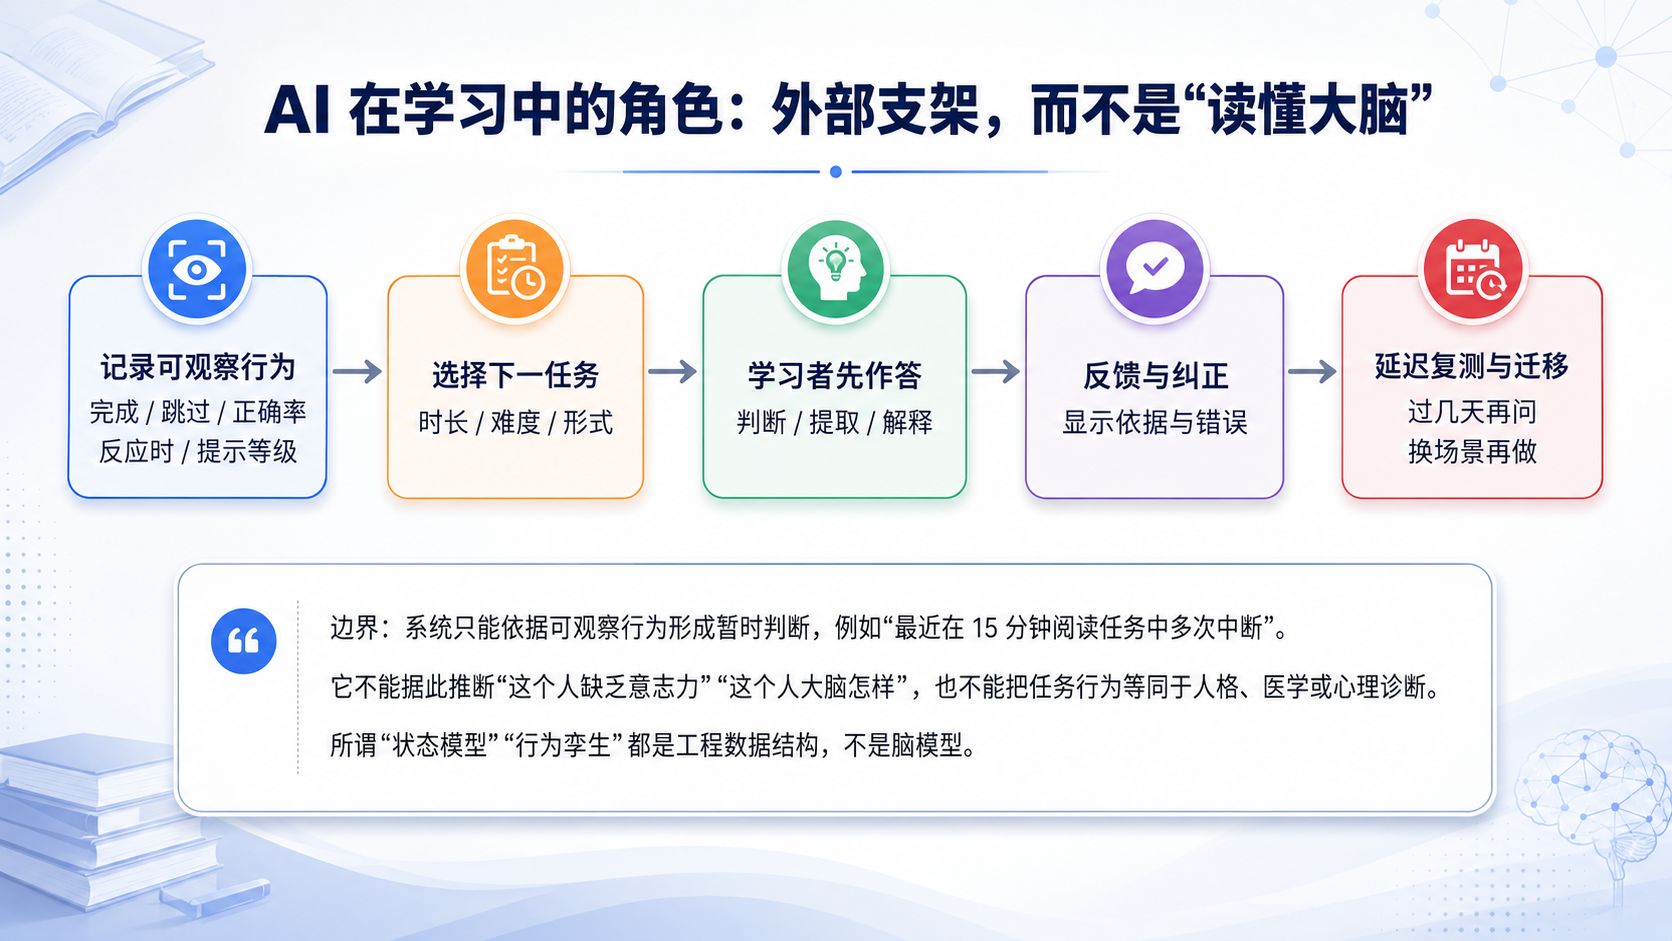
外部学习支架模型:记录行为、选择任务、让用户先作答、反馈、延迟复测;不是脑模型
02 “学不进去”的六种可能机制
同一句“我学不进去”可能对应不同机制。科学上更稳妥的做法,是先区分现象,再为不同现象设计可检验干预,而不是给学习者贴“懒惰”“自律差”的标签。
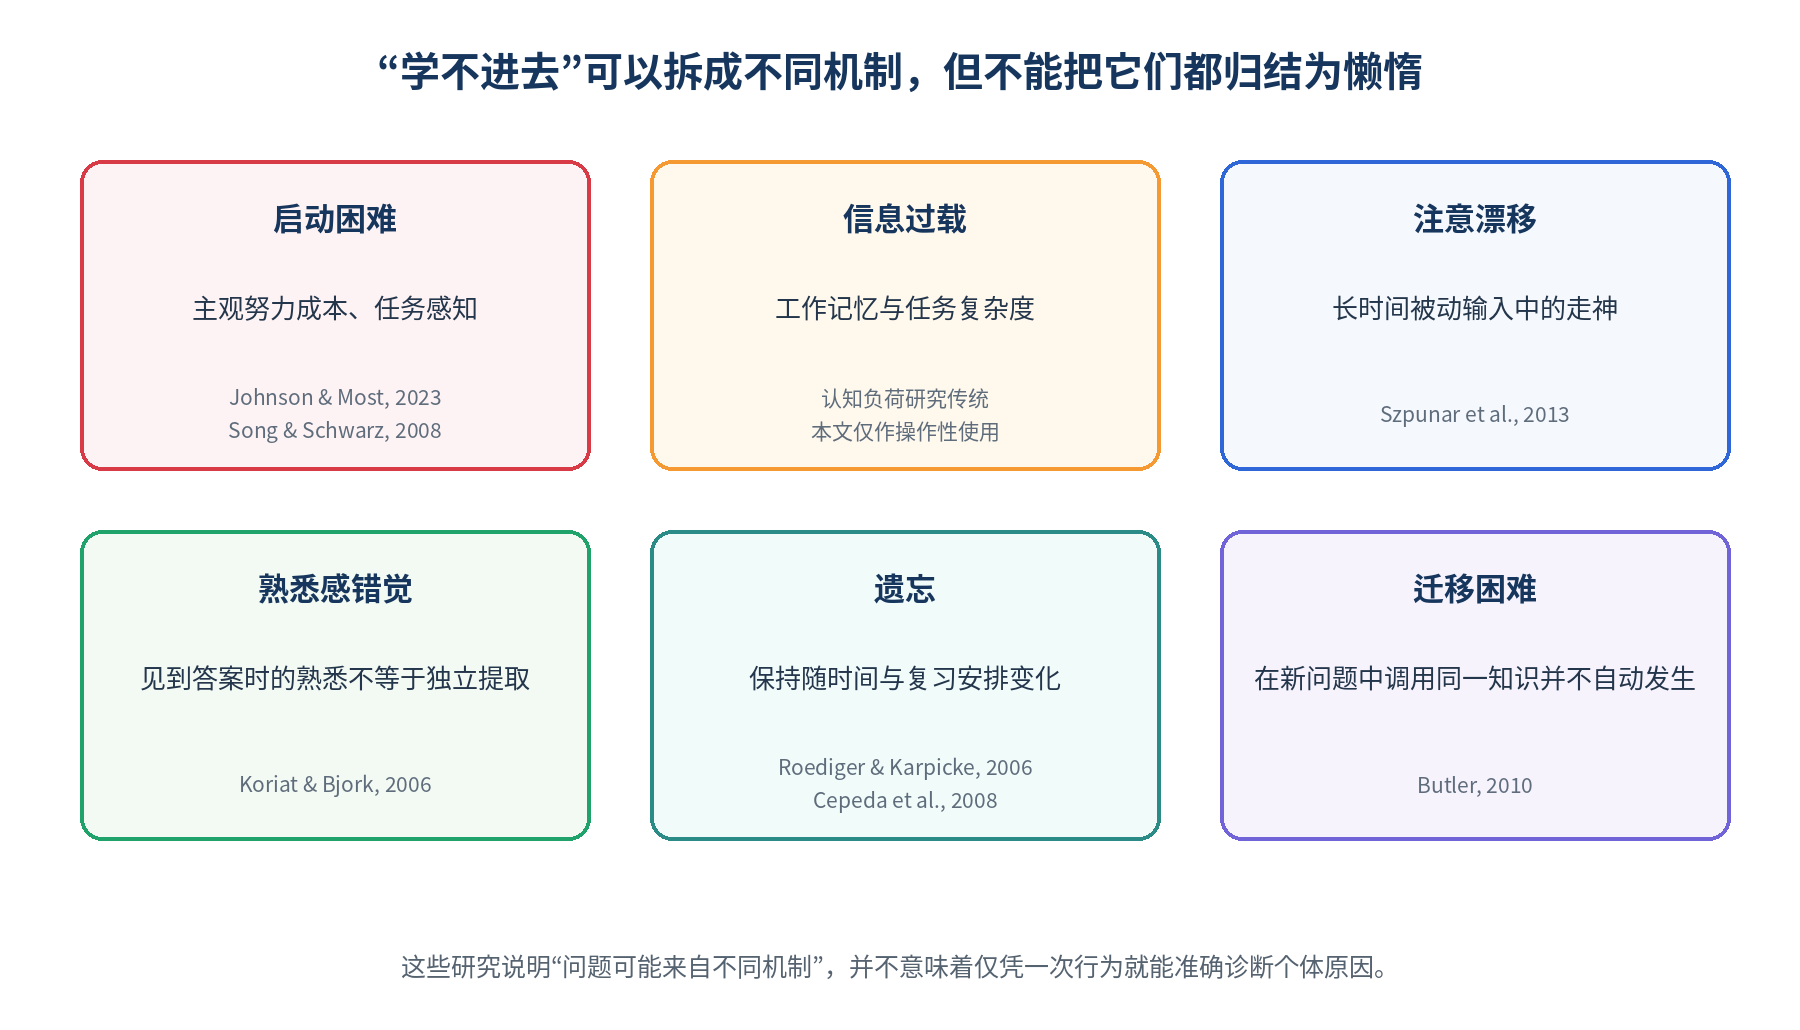
六类学习现象及其主要研究来源;它们不是对个体的医学或人格诊断
2.1 启动:还没开始,大脑已经觉得太费劲
面对一个规模很大的任务,人会在开始之前形成对努力、时间和成功可能性的预期。认知努力折扣和处理流畅性研究说明,任务被感知为更费力时,人可能降低选择它的意愿或高估完成所需时间。本项目把“先缩小任务”作为降低启动摩擦的工程假设,但具体能否提高学习启动率,需要在本项目中用对照试验验证。
|
可尝试的工程干预
识别任务规模、启动和不确定性等可观察阻力;把首个任务缩小到几十秒或几分钟。是否提高启动率,需要 A/B 测试。
|
2.2 过载:每句话都懂,合起来就乱
陌生概念、规则、例外和关系同时进入时,有限的工作记忆资源可能不足以稳定处理它们。这里不把“认知负荷”当成可由 AI 精确读取的数值,而把连续错误、反应变慢、提示需求上升等行为作为可能的过载信号。工程上可以尝试减少一次呈现的关系数、拆步骤或提供示例,并观察表现是否改善。
|
可尝试的工程干预
把连续错误、反应变慢、提示需求增加视为可能的过载信号;减少一次呈现的关系数,并观察表现是否恢复。
|
2.3 走神:人在屏幕前,注意力已经离开
被动观看并不保证持续注意。Szpunar、Khan 与 Schacter(2013)在在线讲授实验中发现,在讲授过程中插入记忆测试可减少报告的走神并改善学习表现。这个结果支持“长时间输入中加入短检索任务”的设计,但它来自特定实验情境,不能泛化为任何课程、任何人、任何频率的提问都一定有效。
|
可尝试的工程干预
在较长输入中插入短检索、判断或找错任务。该思路有特定实验支持,但频率和任务形式需要本项目验证。
|
2.4 错觉:看着眼熟,不等于能自己拿出来
学习者在看到材料时可能产生“很熟”的感觉,却高估没有材料时的独立提取能力。Koriat 与 Bjork(2006)把这类现象研究为元认知错觉;Roediger 与 Karpicke(2006)则显示,主动检索比单纯重复学习更有利于之后的长期保持。因此,系统应更多记录“能否自己拿出来”,而不是只记录“看过几遍”。
|
可尝试的工程干预
从完整提示逐步减到关键词提示,再到独立提取;核心记录是“无答案时能否拿出来”。
|
2.5 遗忘:今天会,不等于一个月后会
遗忘并不意味着学习失败,而是记忆随时间变化的正常结果。Cepeda 等人的间隔效应实验表明,复习间隔与最终测试的时间距离存在关系,并不存在一个对所有目标都固定最优的复习周期。因此,知行里的“间隔巩固”应根据目标保持时间和实际表现调整,而不是机械规定“每天复习”。
|
可尝试的工程干预
根据目标保持时间和实际提取表现安排再次出现;不存在对所有知识点统一的最佳间隔。
|
2.6 迁移:题会做,到了现实还是不会
迁移比在原题上答对更难,因为学习者需要在新情境中识别何时调用同一知识。Butler(2010)的实验显示,重复测试在部分任务上能够促进推断和迁移,相比重复学习表现更好。但“远迁移”一直是困难问题,因此项目不能因为用户做对了练习题就声称其具备工作能力,仍需用新的真实任务验证。
|
可尝试的工程干预
把用户文件、真实项目或新案例转成任务,用于迁移验证;真实材料本身不保证迁移。
|
|
学习断点
|
用户常见表现
|
可尝试干预
|
SKILL模块
|
|
启动
|
知道该学,但迟迟不开始
|
缩小第一步、降低预估成本
|
ZX-03 / 06 / 07
|
|
过载
|
每句都懂,合起来就乱
|
减少关系、拆步骤、给示例
|
ZX-08
|
|
走神
|
人在屏幕前,脑子早走了
|
短问、判断、找错、追问
|
ZX-09
|
|
错觉
|
看答案会,合上书不会
|
隐藏答案、主动提取
|
ZX-11
|
|
遗忘
|
短期会,时间一长只剩眼熟
|
间隔再现、先提取后反馈
|
ZX-12
|
|
迁移
|
题会做,真实工作不会
|
真实任务、陌生场景验证
|
ZX-10 / 13
|
同一句“学不进去”可能来自不同机制;合理的干预应针对任务状态,而不是针对人格下结论。
03 从研究结论到工程干预:哪些有证据,哪些仍是假设
学习科学给的是概率性的研究结果,不是一个可直接复制到所有人的“最佳学习算法”。本项目的做法是把证据较稳的原则保留下来,同时把自己的工程设计明确标成待验证假设。
3.1 “先做一个很小的动作”是工程假设,不是科学定律
小陈输入“我想学高项,但几百页书一直不想看”。项目会尝试先给一个 20 秒判断题,而不是先给 100 天计划。这样做的理论动机是降低即时任务成本并尽快获得一次可观察行为;但“20 秒”“3 分钟”等阈值不是学习科学给出的标准答案,而是原型需要通过实验调整的产品参数。
|
第一次学习行动
供应商告诉你:“下个月可能晚交两周。”这是:A 已经发生的问题;B 未来可能发生的风险?预计用时:20 秒。
|
如果用户完成了这一步,我们只能得到一个有限结论:他愿意开始,并在这个问题上作出了某个判断。它不能证明“最小行动法已经有效”,更不能证明用户已经掌握风险管理。后续还要观察第二步是否继续、延迟后能否提取、真实任务中能否使用。
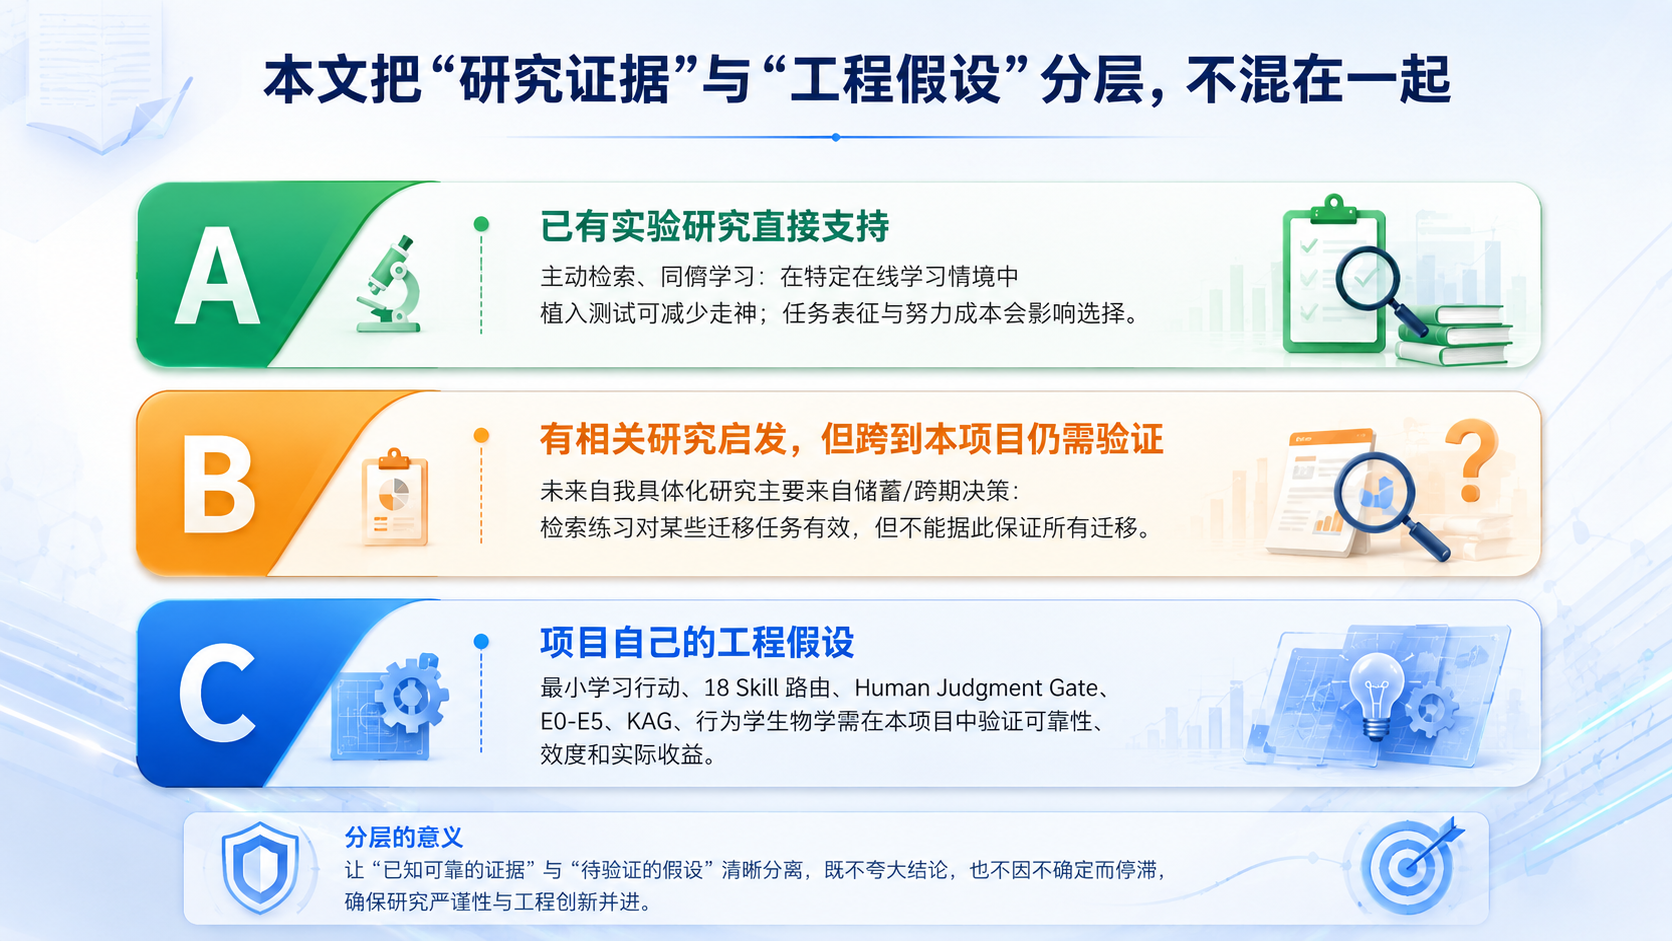
证据分层:研究发现、相关研究启发、项目工程假设需要分别表述
3.2 “学习状态机”是一种工程数据结构
系统可以维护目标、当前知识节点、最近任务、正确率、反应时间、提示等级、复测间隔、真实任务结果等数据。这些变量有助于决定下一任务,但它们并不等于对人的完整认知建模。
例如,系统观察到“风险识别模拟题连续正确,但真实项目里仍需要完整提示”,可以据此选择一个提示更少的真实任务。这样的路由规则是否真的优于固定课程路径,需要用实验数据比较。
3.3 下一学习行动是一组可测试的决策规则
|
工程决策变量
下一任务可参考:最近完成/跳过、错误率、反应时间、提示等级、复测间隔、真实任务结果、可用时间。这里不使用“神奇总分”,也不把这些变量解释成大脑状态。
|
阻力高:先缩小任务,不继续讲大计划。
认知负荷高:减少一次处理的关系数量。
注意下滑:切到短问、找错或判断。
提取弱:隐藏答案,让用户先自己想。
证据停在模拟:切换到真实任务。
间隔到期:换场景再次出现,而不是机械重读。
3.4 Human Judgment Gate 是工程控制规则,不是心理学术语
生成式 AI 很容易直接给出答案。如果系统把答案、判断和方案全部替用户完成,就很难再从结果中判断用户本人会不会。因此项目规定:凡是要形成能力证据的关键节点,优先让用户先判断、先解释或先产出;AI 再提供反馈、示例或补充。它的目的首先是保证“能力证据可观察”,而不是声称存在一种已被验证的通用学习门控机制。
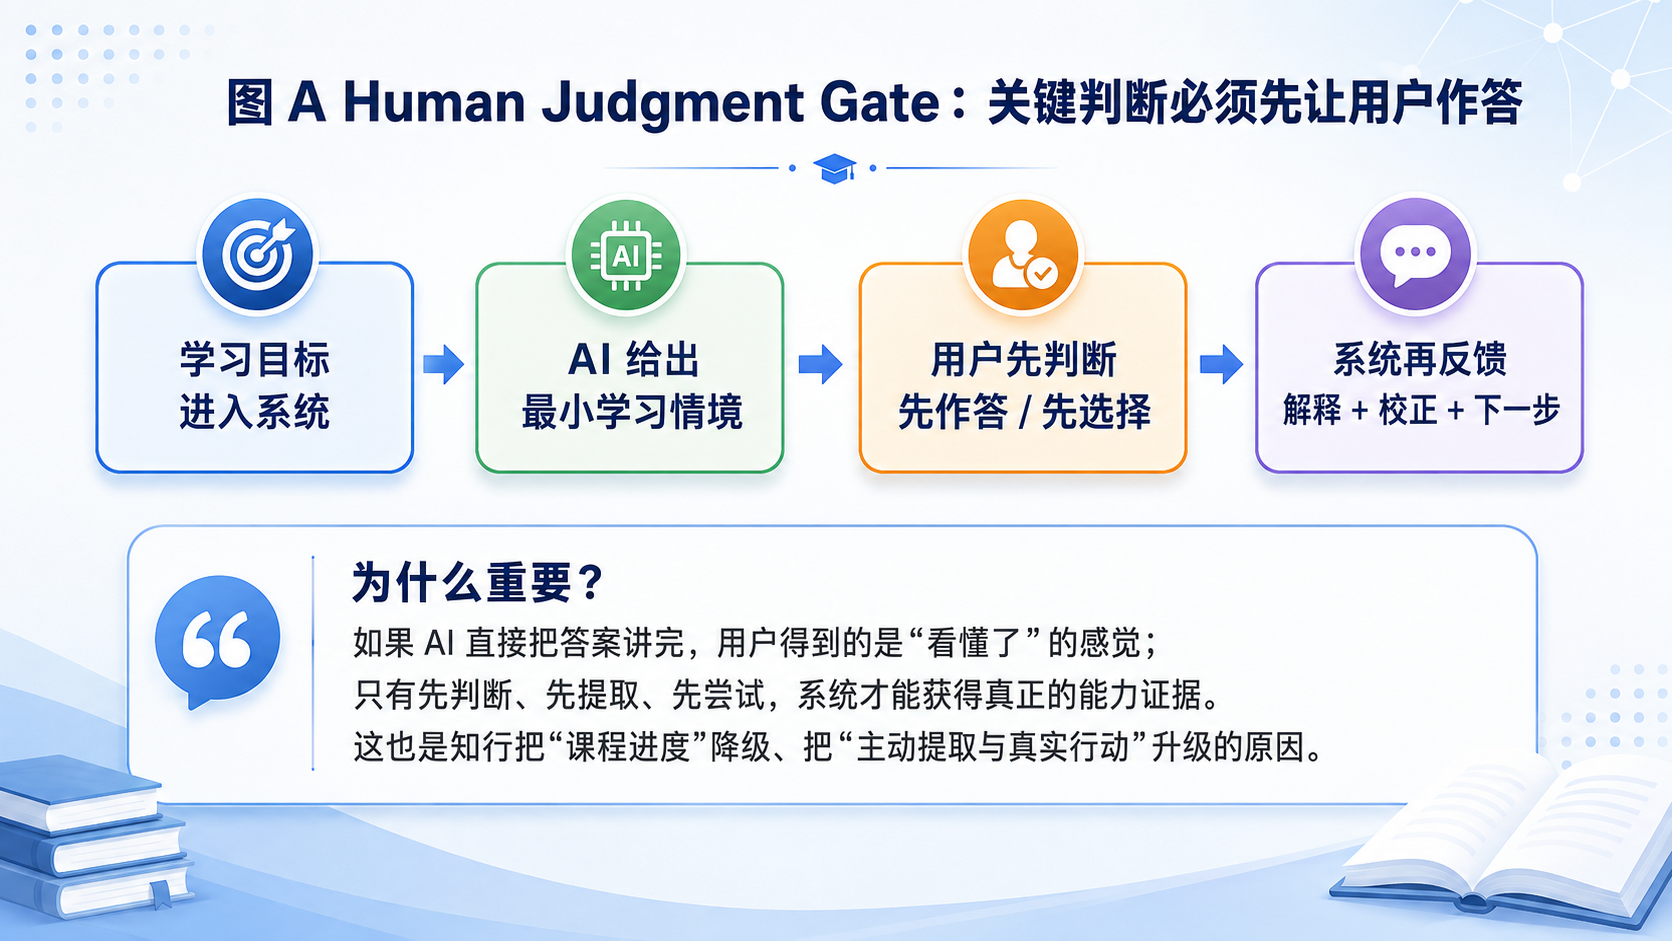
关键判断先由学习者完成,再提供 AI 反馈:这是为了保留可观察的能力证据
这条规则尤其需要在真实试验中验证代价与收益:它可能减少 AI 代答和过度依赖,也可能让部分任务变慢、主观体验下降。项目应同时测量学习结果和使用成本。
3.5 18 个 Skill 是软件模块划分,不是科学分类体系
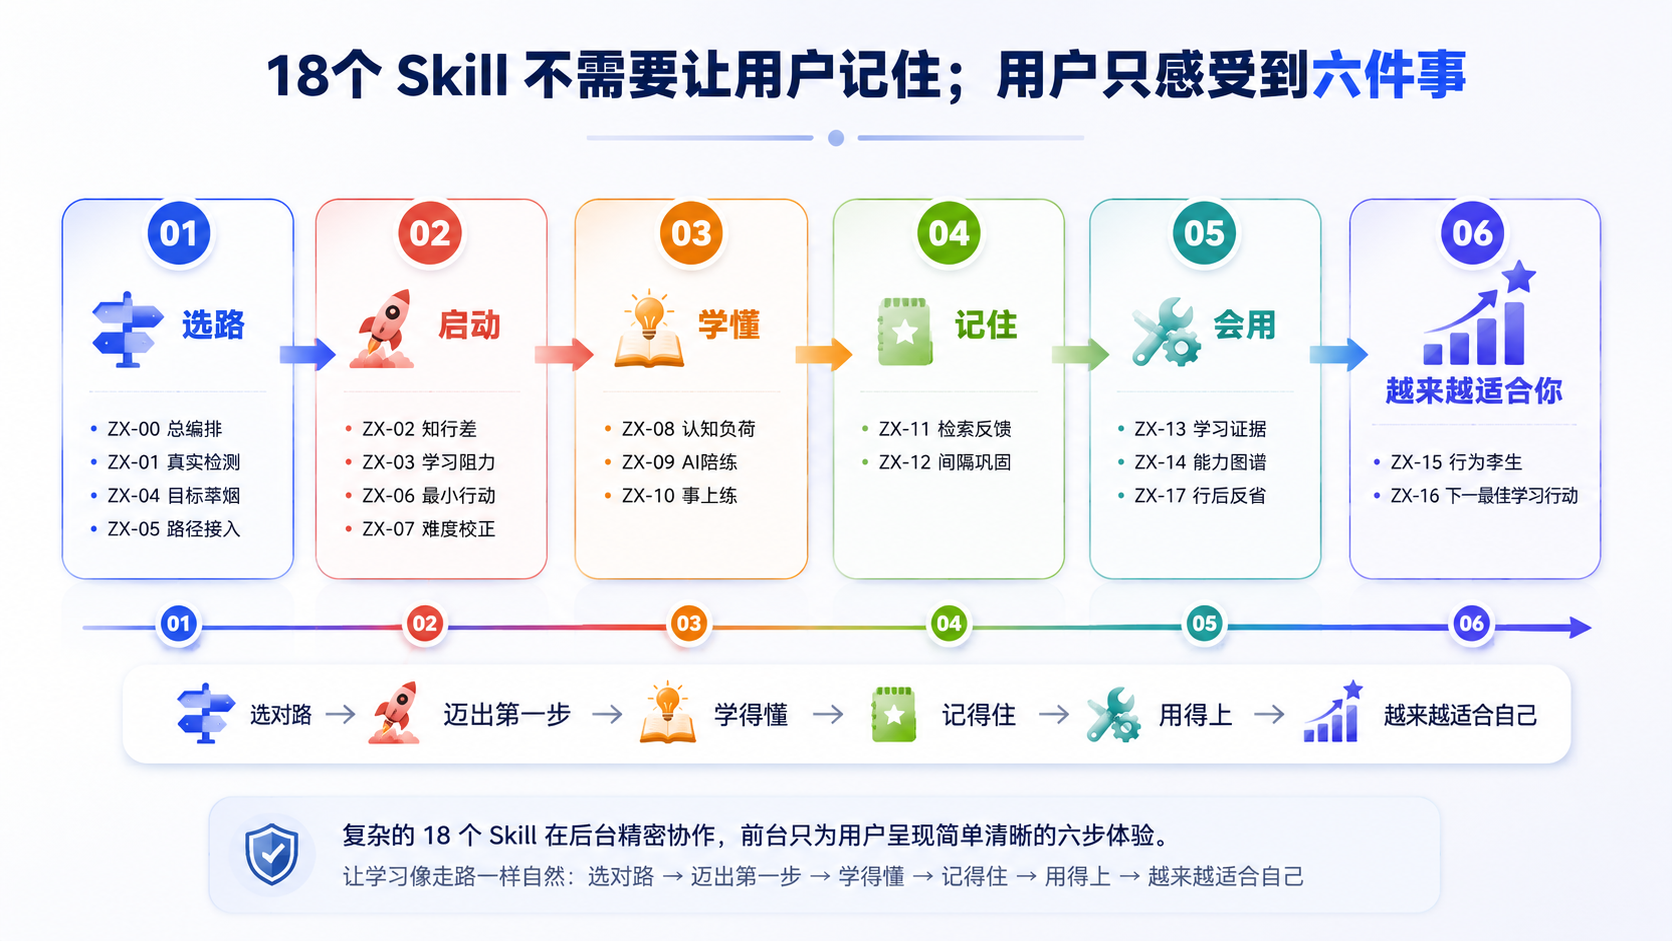
18 个 Skill 被组织成六段用户旅程:选路、启动、学懂、记住、会用、越来越适合自己
18 个 Skill 的作用是把目标澄清、任务生成、主动检索、间隔复测、真实任务、证据记录等功能拆开,便于测试和替换。它们的编号、数量和边界都是工程选择;后续完全可能根据实验结果合并、删除或重新划分。
04 30 天案例:演示机制如何组合,不作为效果证明
下面的小陈案例是“原型运行示例”,用于说明不同机制如何在时间上组合。Day 1、Day 7、Day 30 的结果是情景设定,不是已经完成的用户实验数据。
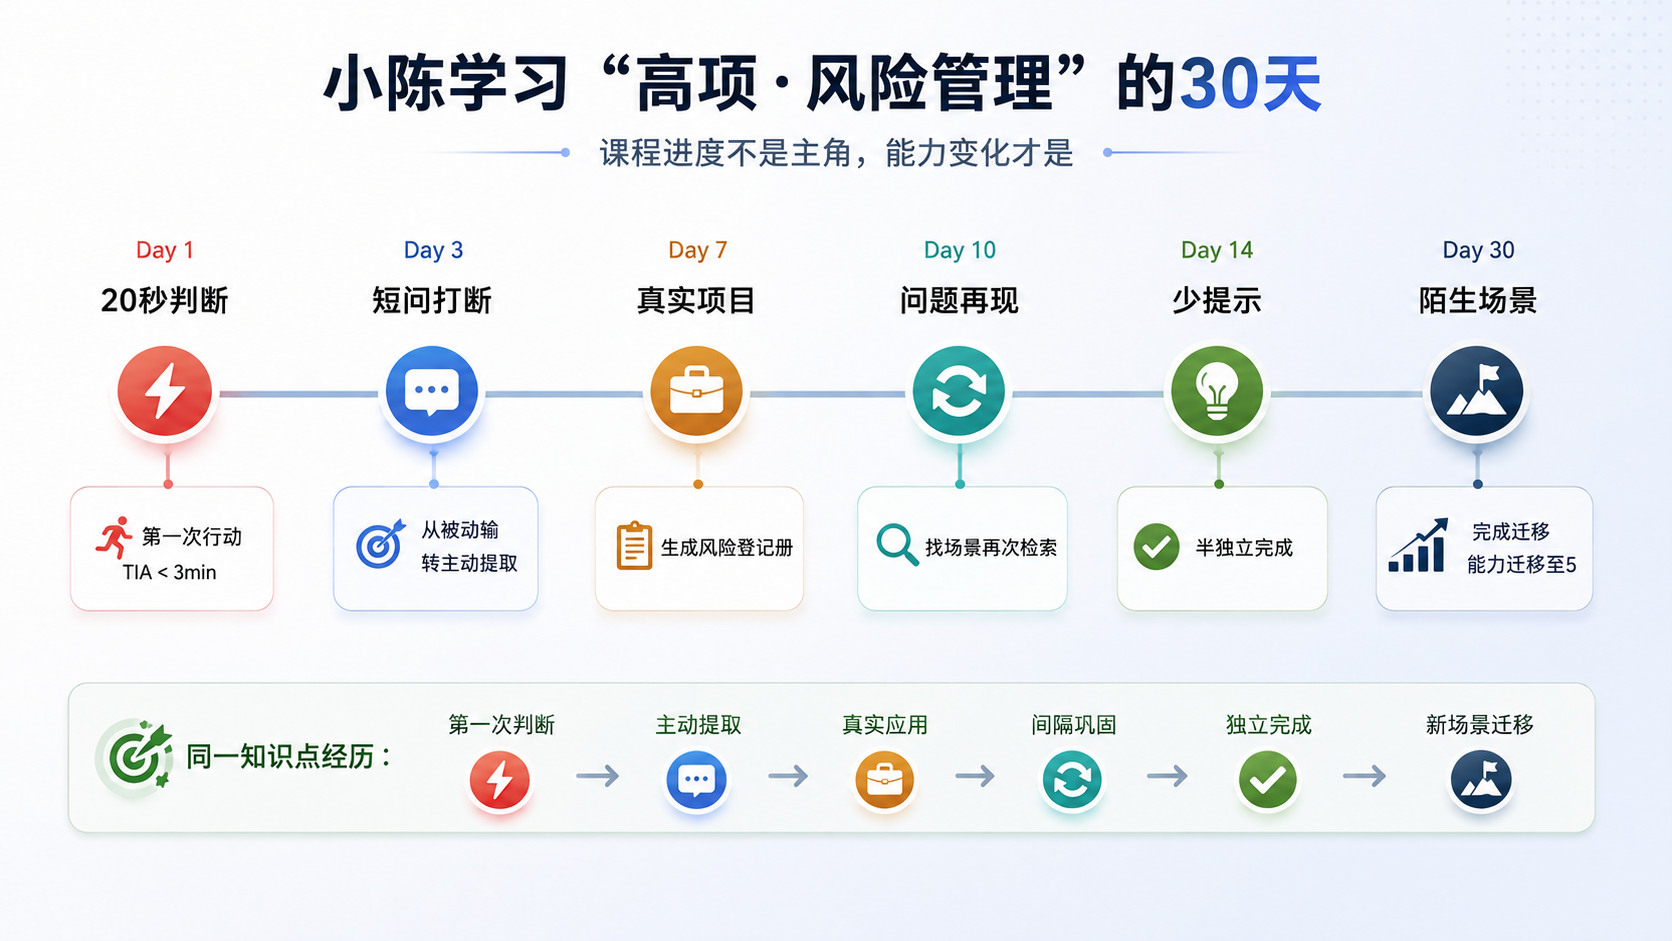
30 天示例:同一知识点经历启动、提取、延迟复测、提示减少和陌生场景验证
|
时间
|
发生了什么
|
系统为什么这样做
|
|
Day 1
|
20 秒判断“问题还是风险”
|
降低启动成本,先让 TTA 小于 3 分钟
|
|
Day 3
|
连续阅读反应变慢,改成两道短问
|
减少走神,把注意从“听懂”拉回“自己想”
|
|
Day 7
|
用自己的项目建立风险登记册
|
把模拟题推进到 E3 真实任务证据
|
|
Day 10
|
同一知识点以新场景再次出现
|
先独立提取,再给反馈,验证记忆保持
|
|
Day 14
|
AI 提示减少,只给边界条件
|
观察提示依赖是否下降
|
|
Day 30
|
换到从未见过的新项目场景
|
验证陌生场景迁移,决定能否进入 E5
|
4.1 错误的价值在于暴露当前规则,而不是简单记一条错题
假设 Day 14,小陈把“已经发生的问题”误判成风险。除了告诉他答案,系统还可以询问“你用了什么判断依据”,让错误暴露出当前的推理规则。这个设计与自我解释、反馈等学习研究有关,但 ZX-17 的具体做法仍需要验证。
因此,“把错误变成可迁移规则”在本文中是一项目标,而不是已被证明的效果。验证方式应该是:过一段时间换一个表达不同但结构相同的新场景,看用户是否仍会犯同类错误。
4.2 把远期目标变得更具体:一种来自“未来自我”研究的设计启发
Hershfield 等人(2011)在储蓄决策实验中发现,与未来自我形象互动会影响部分参与者的未来导向选择。这提示我们:把遥远结果变得更具体,可能改变当下决策。但该研究研究的是储蓄而不是学习,所以知行里的“未来情景推演”只能被写成跨领域设计启发,不能说成已经得到学习科学验证的方法。
|
科学边界
“未来自我”研究对跨期决策有实验启发,但其结果不能直接外推到学习。本文的未来情景只作为待验证设计,不用于预测个人必然结果。
|
4.3 从用户角度看,知行其实只有五步
说出目标:例如“我想真正学会 ISO14001”。
完成此刻的一步:系统尽量把第一次行动缩到几分钟以内。
得到反馈:先看自己的判断,再看解释和下一步。
隔一段时间重新提取:不是固定重看章节,而是换问题、换案例。
进入真实事情:用自己的文件、项目或业务场景证明会不会。
学习者看到的是若干学习步骤;18 个 Skill、路由和状态数据只是实现方式。
05 怎样测量“学会”:从活动数据转向学习证据
科学地讨论学习效果,需要把“做过多少”与“会了多少”分开。本文优先观察独立提取、延迟保持、提示依赖和新场景表现,但这些指标也需要明确评分规则、测量误差和任务难度。
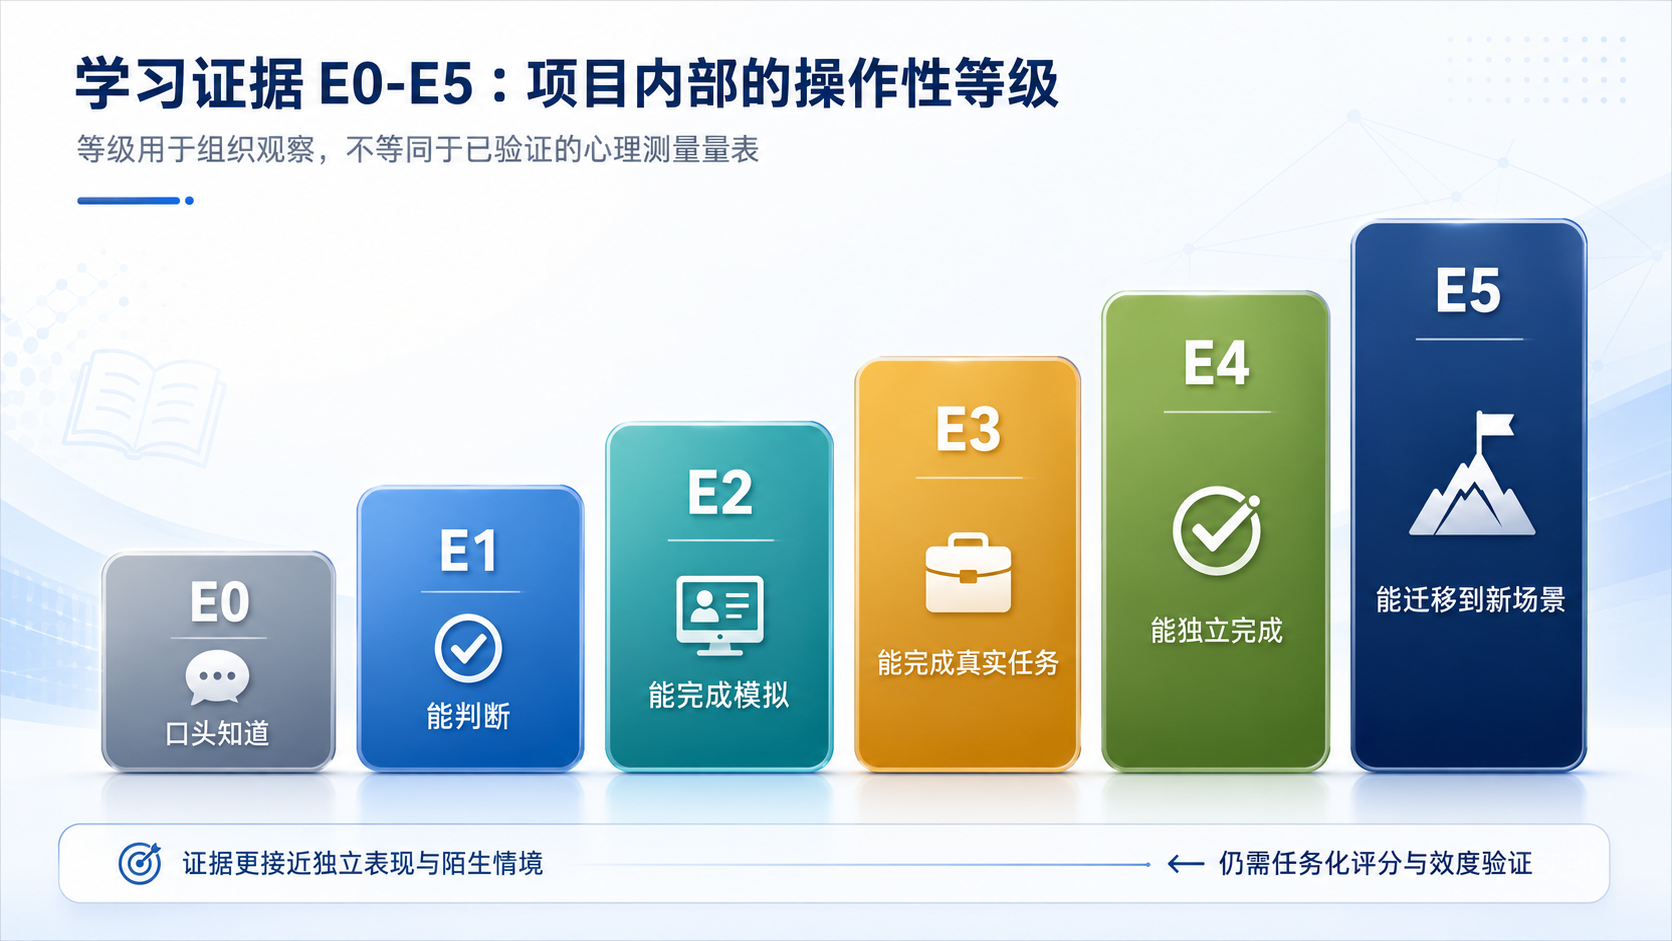
E0-E5 是项目内部证据等级,不是已经验证的心理测量量表
|
内部等级
|
操作性定义
|
示例(需任务化评分)
|
|
E0
|
口头知道
|
“我知道风险管理很重要”
|
|
E1
|
能判断
|
能正确区分风险与已发生问题
|
|
E2
|
能完成模拟
|
在案例题中完成风险识别
|
|
E3
|
能完成真实任务
|
给自己的项目建立风险登记册
|
|
E4
|
能独立完成
|
很少 AI 提示也能完成
|
|
E5
|
能迁移
|
换到陌生项目仍能正确应用
|
5.1 每条证据同时记录任务结果和 AI 提示程度
同样完成一个任务,照着 AI 的完整答案复述,和只在边界提示下独立完成,不能被视为相同能力证据。因此记录至少应包括任务类型、是否真实场景、提示等级、正确性、完成质量和是否为陌生情境。
E0-E5 的目的只是让这些证据有统一的工程表达。正式研究中仍需检验不同评分者的一致性、同一等级在不同任务上的可比性,以及该等级与之后真实工作表现是否相关。
5.2 指标既要看过程,也要看延迟结果
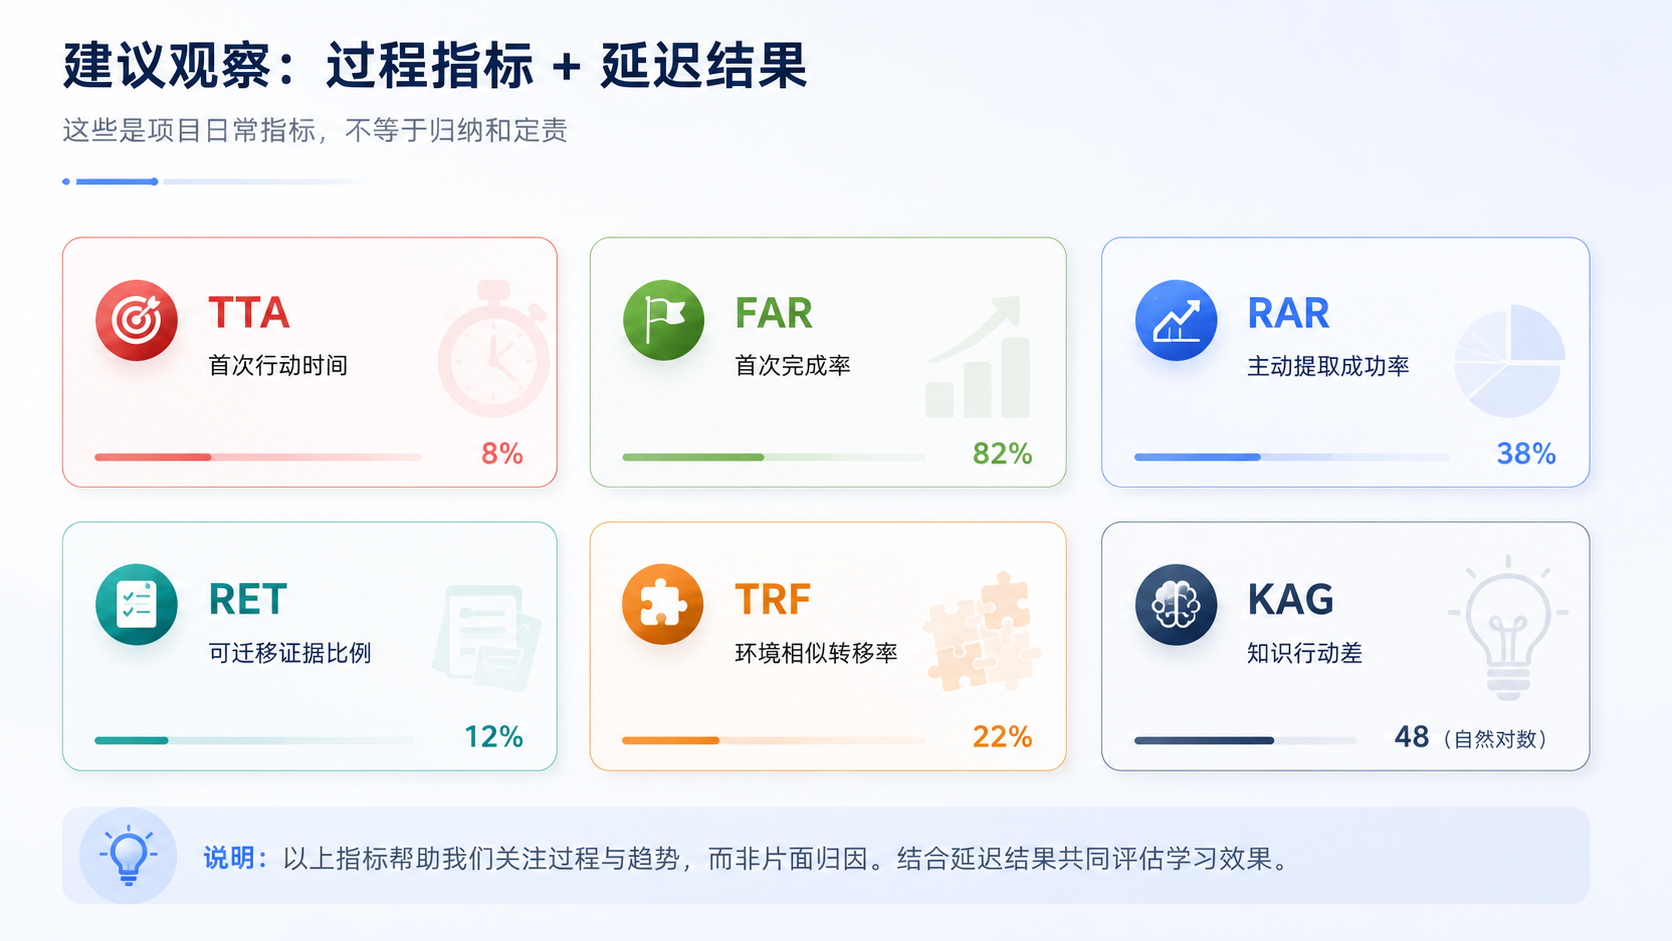
建议观察的过程与结果指标:启动、提取、保持、迁移和提示依赖
|
指标
|
代表什么
|
典型用途
|
|
TTA
|
从“我想学”到第一次真实学习行动的时间
|
衡量启动
|
|
FAR
|
First Action Rate,首步完成率
|
衡量第一步是否足够可做
|
|
RAR
|
Retrieval Accuracy Rate,主动提取成功率
|
衡量能否不看答案拿出来
|
|
RET
|
Retention,7/14/30 天保持
|
衡量跨时间记忆
|
|
TRF
|
Transfer,真实迁移
|
衡量能否在新场景应用
|
|
KAG
|
Knowledge-Action Gap,项目内部状态差异指标(非标准量表)
|
仅用于路由假设;公式、权重和效度需验证
|
5.3 先提出研究问题,再谈效果
|
研究问题
|
建议研究设计
|
主要观察变量
|
|
RQ1:缩小首次任务是否真的改善启动,并且不损害后续学习?
|
与“先计划/先讲解”方案做对比试验
|
TTA、首步完成率、第二步继续率
|
|
RQ2:主动检索 + 间隔复测在本项目任务中是否优于重复阅读?
|
在相同知识点上比较重复阅读与提取/间隔策略
|
7/14/30 天提取成功率
|
|
RQ3:用户先判断再看 AI 反馈,是否减少提示依赖并提高延迟表现?
|
比较 AI 直接给答案与用户先判断的任务
|
E3-E5 占比、提示依赖
|
|
RQ4:个性化路由是否优于固定路由?
|
观察多轮任务后完成率和时长选择的变化
|
同等时间下完成率、放弃率、提示依赖趋势
|
06 从上传一本教材开始:普通人到底怎么使用知行
知行的使用入口应该非常普通:我想学一门课、准备一个考试,或者真正掌握一项工作能力。教材是重要内容来源,但不是进入系统的门槛。核心不是“把书喂给 AI”,而是把课程内容变成可编排的知识结构,再依据学习者的实际表现决定下一步。
6.1 学一门课程,必须上传电子教材吗?
不必须,但如果用户希望严格按照某门课程、某一版教材或某个考试大纲学习,上传官方教材、讲义或指定资料通常是最稳妥的做法。教材在这里承担“内容基准”的作用:它告诉系统这门课的范围、术语、章节与版本。
有教材:以指定教材为主源建立课程模型;有教材和题库:同时建立知识结构与训练结构;只有工作文件:从真实任务反推需要掌握的知识;什么材料都没有:可以先用通用知识建立临时框架,但系统应提示其范围和版本不一定等同用户最终课程。
|
用户现状
|
建议做法
|
为什么
|
|
有官方教材/指定教程
|
建议上传
|
可以锁定版本、术语、章节和学习范围
|
|
有教材 + 题库/作业
|
优先上传两类材料
|
教材回答“学什么”,题库帮助建立训练与检验任务
|
|
有公司内部材料
|
按需上传
|
适合“工作中会用”的目标,可进入真实任务练习
|
|
没有任何材料
|
也可以开始
|
先建立临时课程框架,后续补教材后重新校准
|
关键边界:上传教材不等于“训练模型”。在本项目中,更准确的工程表达是让 Agent 读取、索引、解析并在学习任务中引用材料;是否使用向量检索、长上下文或其他技术属于实现选择。
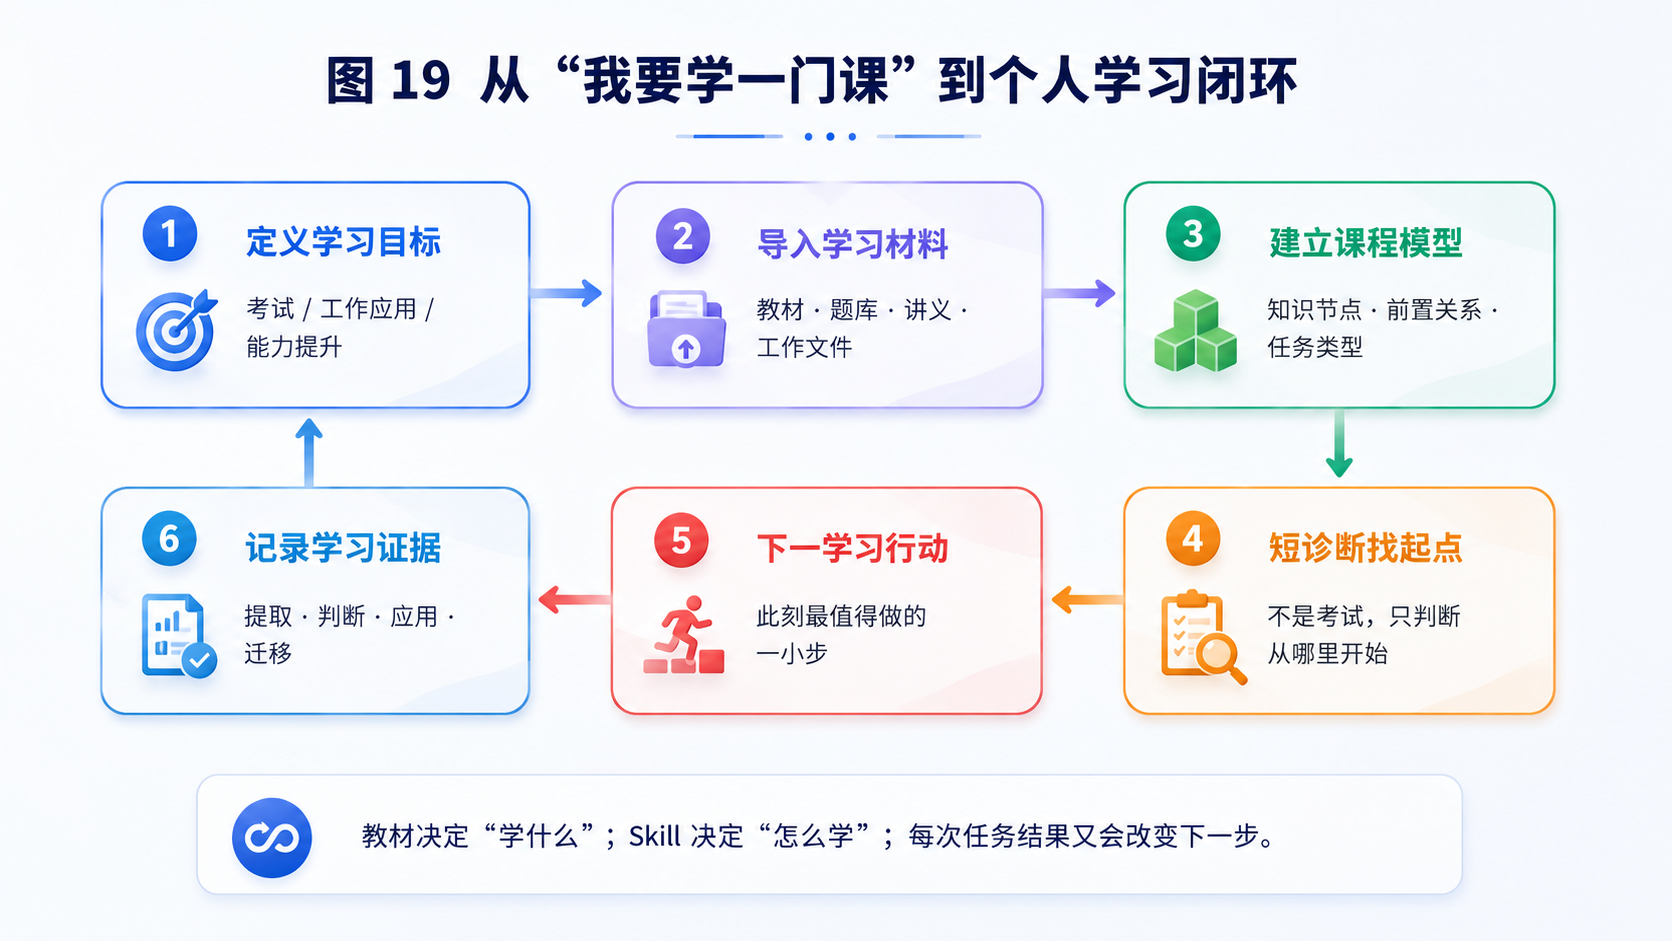
图 19 从“我要学一门课”到个人学习闭环
6.2 四类学习材料:主教材、训练材料、真实材料和外部补充材料
为了避免所有资料混成一个“知识库”,知行应当记录不同材料的角色和优先级。尤其在考试、标准和课程学习中,用户指定教材不能被外部搜索结果静默覆盖。
|
材料层
|
典型内容
|
主要用途
|
优先级/边界
|
|
Primary Source 主教材
|
官方教材、讲义、标准正文、指定参考书
|
确定课程范围、术语、知识节点和版本
|
最高;冲突时优先保留用户指定口径
|
|
Practice Source 训练材料
|
真题、习题、作业、实验、案例题
|
生成练习、检索、反馈和阶段检测
|
用于训练,不自动代表知识标准
|
|
Real-world Source 真实材料
|
用户项目、公司文件、真实业务文档
|
事上练、工作迁移、成果物训练
|
敏感材料按最小必要原则使用
|
|
Supplemental Source 外部补充
|
公开资料、知识库、搜索、行业案例、MOSS
|
补充解释、变化信息、商业/行业情境
|
必须标注来源;不得静默覆盖主教材
|
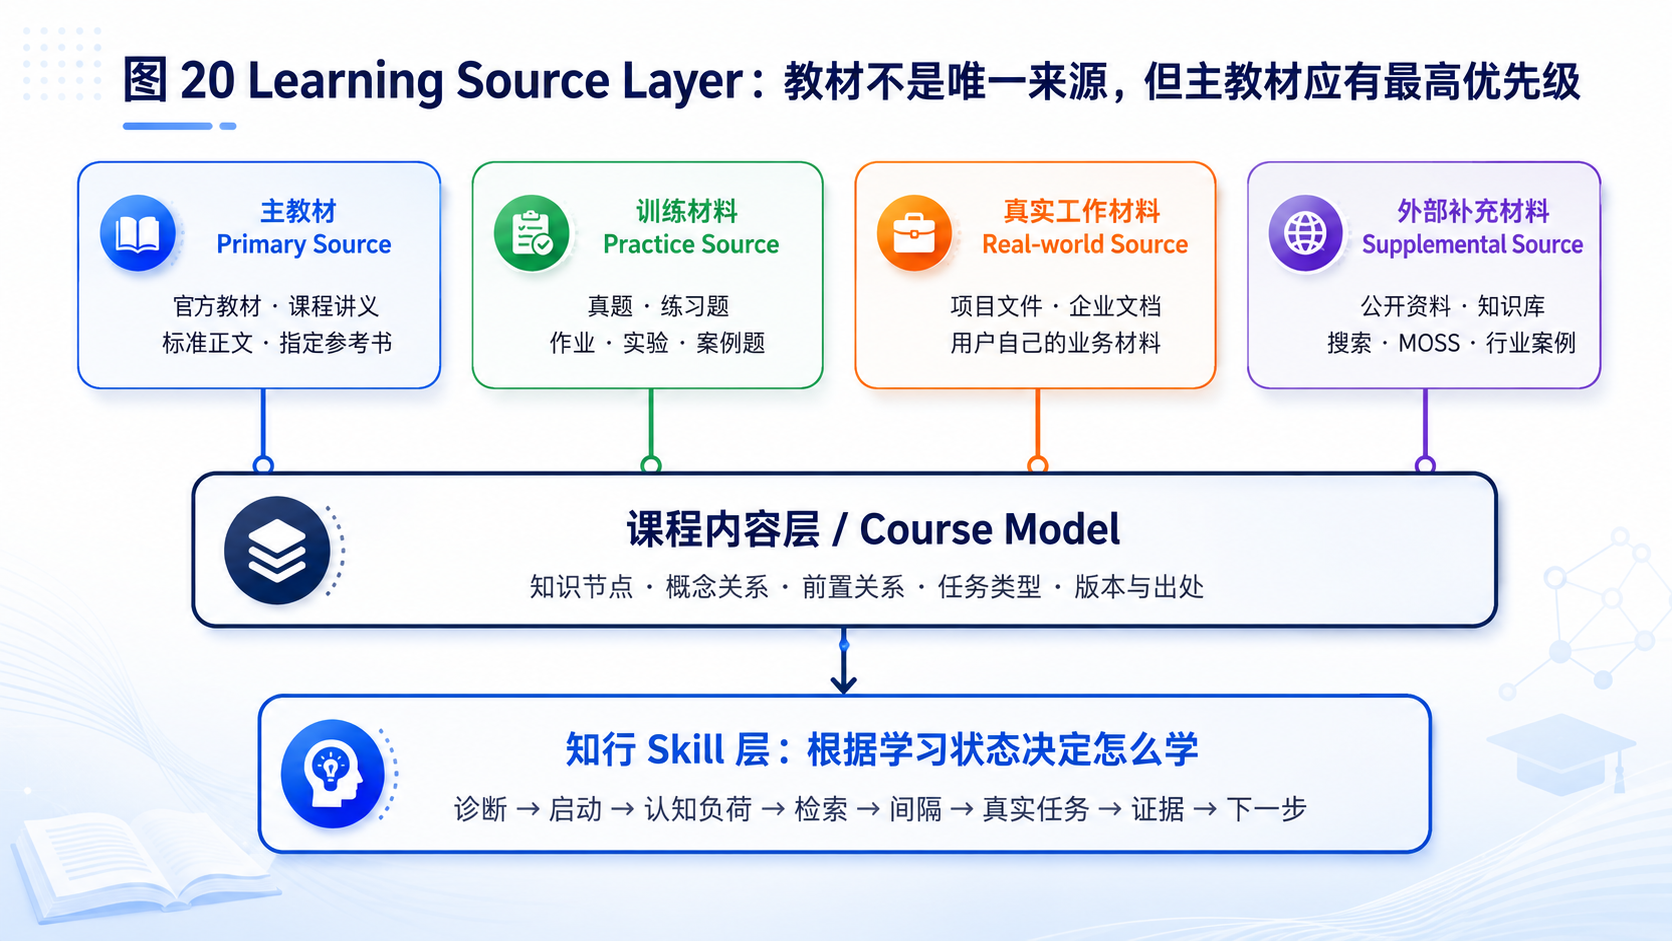
图 20 Learning Source Layer:不同材料承担不同作用
6.3 教材上传以后,第一步不是讲课,而是建立 Course Model
一本教材对人来说有目录,对 Agent 来说还需要更细的可编排结构:知识节点是什么、哪些概念依赖哪些前置知识、哪些内容适合判断题、哪些必须通过真实任务才能检验,以及每个节点的出处在哪里。
例如学习“高项风险管理”,系统可以把章节拆成风险基本概念、风险与问题的区分、风险识别、概率与影响、应对策略、风险监督等节点,并记录这些节点之间的依赖关系。这个 Course Model 只是工程模型,不意味着教材存在唯一正确的学习顺序。
|
Course Model 字段
|
示例
|
|
knowledge_node
|
风险与问题的区分
|
|
source_ref
|
教材第 X 章 / 用户指定讲义
|
|
prerequisites
|
风险基本概念
|
|
task_types
|
判断、解释、案例应用
|
|
mastery_evidence
|
无提示判断、真实项目应用
|
|
version_scope
|
教材版本 / 考试年度 / 标准版本
|
6.4 不从第一页开始:用短诊断寻找起点
同一本教材,不同学习者的起点不同。知行可以先用少量低成本任务判断已有证据,而不是默认所有人都从第一章第一节开始。诊断的目的不是给用户打标签,而是减少明显重复和过早进入过难内容。
例如用户说“我要学高项风险管理”,系统可以先问:供应商说“下个月可能晚交两周”,这是已经发生的问题还是未来风险?如果用户能够稳定判断,说明最基础概念可能不需要长篇讲解;如果后续在概率影响与应对策略上出现困难,再把学习资源集中到相应节点。
6.5 每次给的不是“一章”,而是一个 Next Learning Action
传统课程通常按章节推进;知行原型尝试把一次学习组织成一个可观察行动。行动可能是 30 秒判断、2 分钟无提示提取、5 分钟小案例,也可能是 20 分钟真实工作任务。系统根据当前目标、证据、复习窗口和可用时间选择下一步。
|
当前信号
|
下一学习行动示例
|
|
刚开始且任务规模感很大
|
先做 20 秒判断,不要求读完整章
|
|
刚看过但没有提取证据
|
隐藏答案,要求自己说出核心概念
|
|
几天前学过
|
换一个新题或新情境进行间隔复测
|
|
模拟题已稳定
|
转到真实文件/真实项目任务
|
|
真实任务完成但依赖大量提示
|
减少提示后再做同类任务
|
6.6 “工作中会用”时,真实材料比平台名称更重要
如果学习目标是工作应用,教材之外通常还需要真实材料。例如学习 ISO14001,可以同时加入标准正文、企业环境因素清单、程序文件和审核记录;学习商业分析,可以加入真实经营数据、行业资料或在授权范围内使用 MOSS 的商业洞察材料。MOSS 在这里是可选的商业场景素材源之一,不是课程导入的必需条件。
6.7 两个完整例子:考试型学习与工作型学习
|
阶段
|
高项考试
|
ISO14001 工作应用
|
|
目标
|
通过考试,同时理解项目管理逻辑
|
能在企业场景识别、评价并说明依据
|
|
主材料
|
指定版教材 + 大纲
|
ISO14001 标准 + 内部程序文件
|
|
训练材料
|
真题、案例题
|
环境因素清单、审核案例
|
|
起点诊断
|
风险/问题、概率影响等短判断
|
识别环境因素与重要性判断
|
|
真实任务
|
为自己项目建立风险登记册
|
独立评价一份新的环境因素清单
|
|
证据
|
无提示判断、案例题、陌生项目迁移
|
真实文件判断、少提示完成、新企业场景迁移
|
6.8 材料冲突时怎么办:先明确“谁是课程标准”
在明确课程和考试场景中,系统应让用户指定“主教材/主标准”。当外部资料与主教材出现差异时,系统应说明差异,而不是自动用网络上更新或更常见的表述替换教材口径。对于需要最新信息的课程,用户可以主动指定“以最新法规/标准为准”,这时主源规则才随之变化。
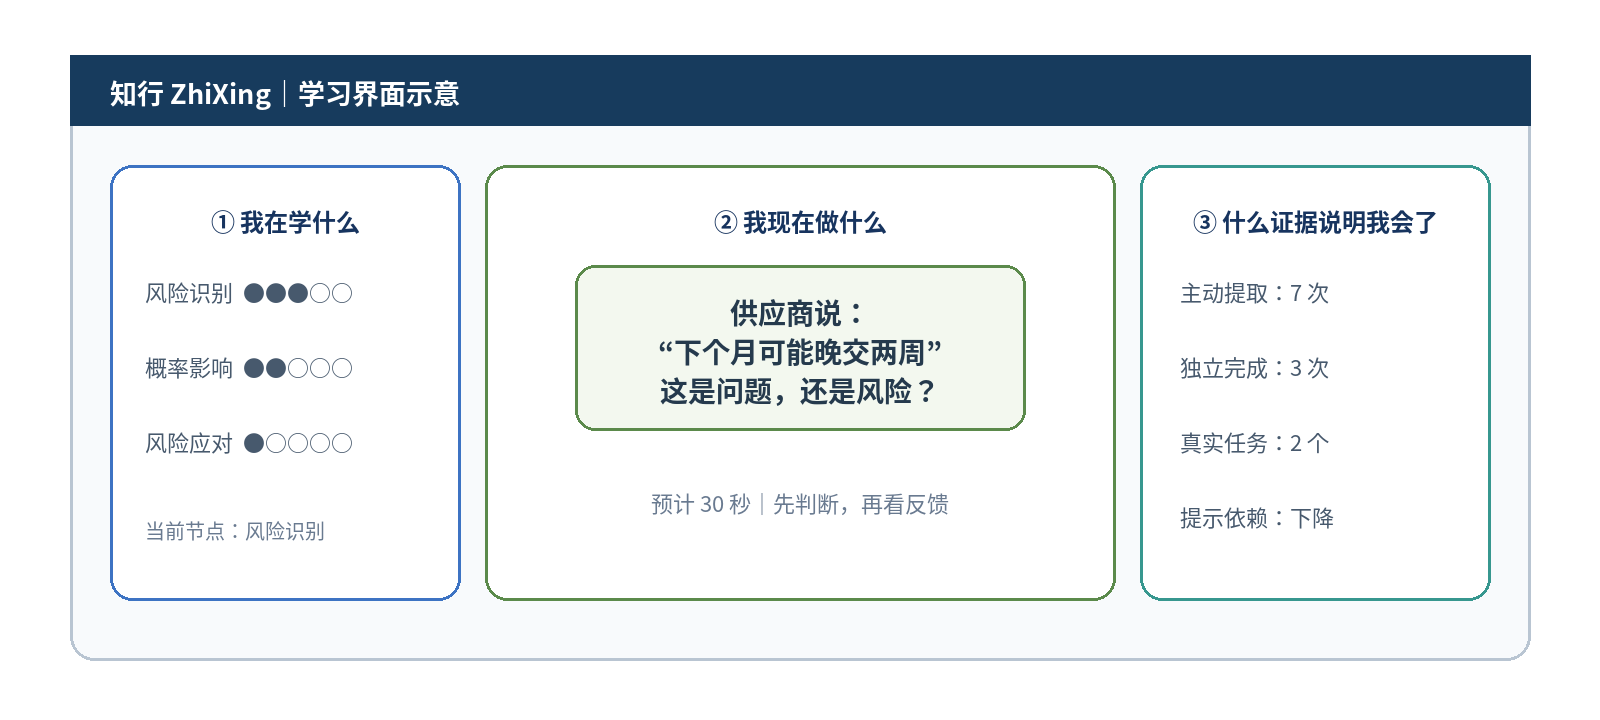
学习界面示意:路径、当前任务与学习证据三类信息分开呈现
6.9 入口问题保持简单
你想真正学会什么?
用户进入目标后,界面一次只呈现一个主要学习任务。Skill 路由、素材检索和间隔调度属于后台实现;只有当用户需要理解原因时,再解释“为什么现在安排这一步”。
6.10 界面不把后台估计值伪装成客观能力
- 展示能力变化,不展示复杂后台分数。
- 展示下一步预计用时,不展示算法权重。
- 展示真实任务证据,不用打卡天数冒充能力。
- 给出一句“为什么现在做这一步”的解释,让系统保持可理解。
6.11 三种典型界面状态
|
状态
|
中间主卡片
|
右侧证据
|
用户可选动作
|
|
高阻力
|
20 秒最小行动
|
告诉用户“今天不是从零开始”
|
开始 / 再缩小
|
|
正常学习
|
3-8 分钟主动任务
|
显示提取与提示依赖
|
继续 / 换例子
|
|
进入真实任务
|
文件/项目/案例任务
|
显示 E3-E5 证据链
|
提交 / 反省 / 再验证
|
6.12 系统解释到什么程度
用户没有必要了解 ZX-06、ZX-11 等内部模块名,但系统应能说明当前任务的可观察依据,例如:“你上次在没有提示时没有提取出来,所以今天先复测,不增加新知识。”这种解释应基于真实记录,避免出现“系统判断你缺乏专注力”之类无法支持的心理归因。
07 工程实现:1+6 Skill 架构与学习状态数据
一种可实现的工程形态是“1 个总编排器 + 6 类专业 Skill + Tool/Data/Content 底座 + 学习状态数据”。ZX-00 负责路由,其他 Skill 各自只处理一类工程问题;教材、题库、用户文件、织界、搜索和 MOSS 等都属于底座资源,而不是学习科学机制本身。18 个 Skill 是当前原型的模块划分,并非最终架构。
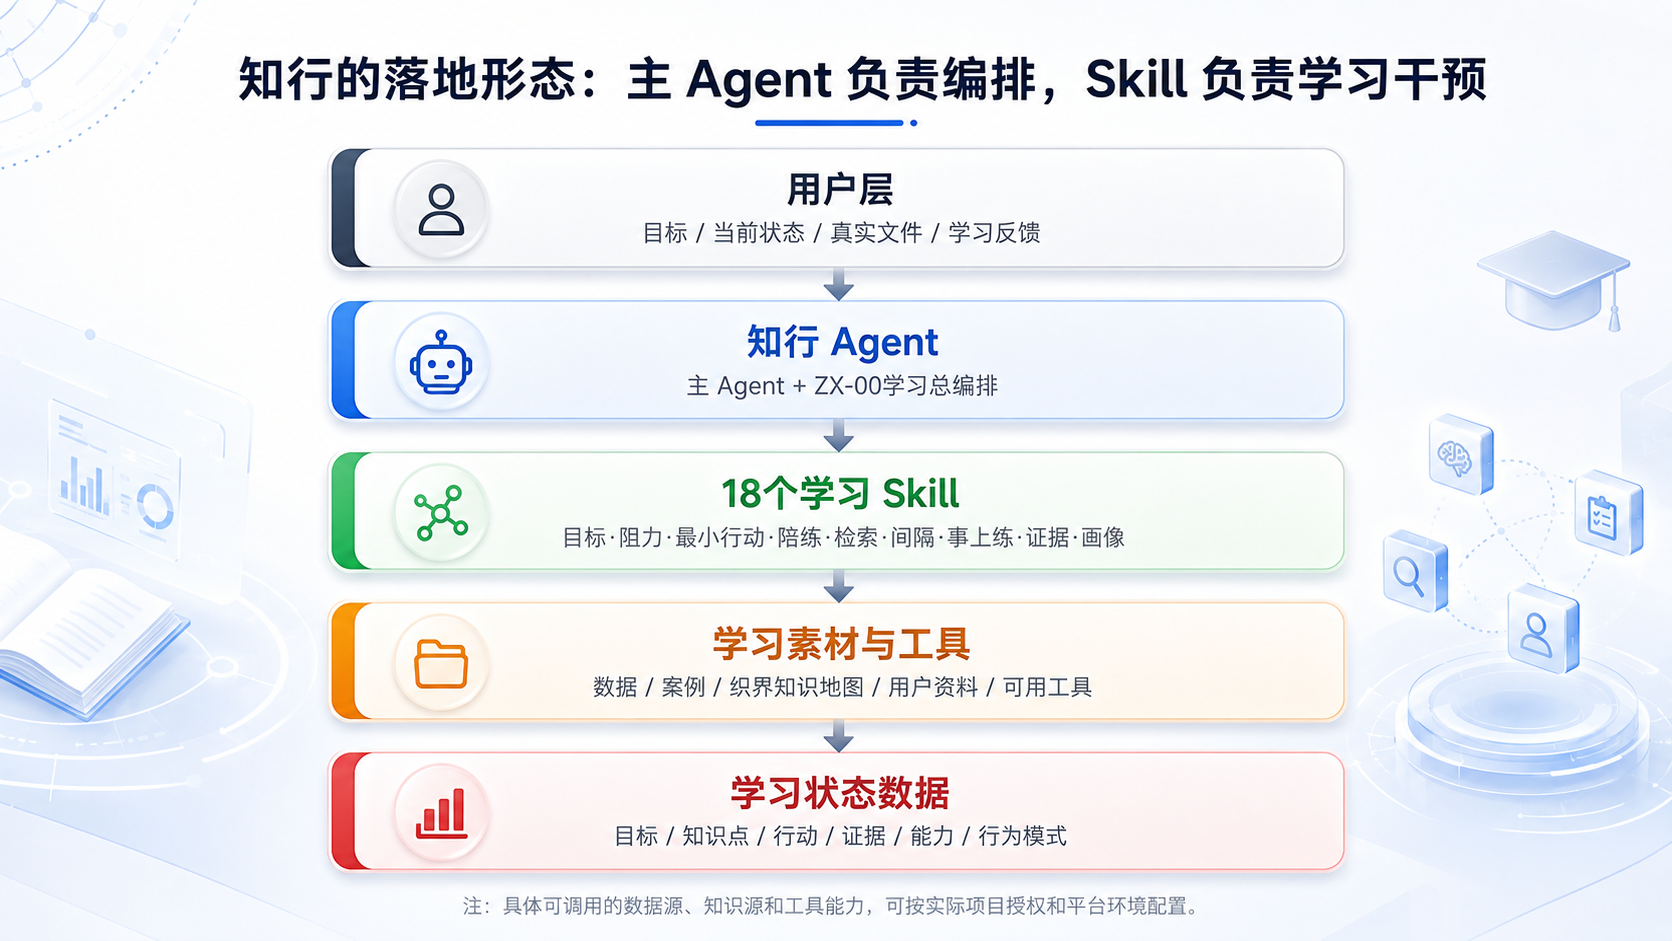
工程架构示意:主 Agent 编排任务,Skill 实现干预,工具与数据完成外部执行
7.1 “1 + 6 + 底座”的当前架构
ZX-00 负责总编排;状态诊断、目标路径、启动与认知干预、练习迁移、证据能力、自适应反思共六类专业 Skill;外部材料与工具统一放在底座层。
图 21 知行 Skill 架构:1 个总编排器 + 6 类专业 Skill + 工具/内容底座
|
分组
|
Skill
|
主要问题
|
|
总编排
|
ZX-00
|
此刻应该调用谁、下一步做什么
|
|
状态诊断
|
ZX-01~ZX-03
|
会到什么程度、知与行差多少、当前任务阻力在哪里
|
|
目标与路径
|
ZX-04~ZX-05
|
到底学成什么、知识节点如何组织
|
|
启动与认知干预
|
ZX-06~ZX-09
|
开始不了、预期太难、过载、被动输入
|
|
练习与迁移
|
ZX-10~ZX-12
|
真实应用、主动提取、间隔巩固
|
|
证据与能力
|
ZX-13~ZX-14
|
凭什么说学会、当前能力结构怎样
|
|
自适应与反思
|
ZX-15~ZX-17
|
什么任务更适合、下一行动是什么、如何从行动抽象规则
|
7.2 当前 18 个 Skill 的工程职责
|
ID
|
Skill
|
工程职责(待验证)
|
典型触发信号
|
|
ZX-00
|
学习总编排器
|
判断阶段并路由其他 Skill
|
所有学习轮次
|
|
ZX-01
|
掌握水平检测器
|
依据任务表现区分“见过、能提取、能判断、能应用、能迁移”等证据层级
|
新目标/复测
|
|
ZX-02
|
知行差检测器
|
判断知识与行动证据差距
|
知识高行动低
|
|
ZX-03
|
学习阻力检测器
|
依据跳过、任务规模、不确定性等信息记录可能的启动阻力,不作人格诊断
|
迟迟不开始/跳过
|
|
ZX-04
|
学习目标蒸馏器
|
把“我要学 X”变成可验证能力目标
|
目标过宽/模糊
|
|
ZX-05
|
知识路径接入器
|
接入织界/领域知识图谱与前置关系
|
需要确定学习节点
|
|
ZX-06
|
最小学习行动器
|
生成 30 秒-5 分钟的第一步
|
启动阻力高/时间短
|
|
ZX-07
|
难度预期校正器
|
通过小任务结果校准用户对任务难度的预期;效果需验证
|
难度预估明显偏高
|
|
ZX-08
|
认知负荷控制器
|
控制信息密度与一次处理的关系数
|
错误连续/反应变慢
|
|
ZX-09
|
AI 陪练器
|
短问、追问、找错、提示,保持主动参与
|
注意下滑/被动输入
|
|
ZX-10
|
事上练生成器
|
把真实数据/文件/项目转成练习
|
需要真实应用
|
|
ZX-11
|
检索与即时反馈器
|
从“看”转成“自己想出来”
|
需要巩固/复测
|
|
ZX-12
|
间隔巩固器
|
决定何时再次出现知识
|
到达复习窗口
|
|
ZX-13
|
学习证据器
|
维护 E0-E5 证据
|
每次关键任务后
|
|
ZX-14
|
能力图谱器
|
展示真正能做什么
|
需要查看能力结构
|
|
ZX-15
|
学习行为模型器
|
记录什么任务形式/时长在历史上更容易完成,用于任务适配
|
积累多轮行为后
|
|
ZX-16
|
下一最佳学习行动
|
从候选动作中动态选出下一步
|
每个学习轮次结束
|
|
ZX-17
|
行后反思器
|
把成功/错误提炼成可迁移规则
|
真实任务或关键错误后
|
7.3 学习行为模型只记录任务行为,不做人格推断
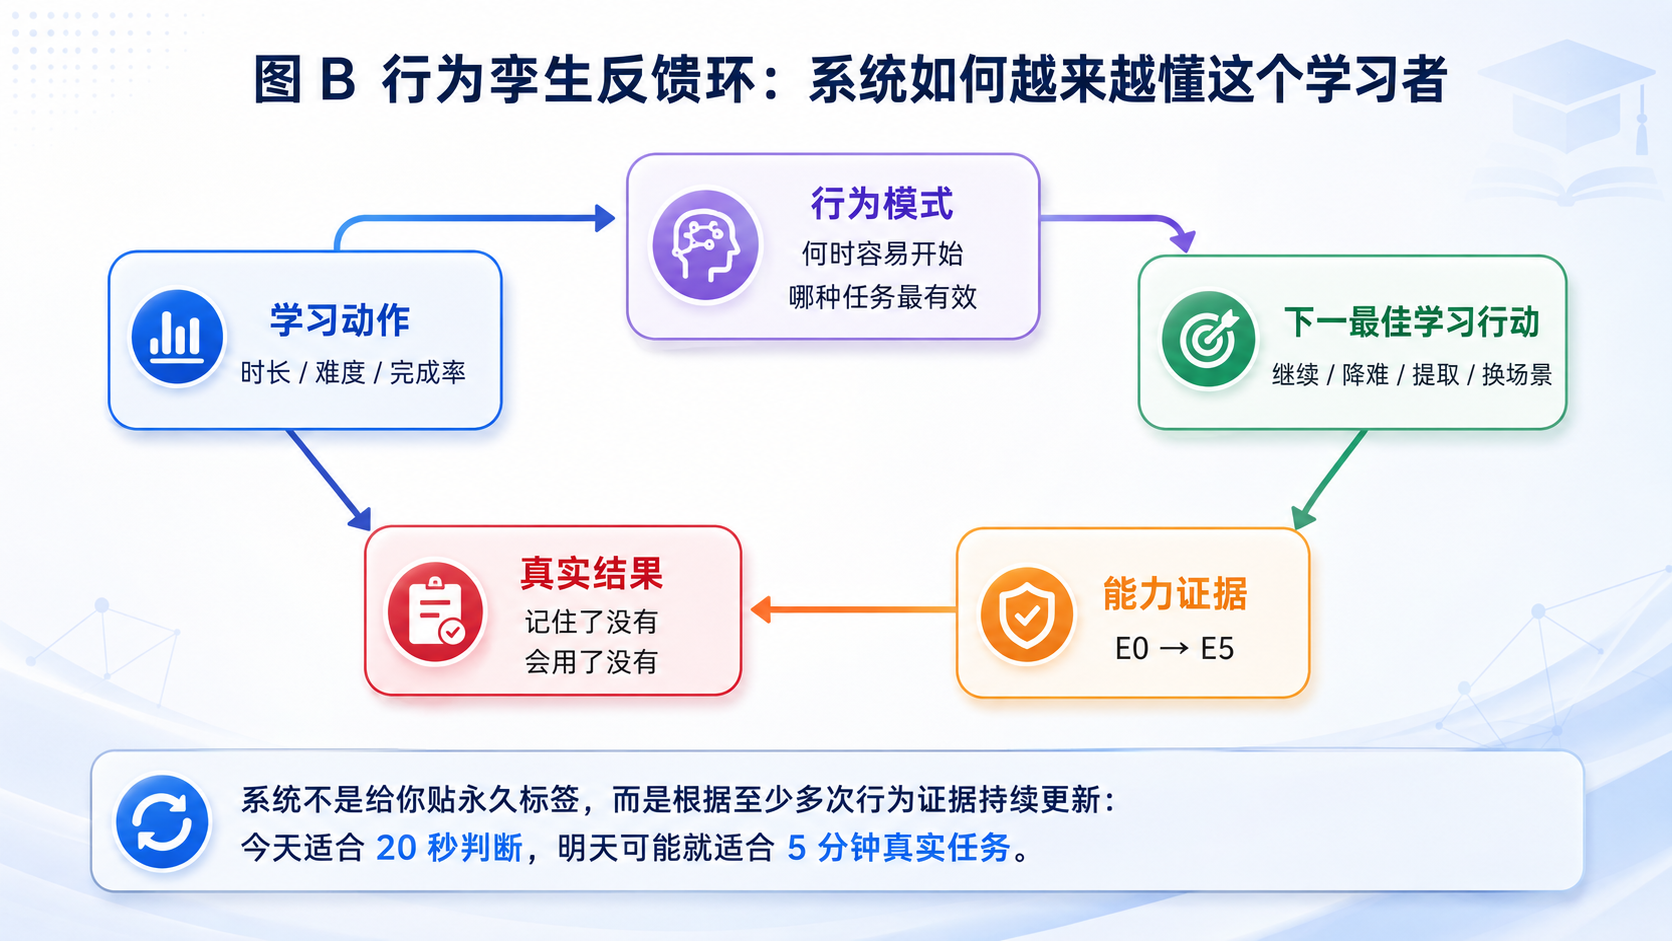
行为数据反馈环:学习动作、结果和提示依赖用于调整下一任务
系统可以发现:最近 5 次晚间学习里,2-5 分钟判断任务完成率明显高于 15 分钟阅读;但周末上午又能稳定完成 20 分钟真实任务。这样的信息可以用于调整下一步,却不应该被写成“你是一个没有耐心的人”。
这类个性化首先是“任务适配”问题,而不是“识别人是什么样的人”。是否真的能提高学习效果,需要比较个性化路由与固定路由在同等学习时间下的表现。
7.4 核心数据对象
|
对象
|
最小关键字段
|
用途
|
|
Goal
|
领域、目标能力、期限、成功标准
|
定义“学什么才算学会”
|
|
Knowledge Node
|
节点、前置关系、难度
|
定位知识路径
|
|
Learning Action
|
任务、时长、难度、Skill 来源
|
记录每一次真正行动
|
|
Retrieval Record
|
答案、提示等级、正确性、反应时
|
判断主动提取
|
|
Spacing Record
|
上次时间、下次窗口、保持表现
|
安排跨时间再现
|
|
Practice
|
真实场景、材料、任务结果
|
记录“事上练”
|
|
Evidence
|
E0-E5、提示依赖、真实性、独立度
|
构建能力证据链
|
|
Behavior Pattern
|
任务形式、时长、完成率、跳过率
|
调整个体化下一步
|
08 悟反平台部署与实测
为验证知行在真实企业级 Agent 平台上的可落地性,项目组于 2026 年 8 月在帆软悟道(WUFAN)平台上完成了知行技能的实际搭建、装备与对话演示。悟道是帆软推出的企业级 AI Agent 搭建平台,支持对话式搭建、技能卡片、自动化任务与多工具连接,知行选择其作为真实平台落地的载体之一。
8.1 平台账号与 AI 员工团队
知行在悟道平台上以个人空间为基础搭建团队环境。平台内已创建两名 AI 员工:小悟(全能任务助手)与小帆(全栈开发专家),知行技能装备在小悟上运行。图 22 与图 23 展示了悟道平台的 AI 员工团队页面。
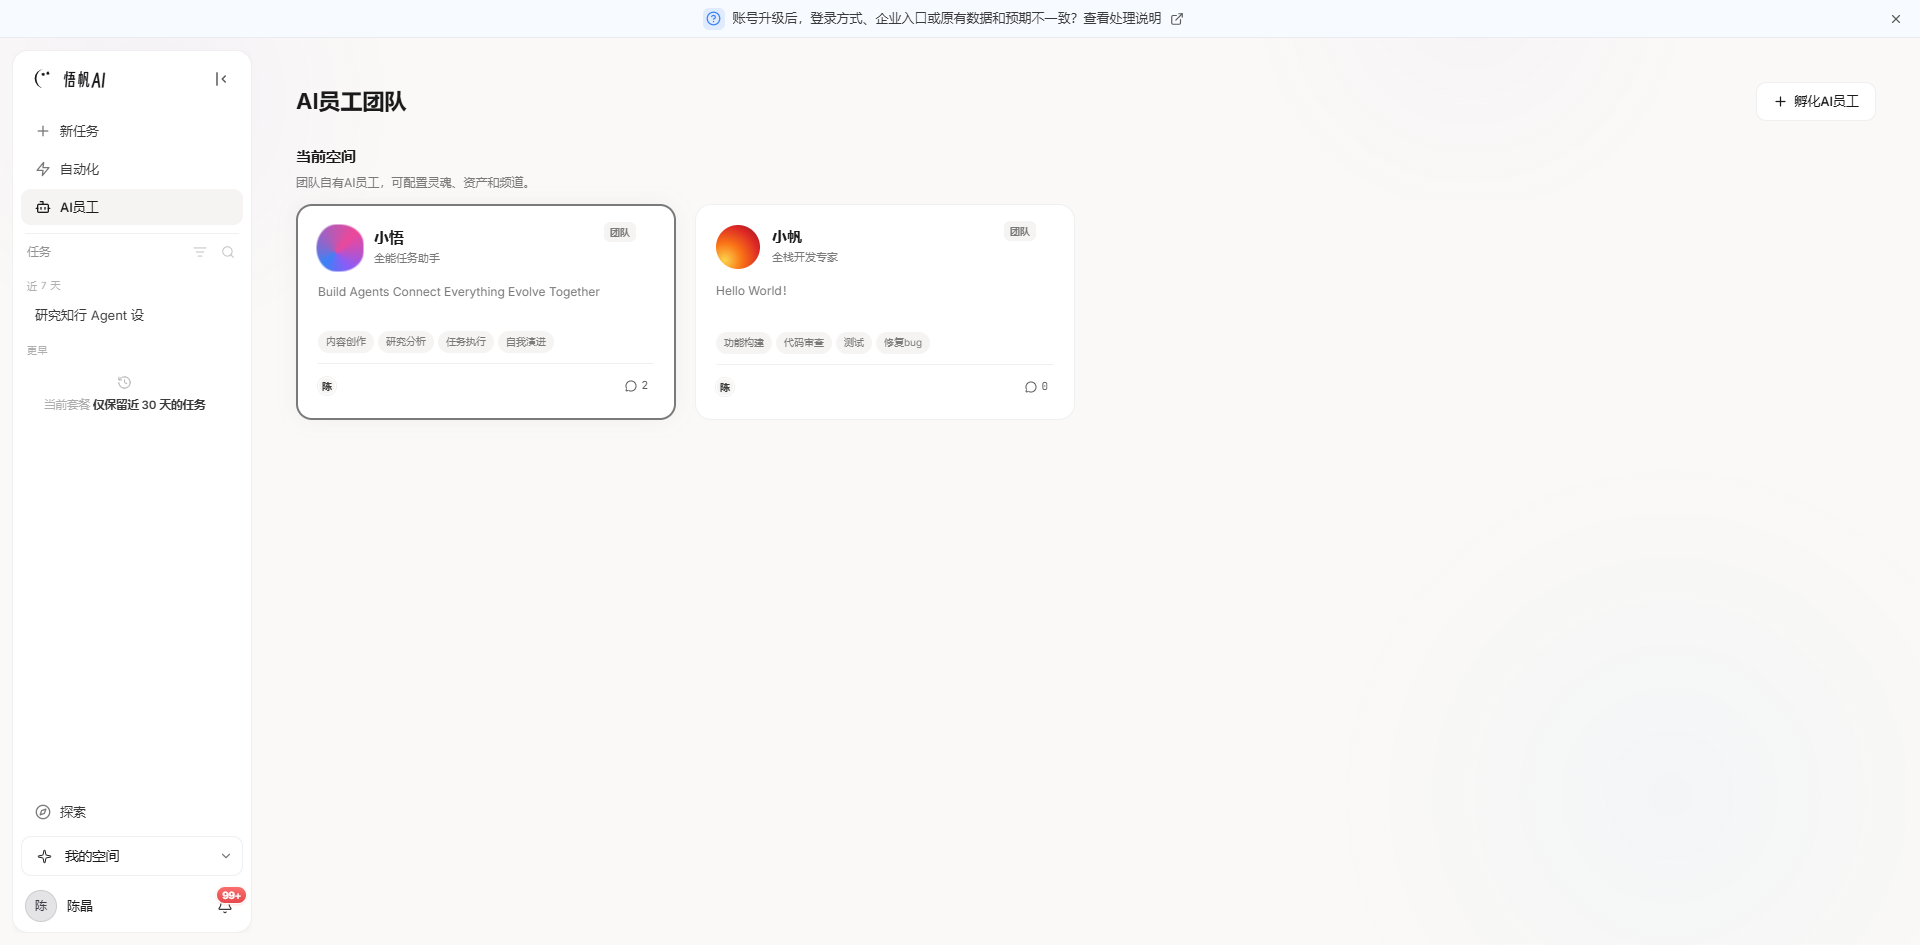
图 22 悟道平台 AI 员工团队:小悟(全能任务助手)与小帆(全栈开发专家)
图 23 悟道平台 AI 员工管理页(当前空间视图)
8.2 知行最小学习行动生成器:从设计到技能
项目将知行工程原型的核心逻辑封装为悟道平台的标准化技能「知行最小学习行动生成器」(技能 ID:zhi-xing-action),由陈晶与小悟共同构建,并已装备给 AI 员工小悟。该技能完整实现了知行「目标蒸馏→断点诊断→行动生成→主动提取→证据收集」的学习闭环:
目标蒸馏:将“我要学 X”转化为“我要能够完成 Y”的能力目标;断点诊断:识别当前最主要的六个学习断点(启动/过载/走神/错觉/遗忘/迁移);行动生成:产生一个 30 秒至 5 分钟可立即执行的最小学习行动;主动提取:让用户先判断、回忆、解释,AI 再反馈;证据收集:记录 K/E/H 状态,形成能力证据链。
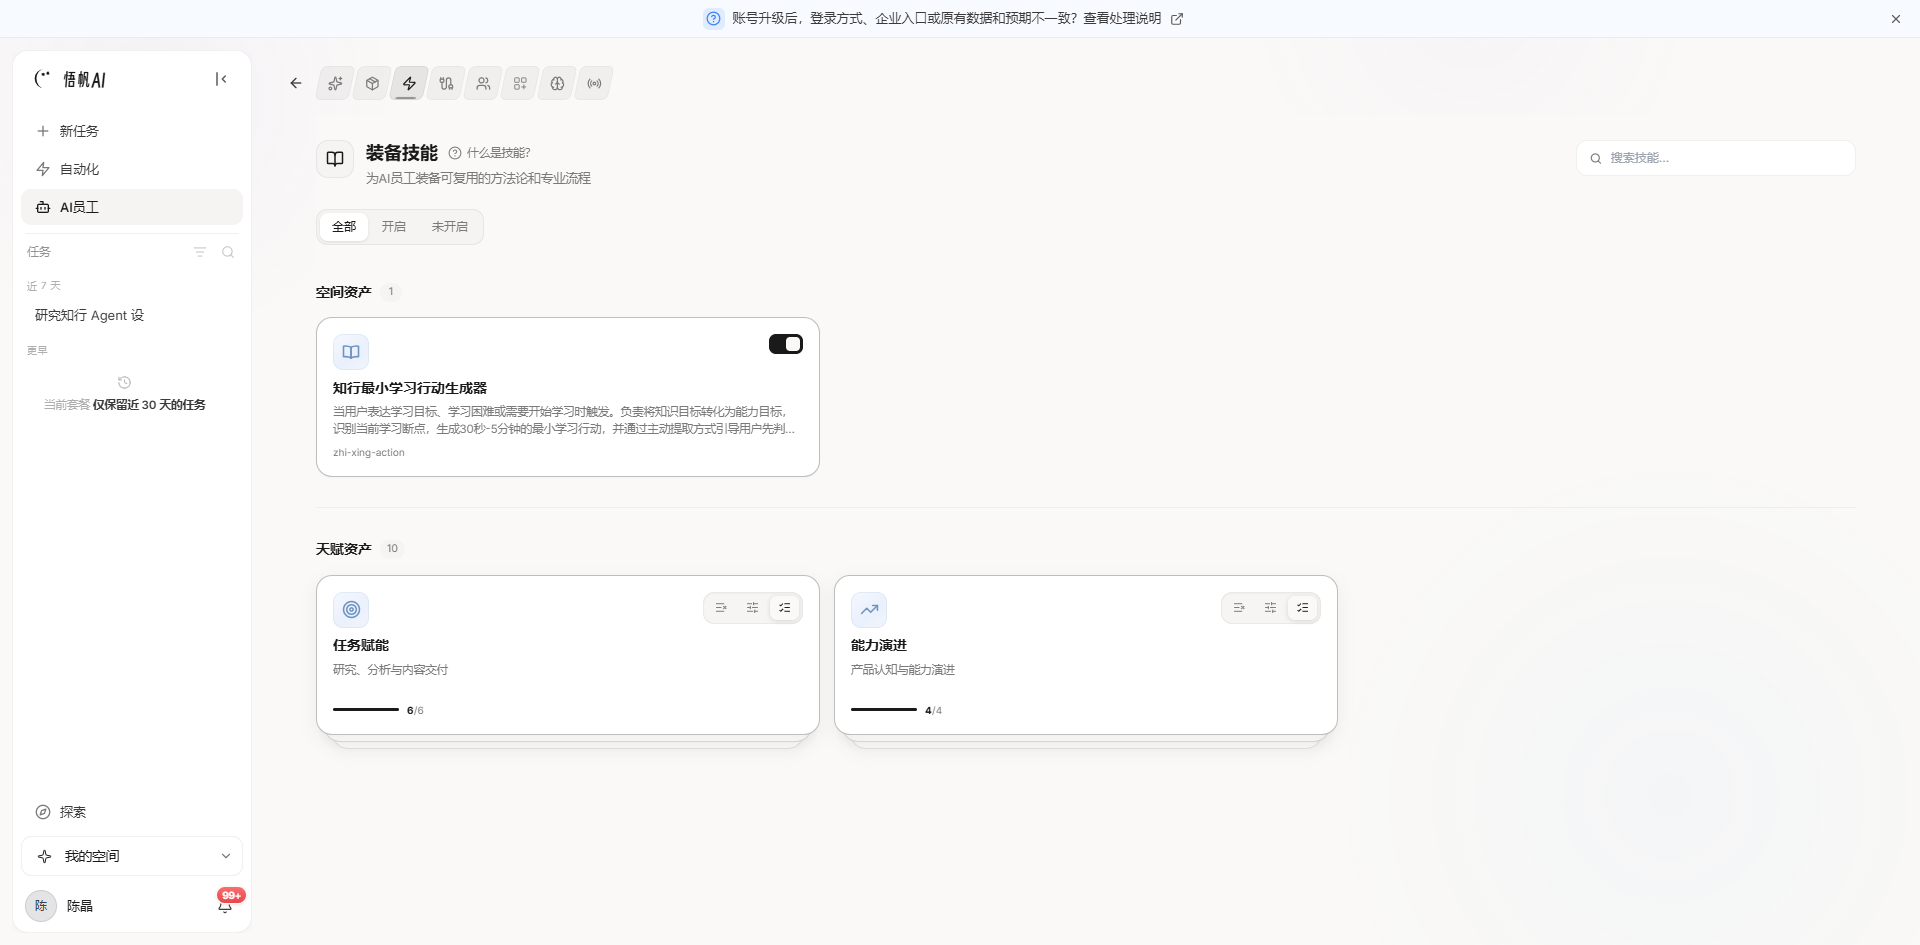
图 24 悟道平台技能列表:知行最小学习行动生成器已开启
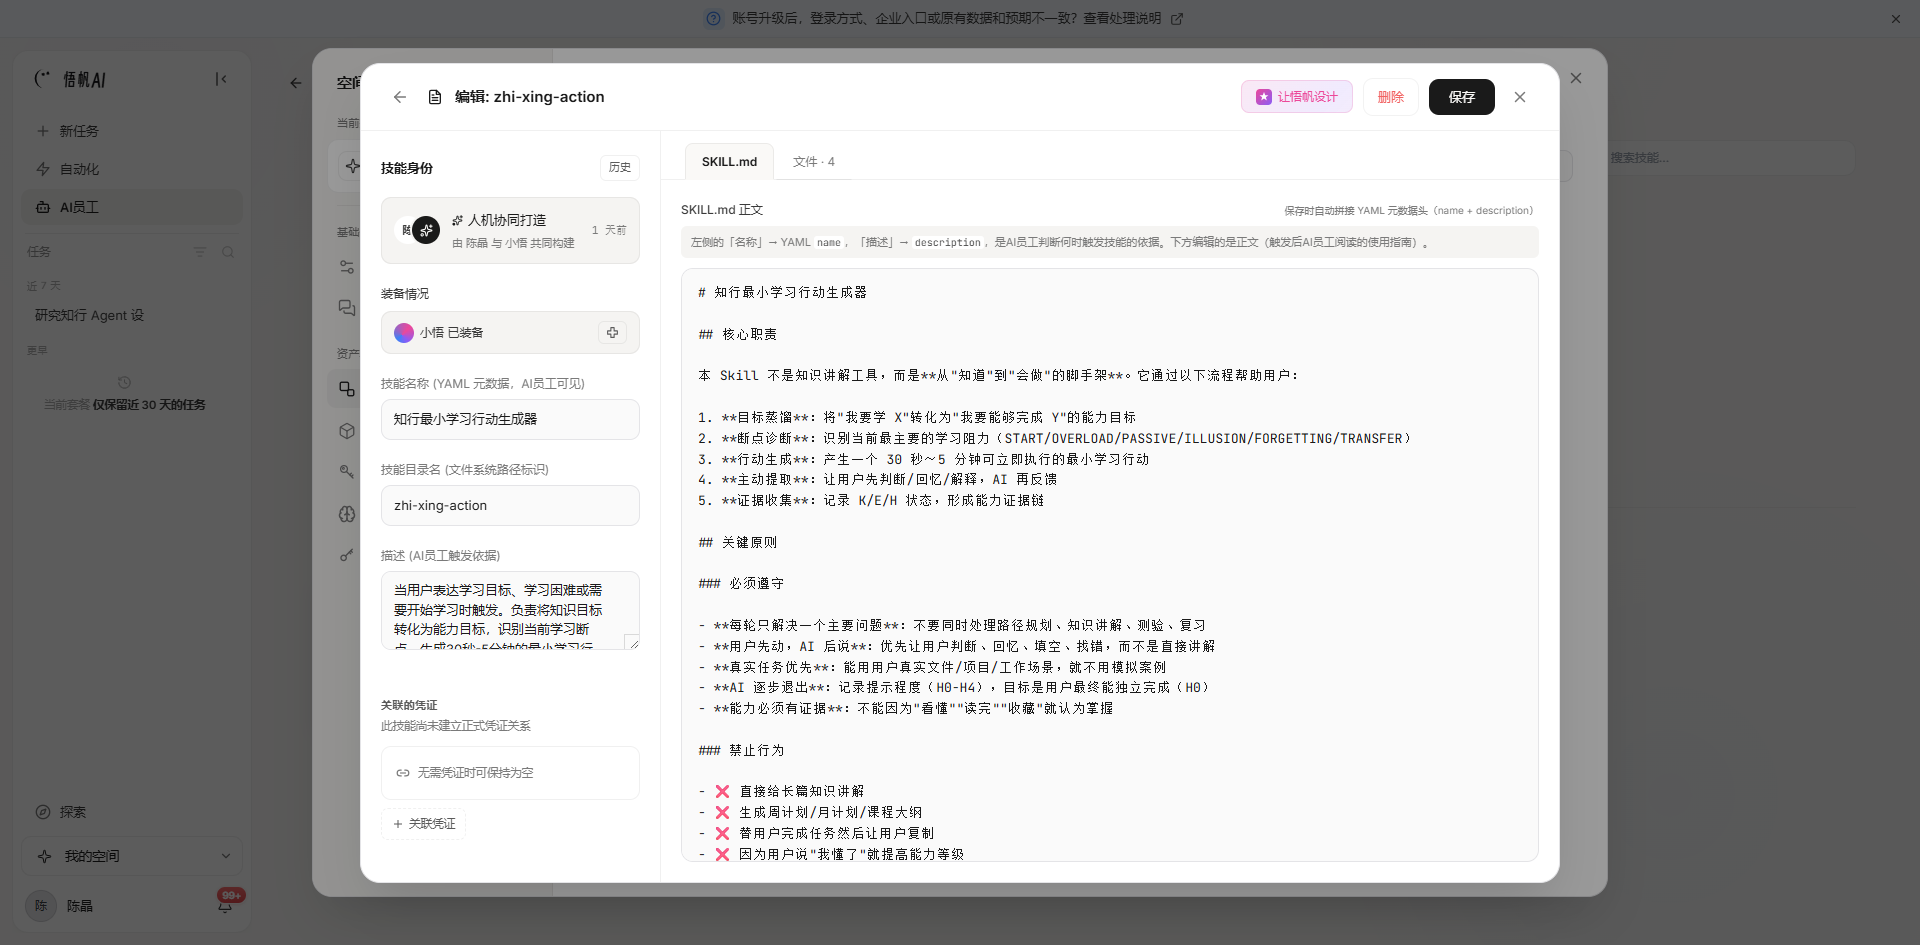
图 25 知行最小学习行动生成器(zhi-xing-action)技能详情与 SKILL.md 配置
8.3 与 AI 员工对话演示:从目标到最小行动
知行技能装备到小悟后,通过一次真实对话完成了完整的闭环演示。用户向小悟提出 FineBI 学习目标,小悟生成 P1-P5 能力地图,定位当前能力等级 K0,并给出可执行的最小行动(打开 FineBI、新建 Excel 数据集、上传文件),同时要求用户先执行再反馈,主动提取与证据收集贯穿其中。
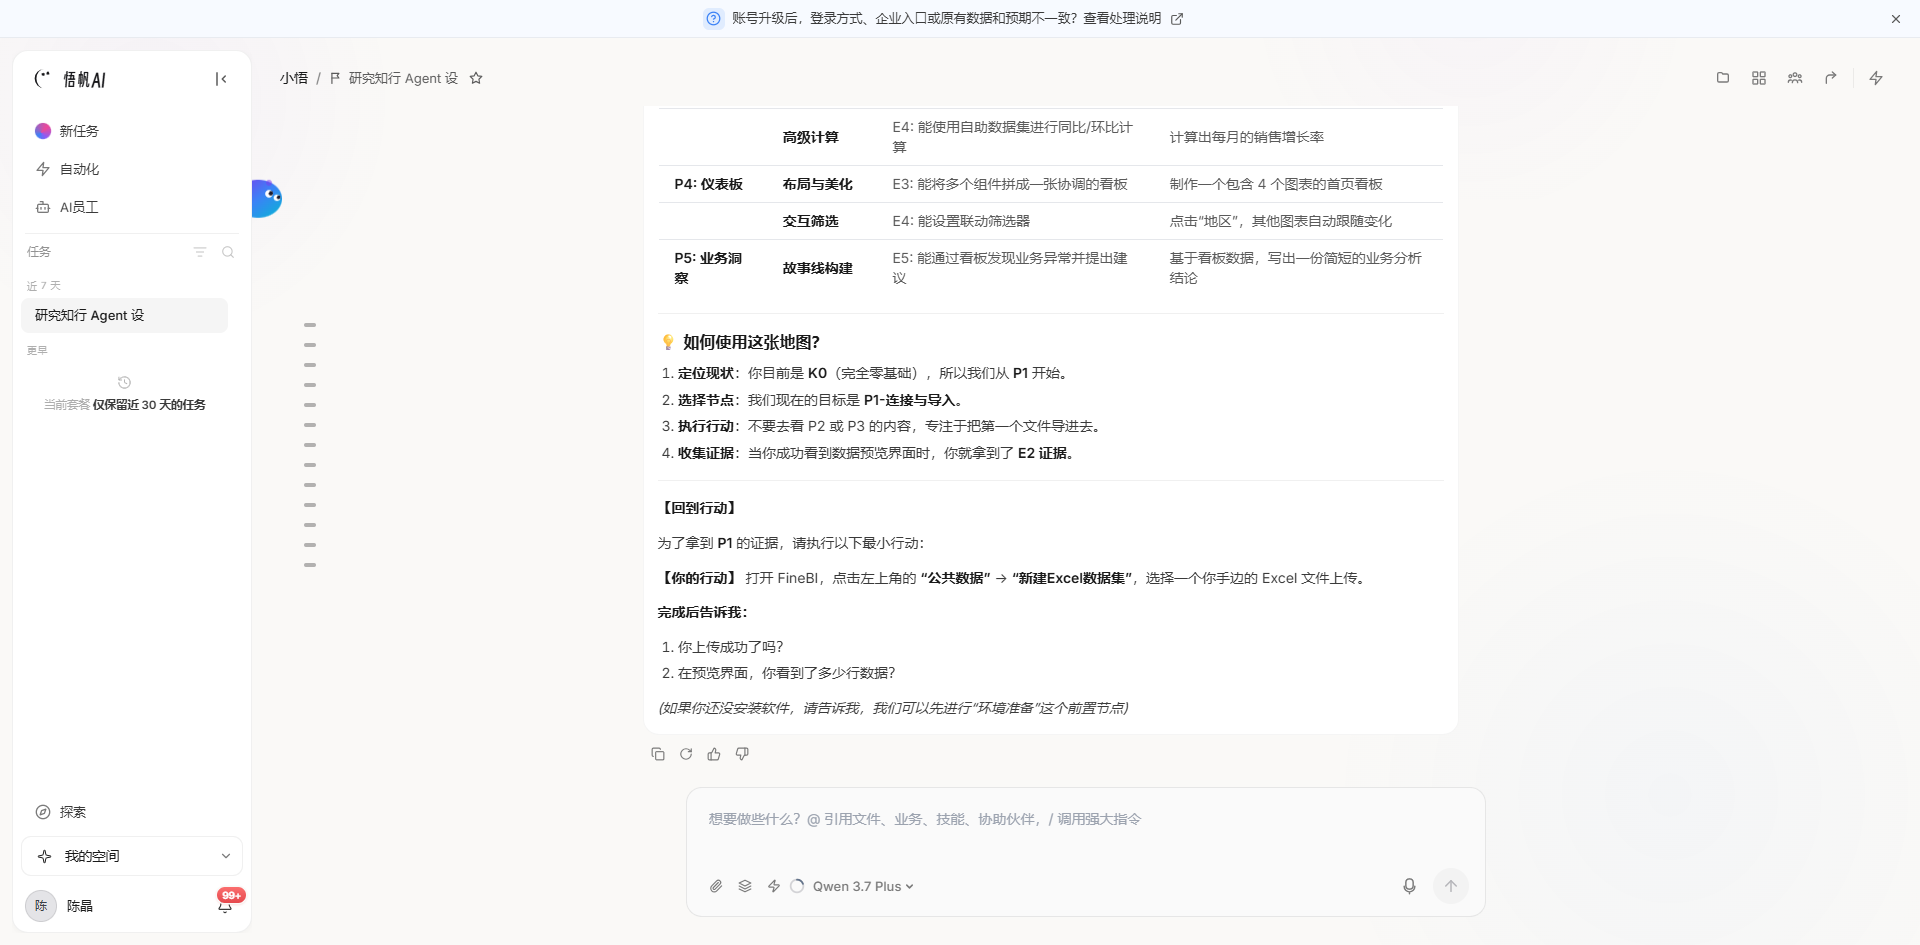
图 26 知行对话演示:能力地图(P1-P5)与最小行动指导
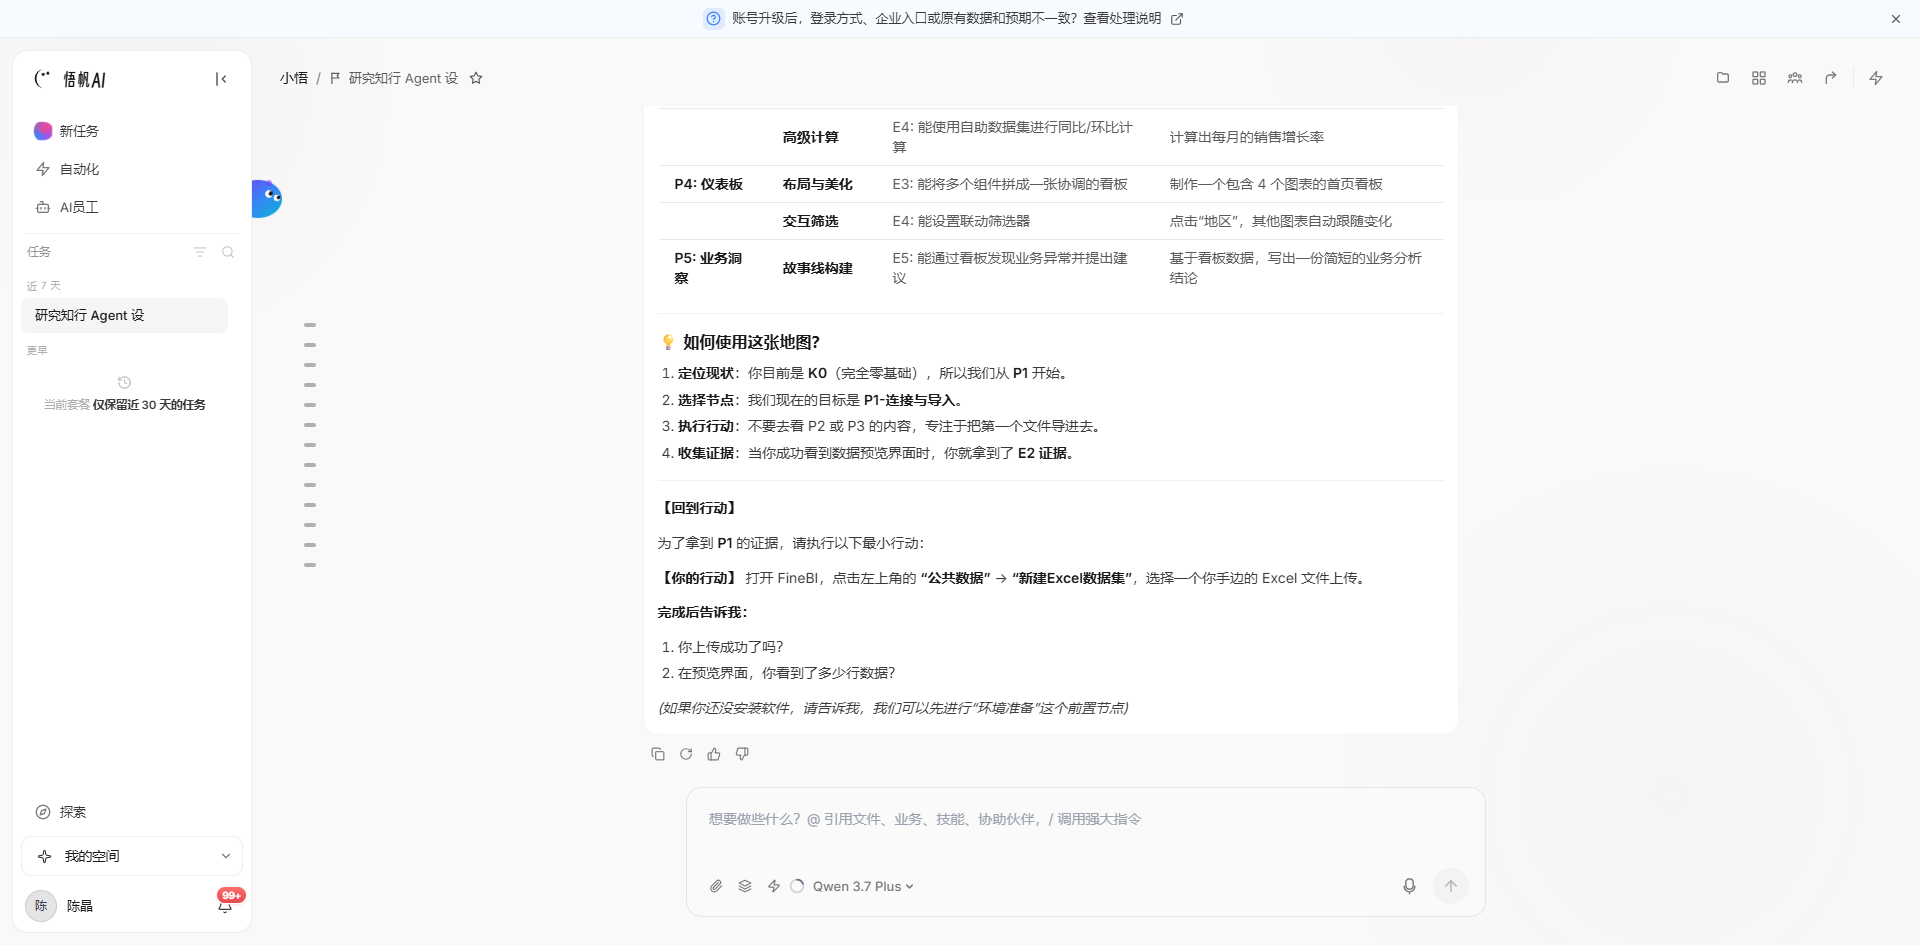
图 27 知行对话演示:回到行动、最小学习行动与主动提取
8.4 部署实测小结
悟道平台的实测验证了知行工程原型的可落地性:技能(Skill)可以无缝封装为平台技能,学习闭环可以在真实对话中运转。悟道平台的自动化、技能共享与多 Agent 协作能力,为知行后续接入真实业务系统、任务触发与证据回流提供了基础设施。
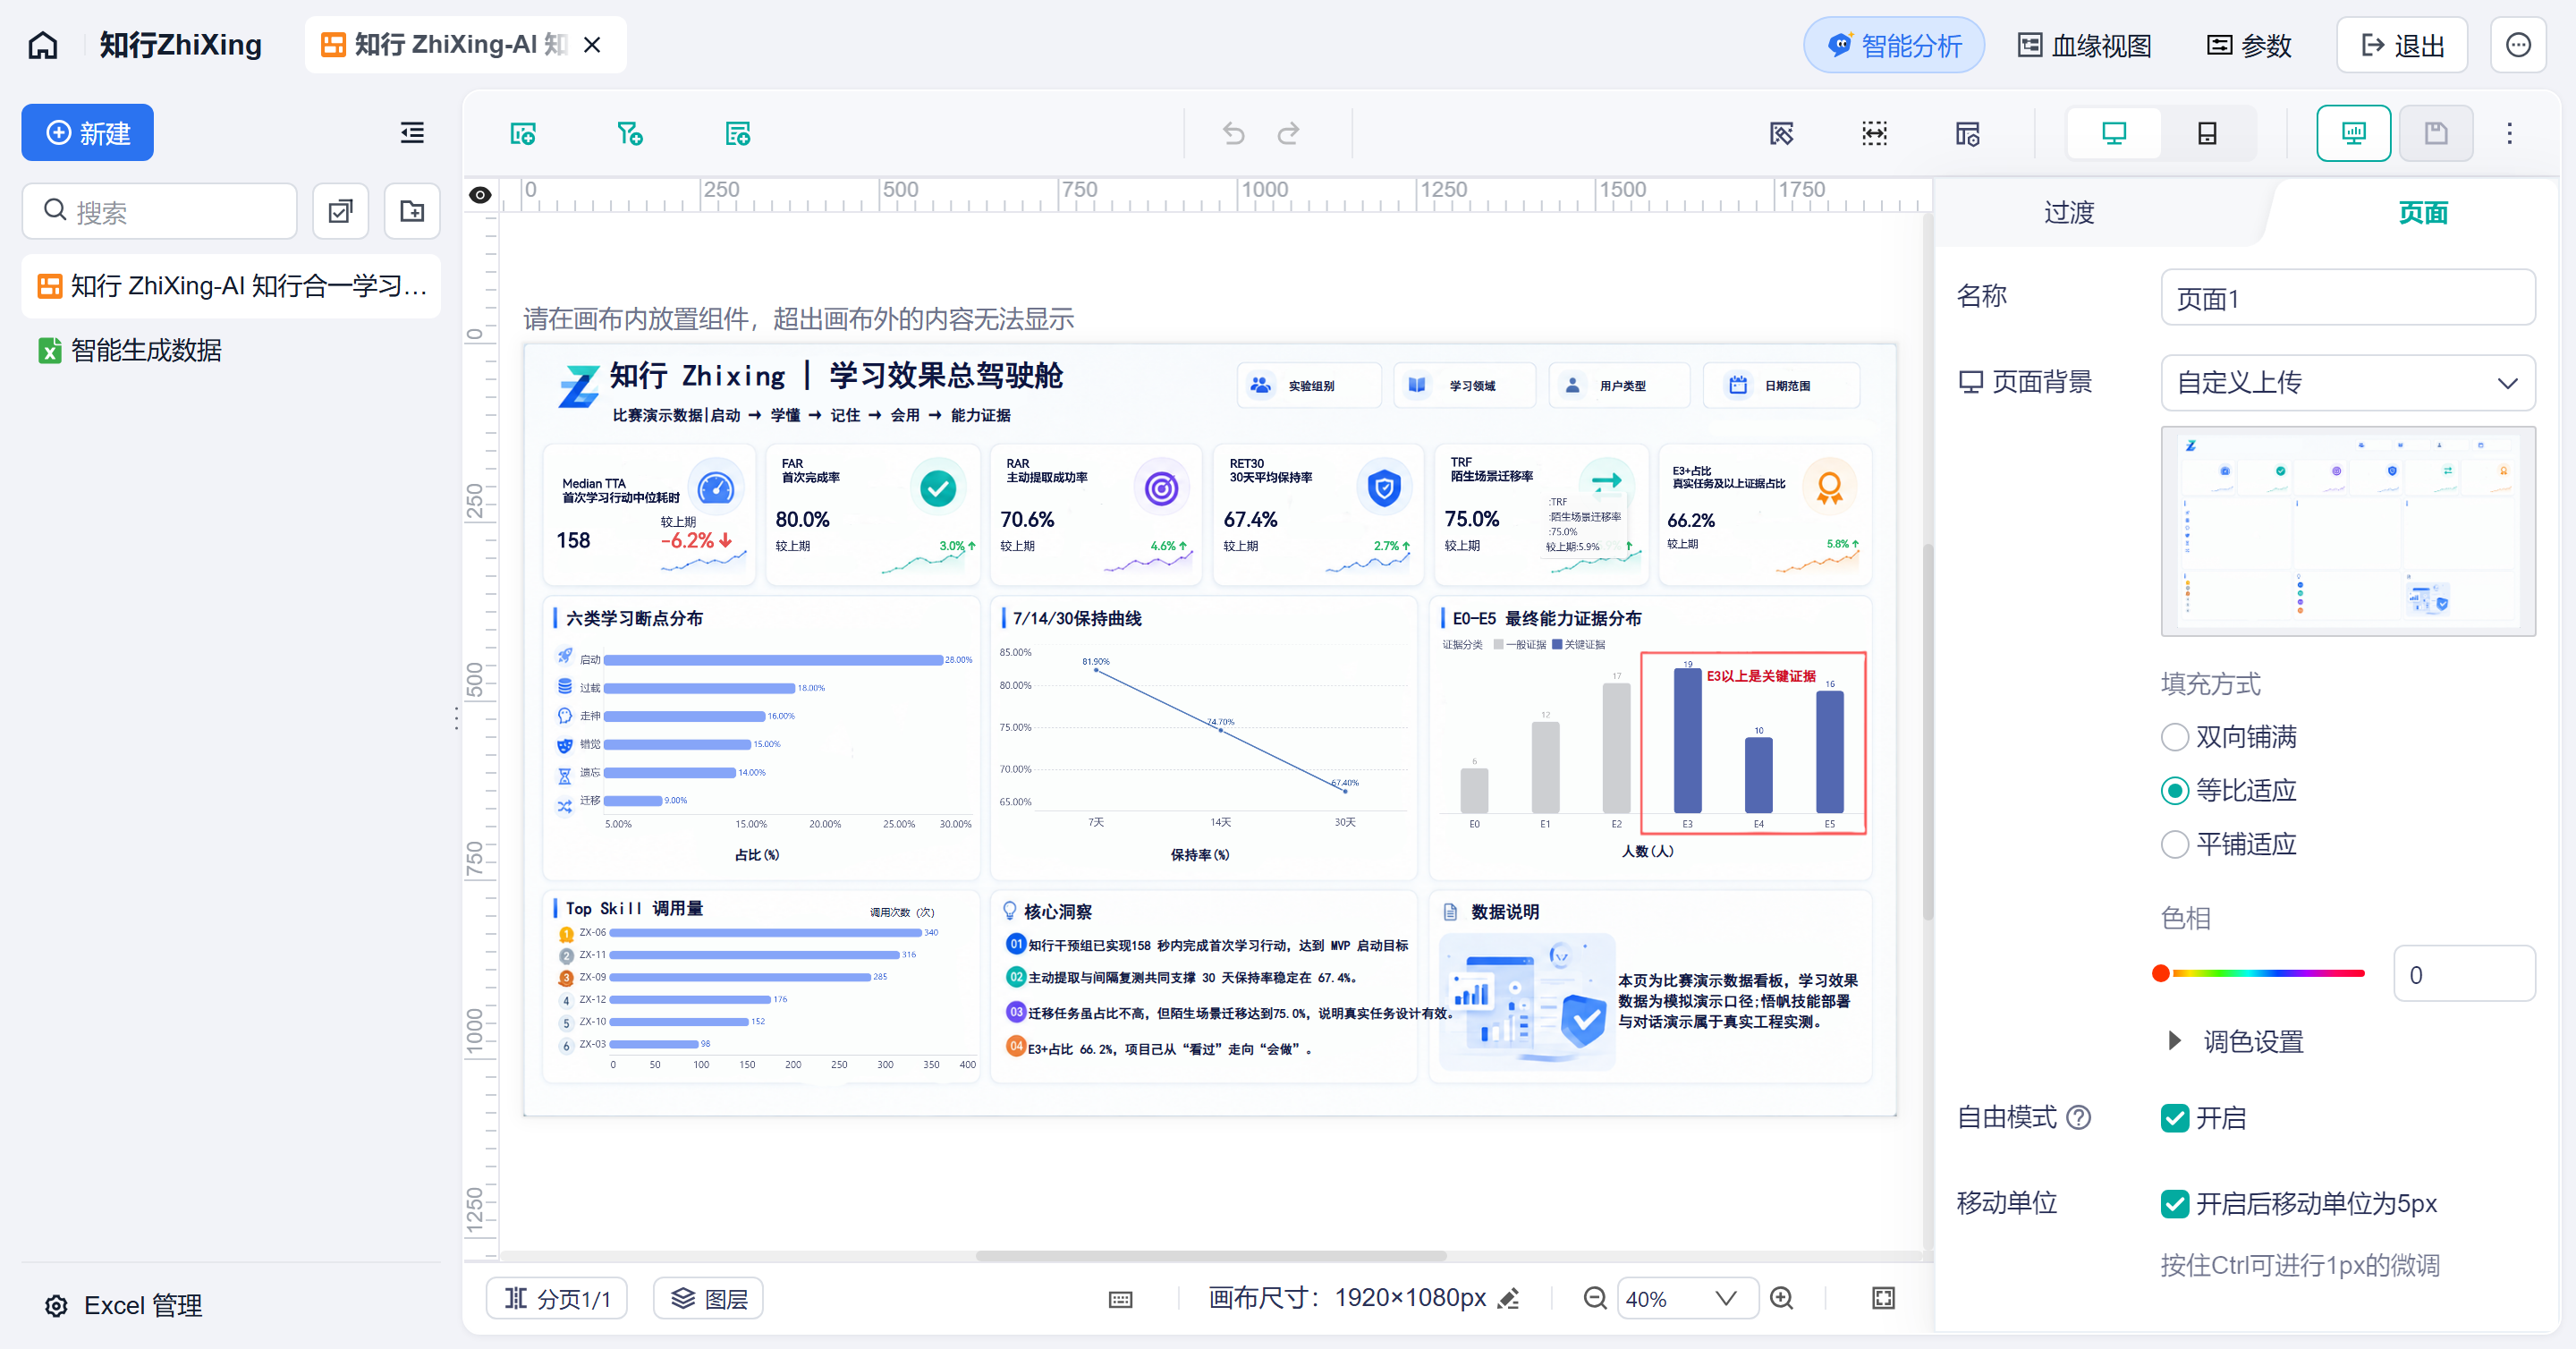
8.5 FineNext展示
链接:https://next.finebi.com/decision/application/13f29d91ff8844e7aee92084eb423d
制作步骤:
悟道平台导出数据导入FineNext。
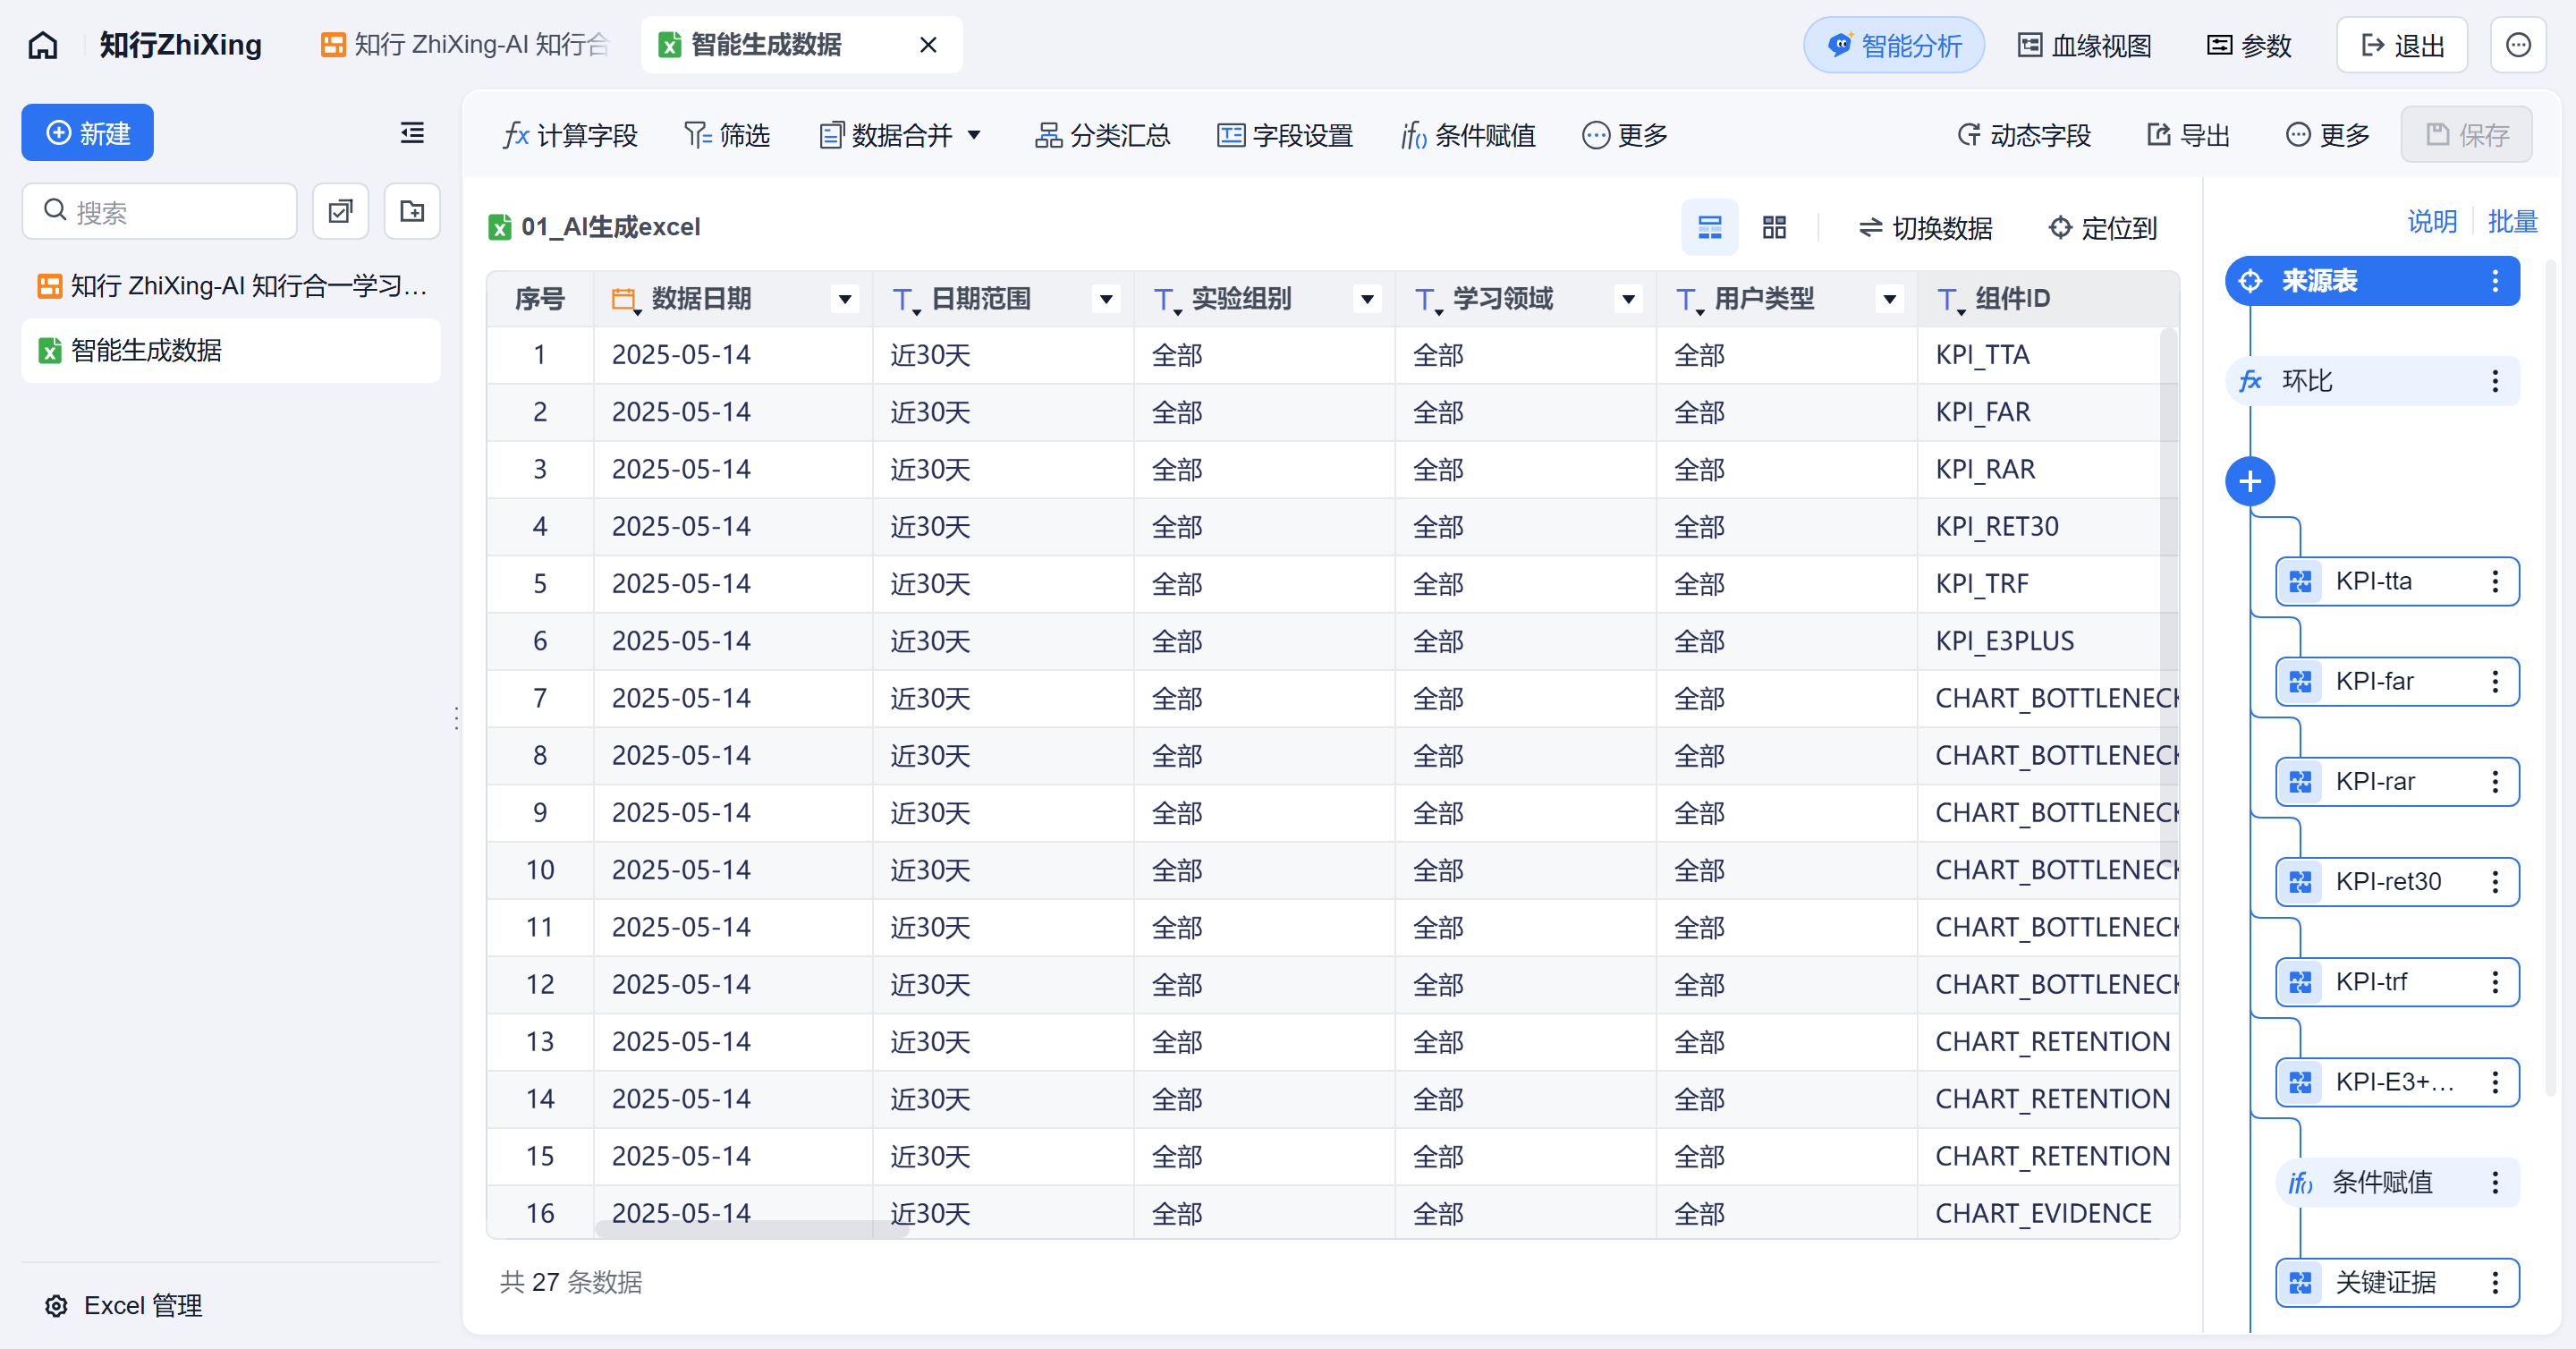
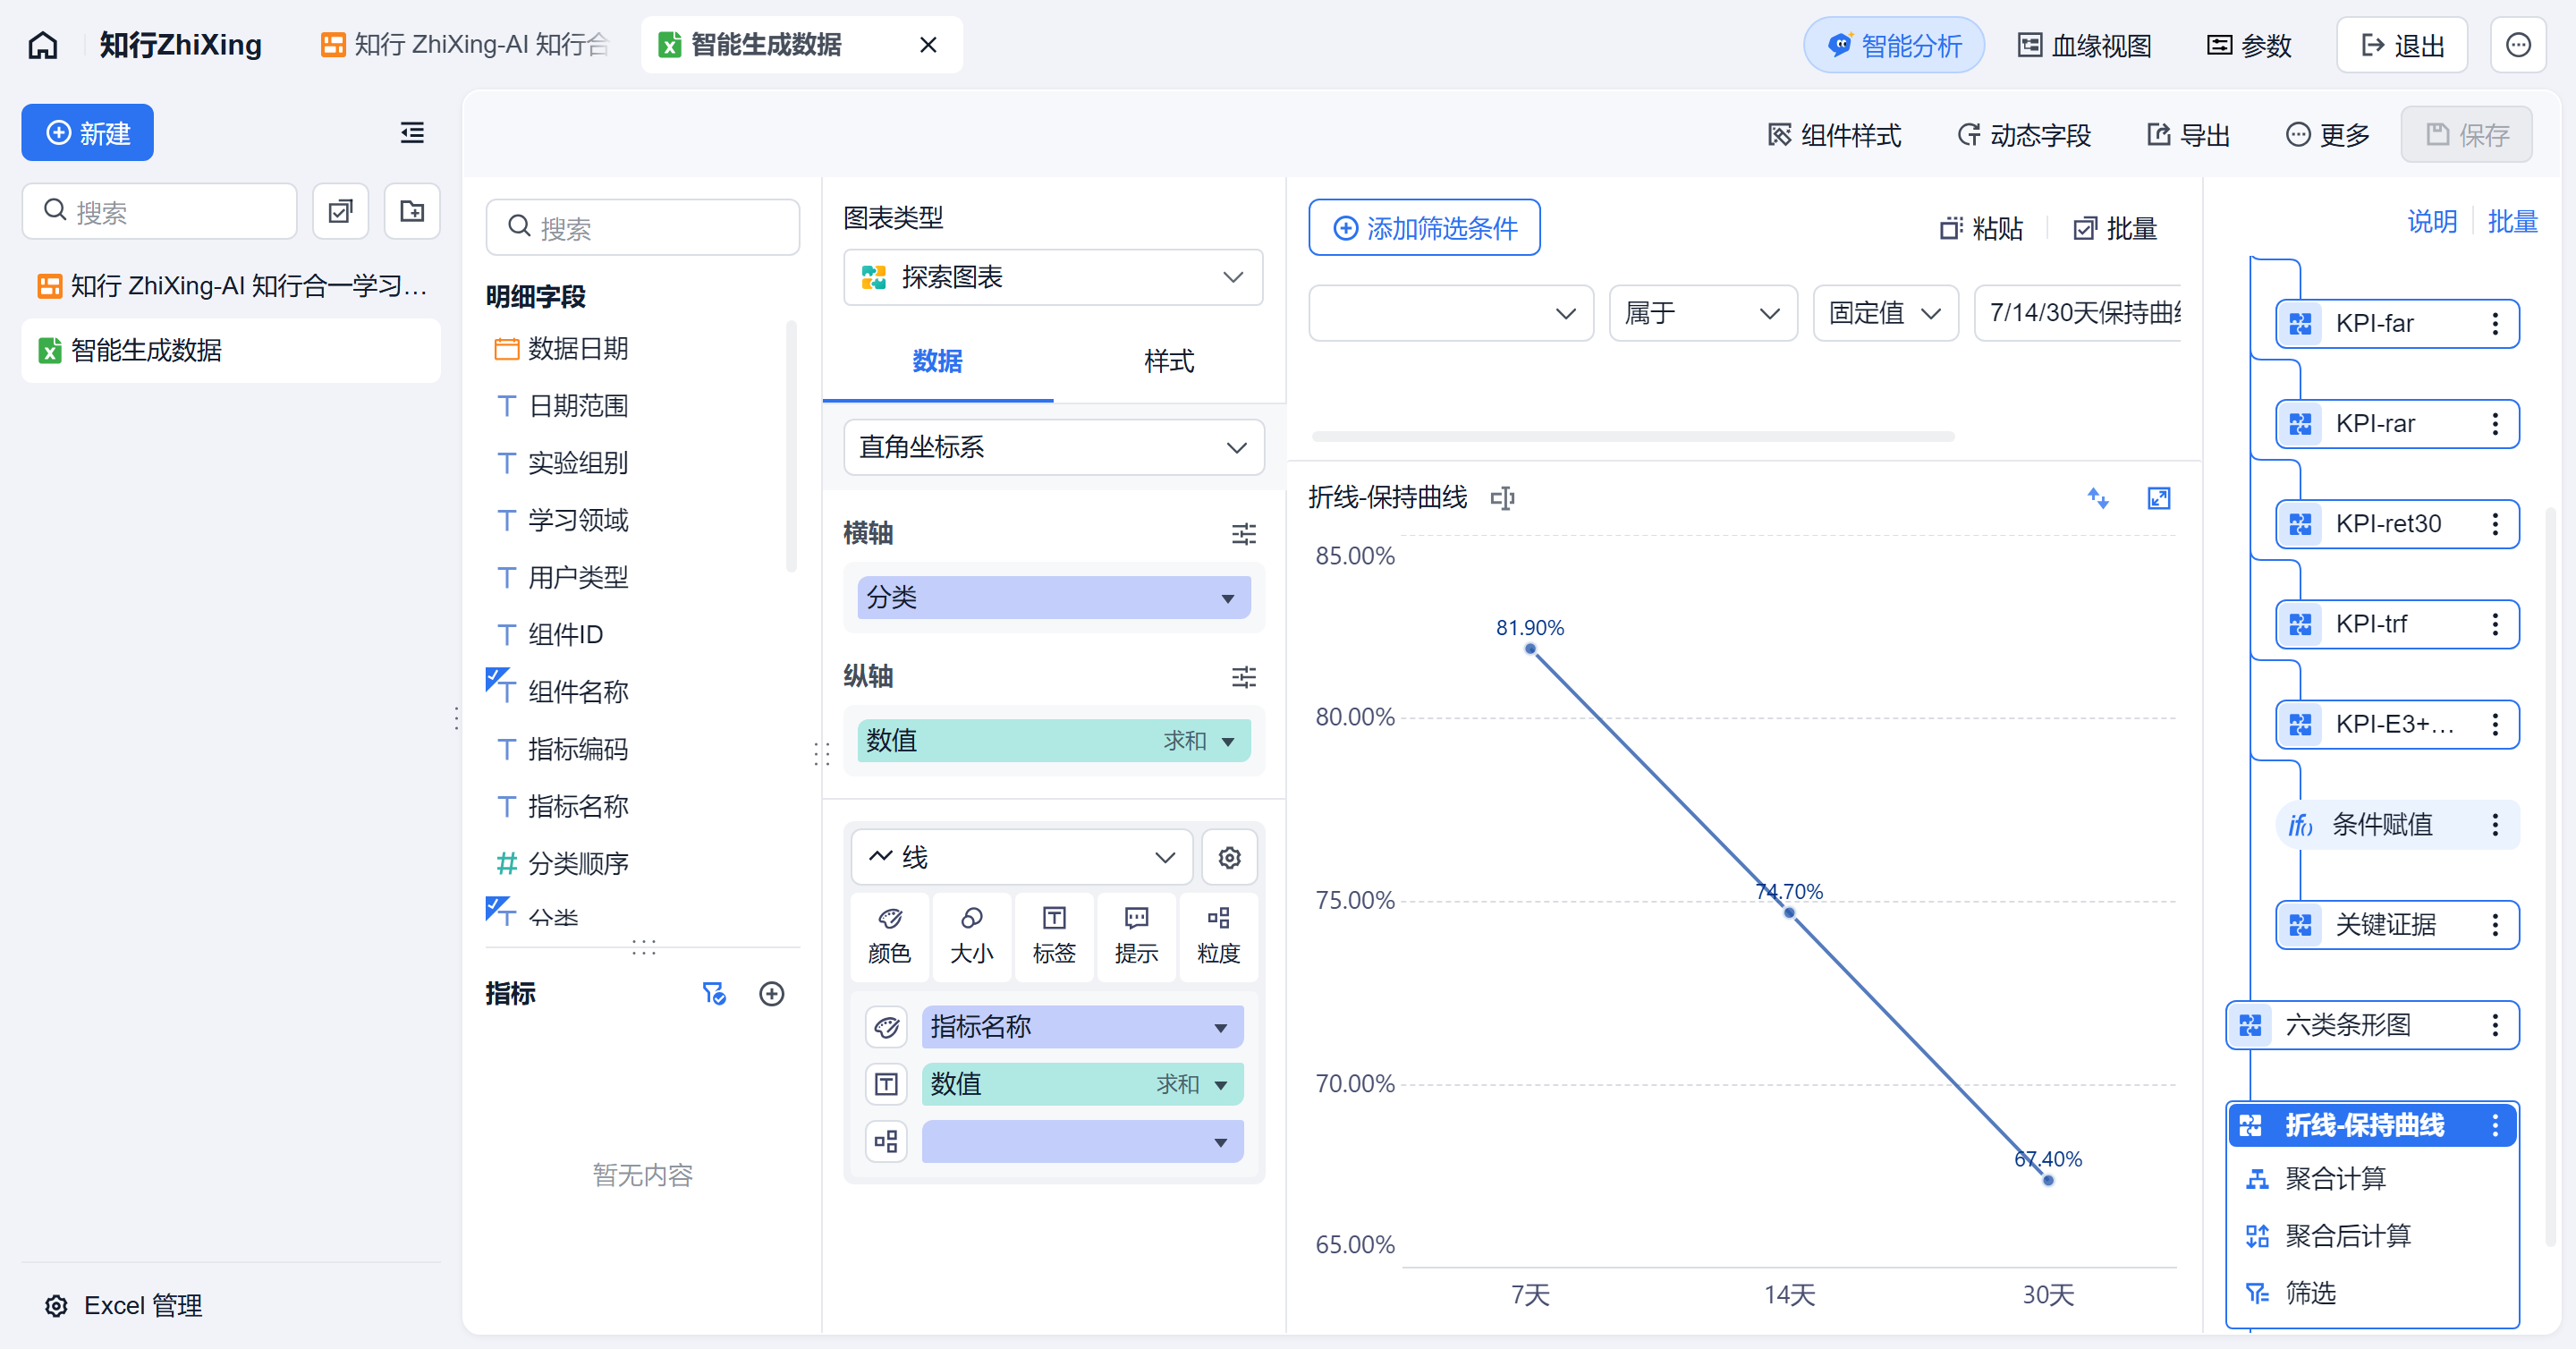
Kpi组件制作
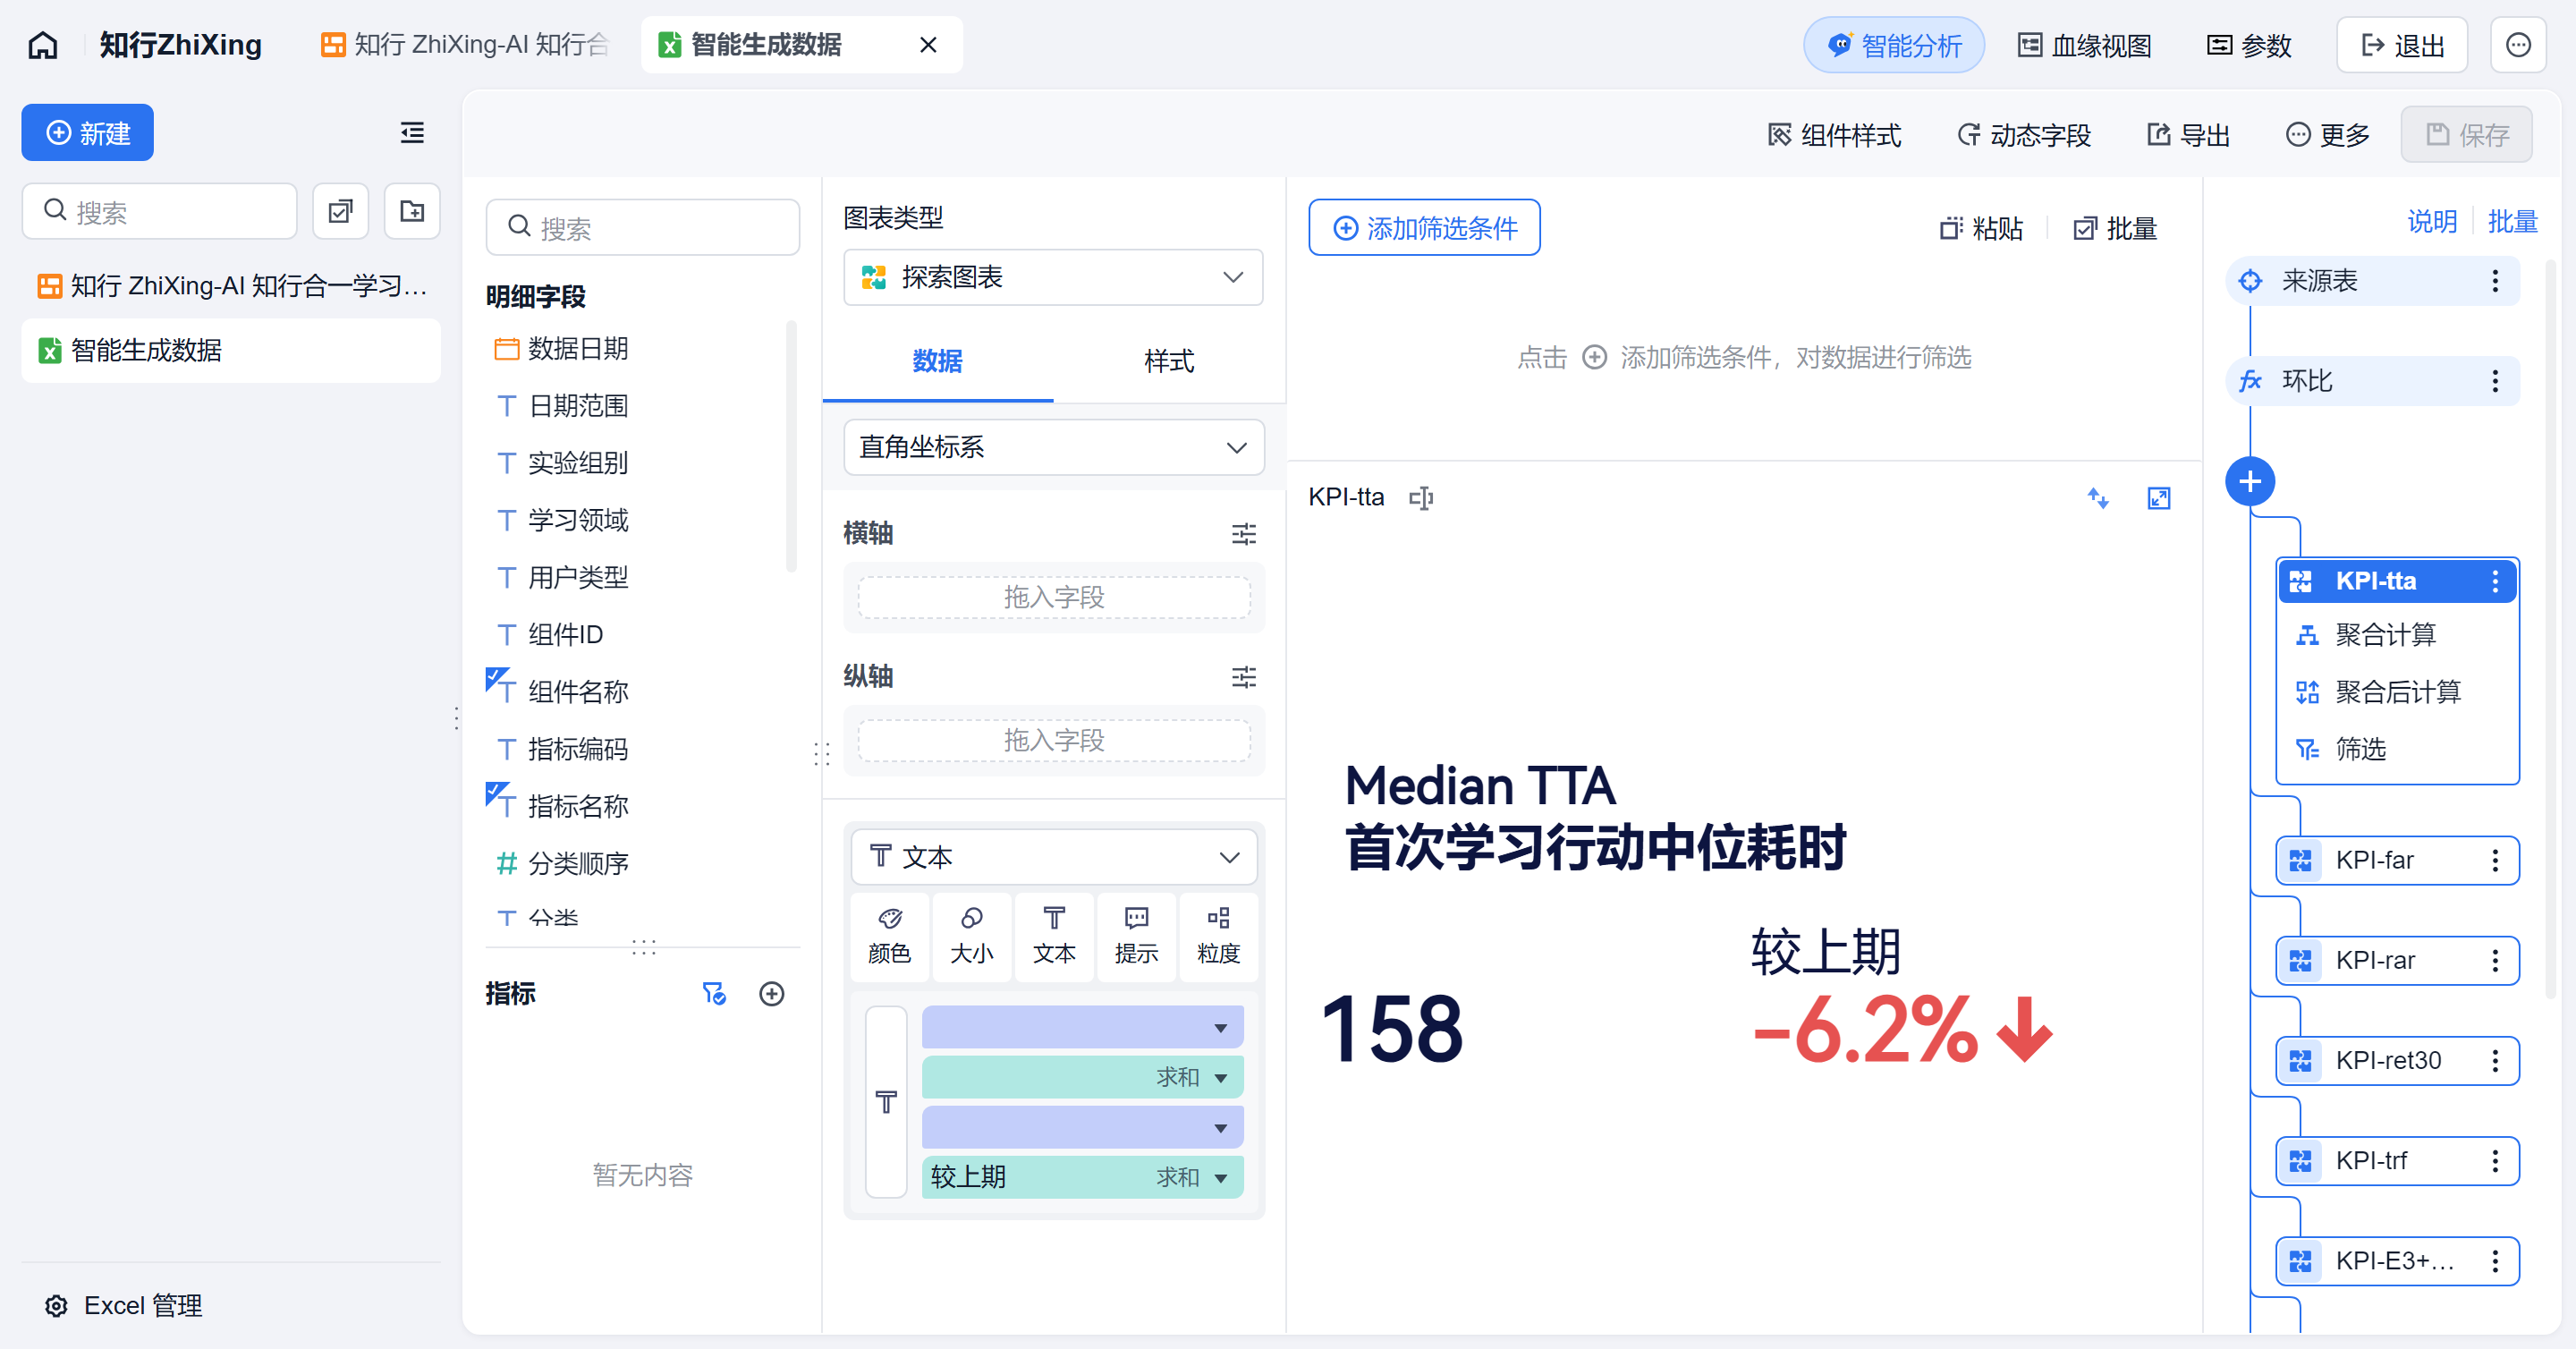
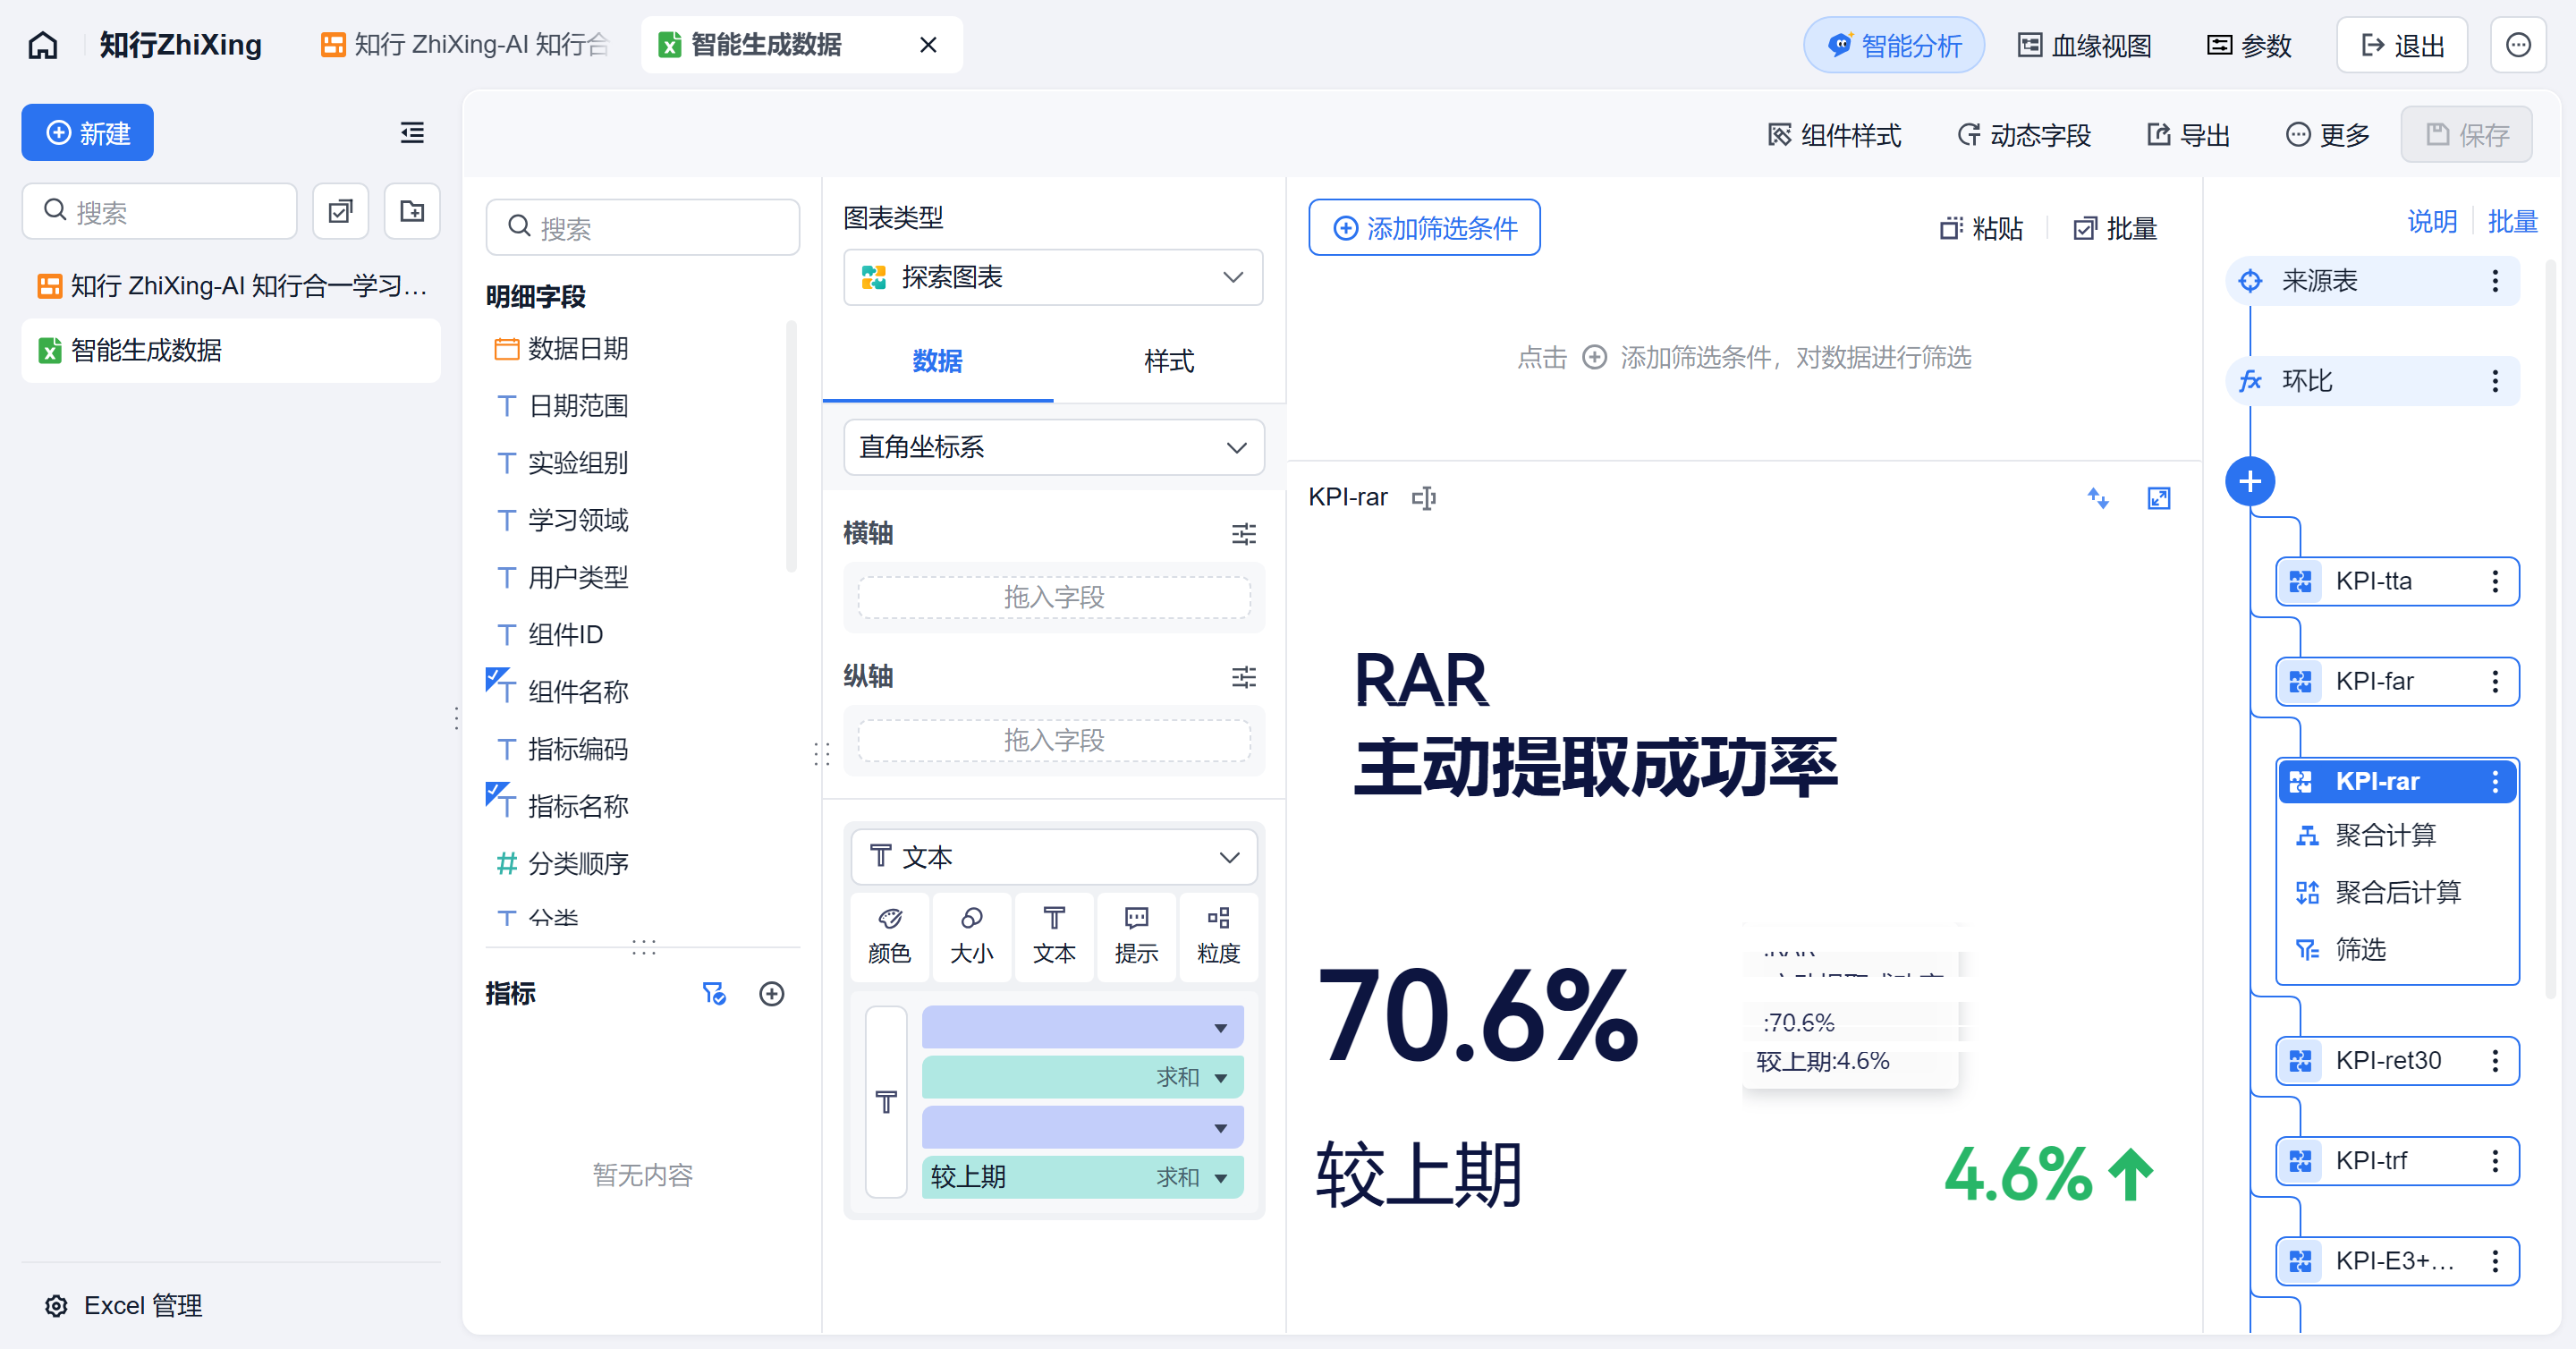
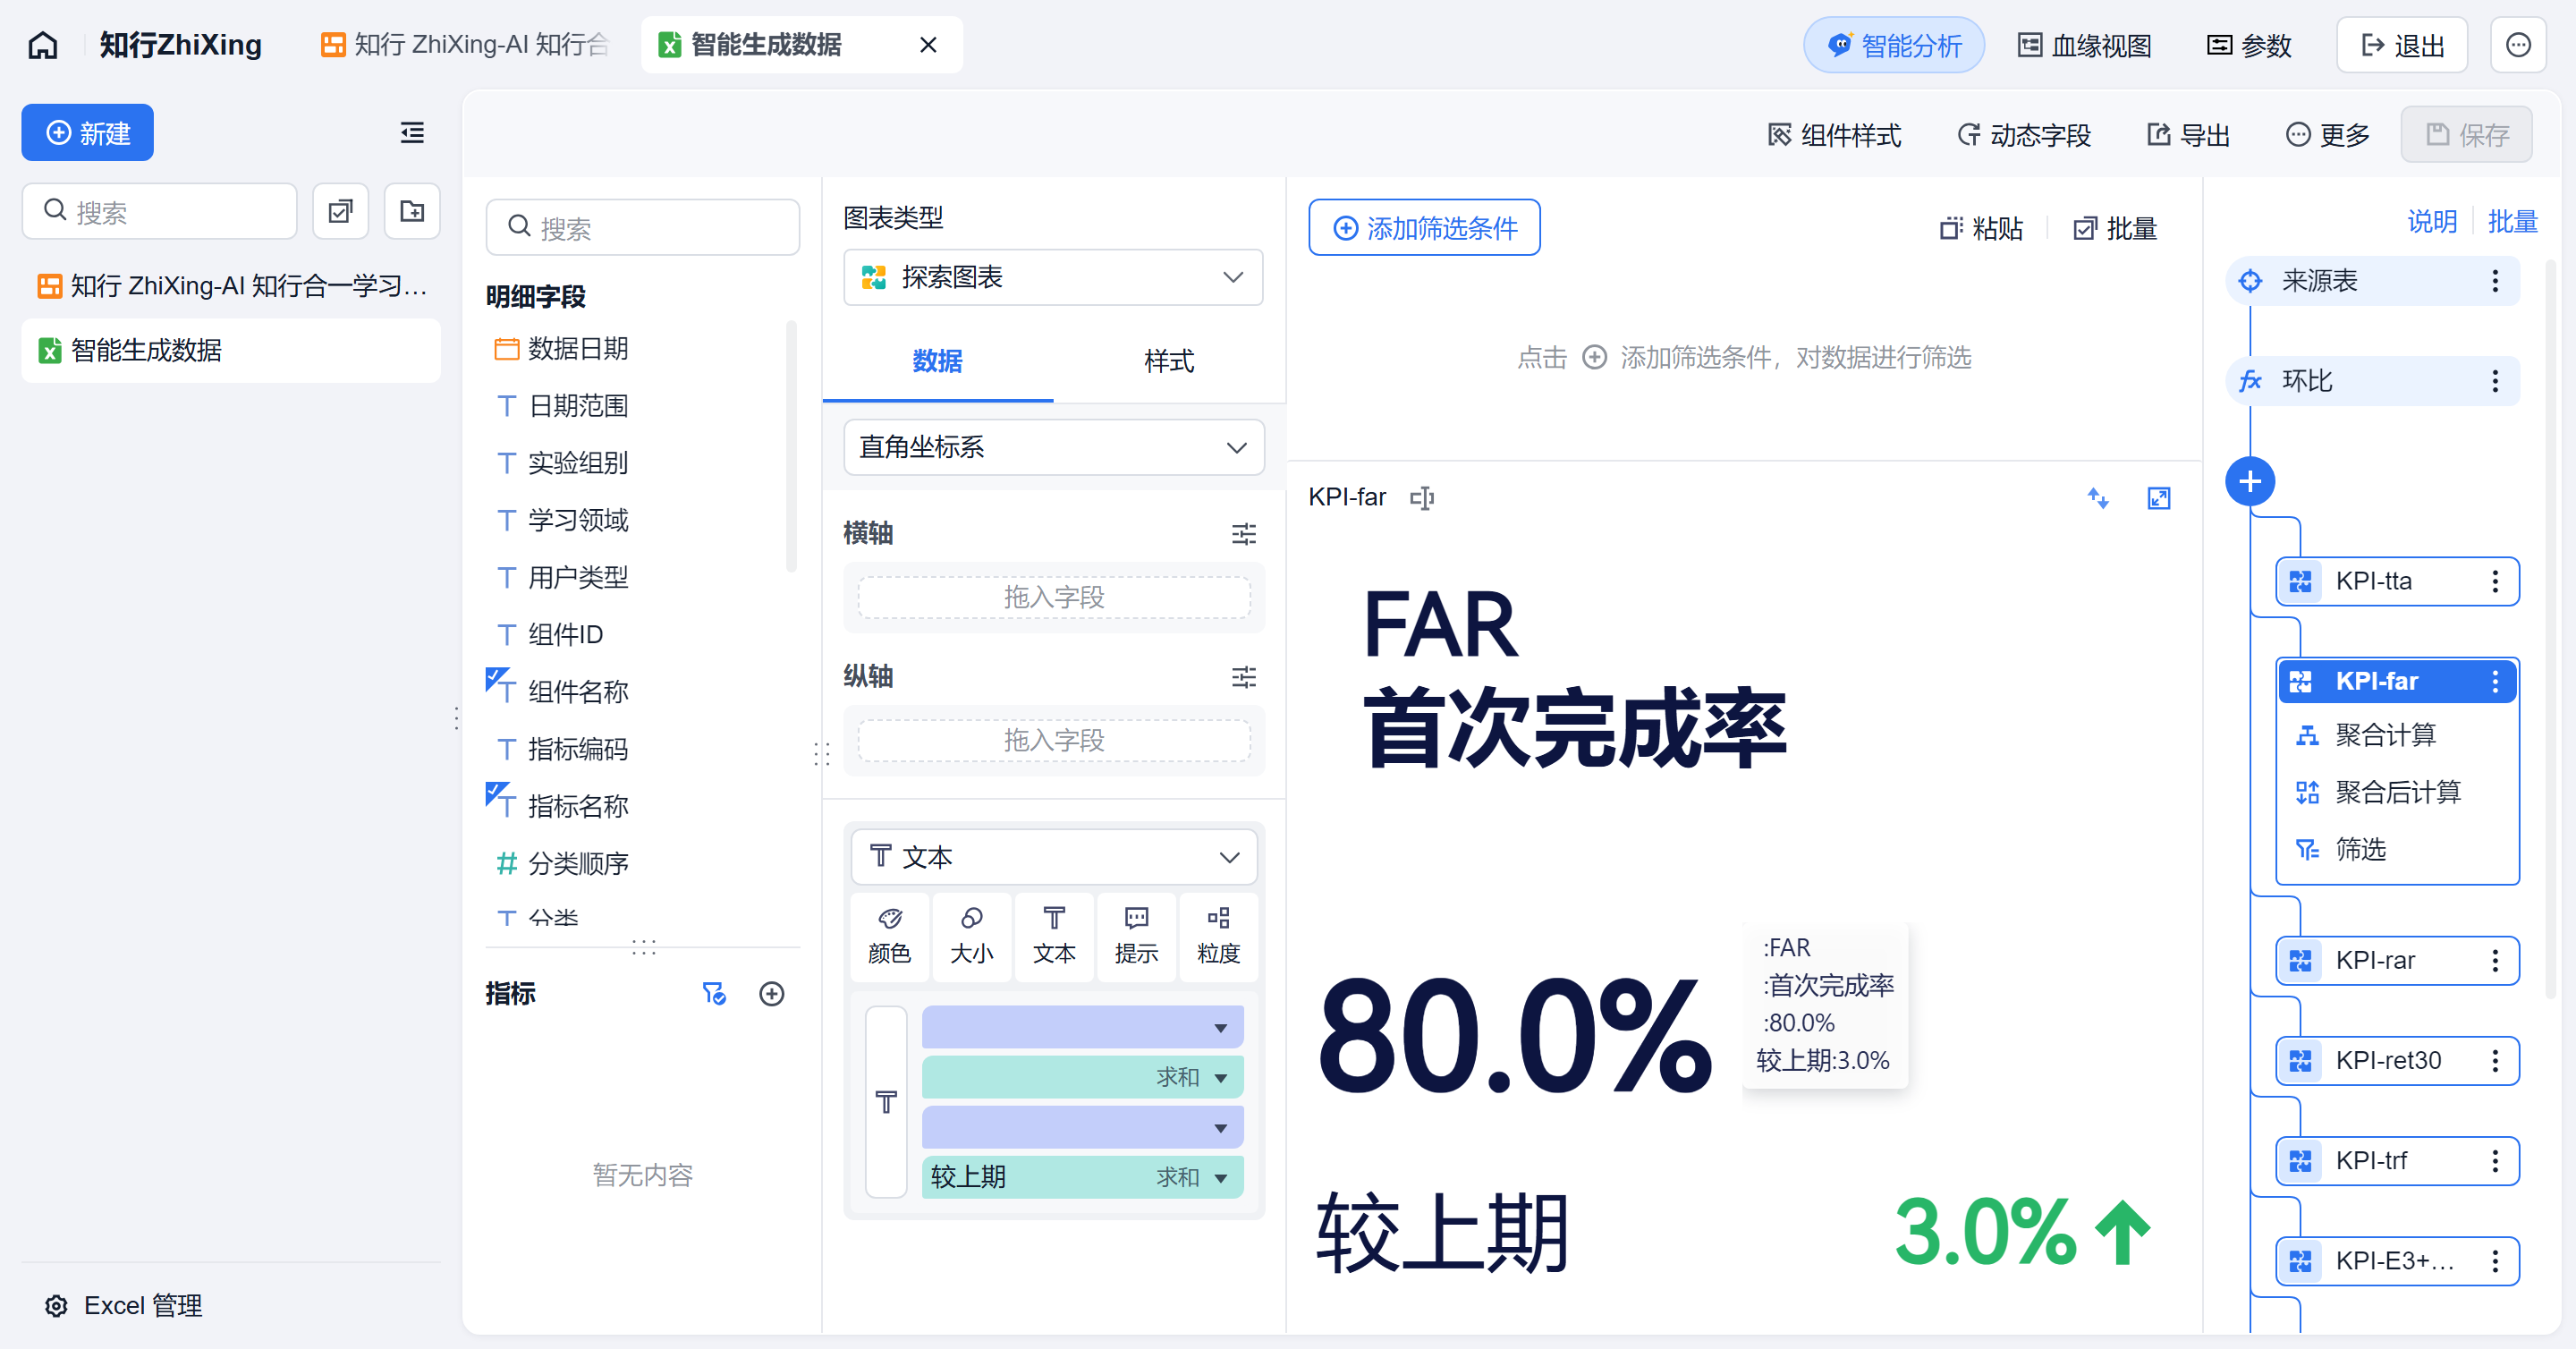
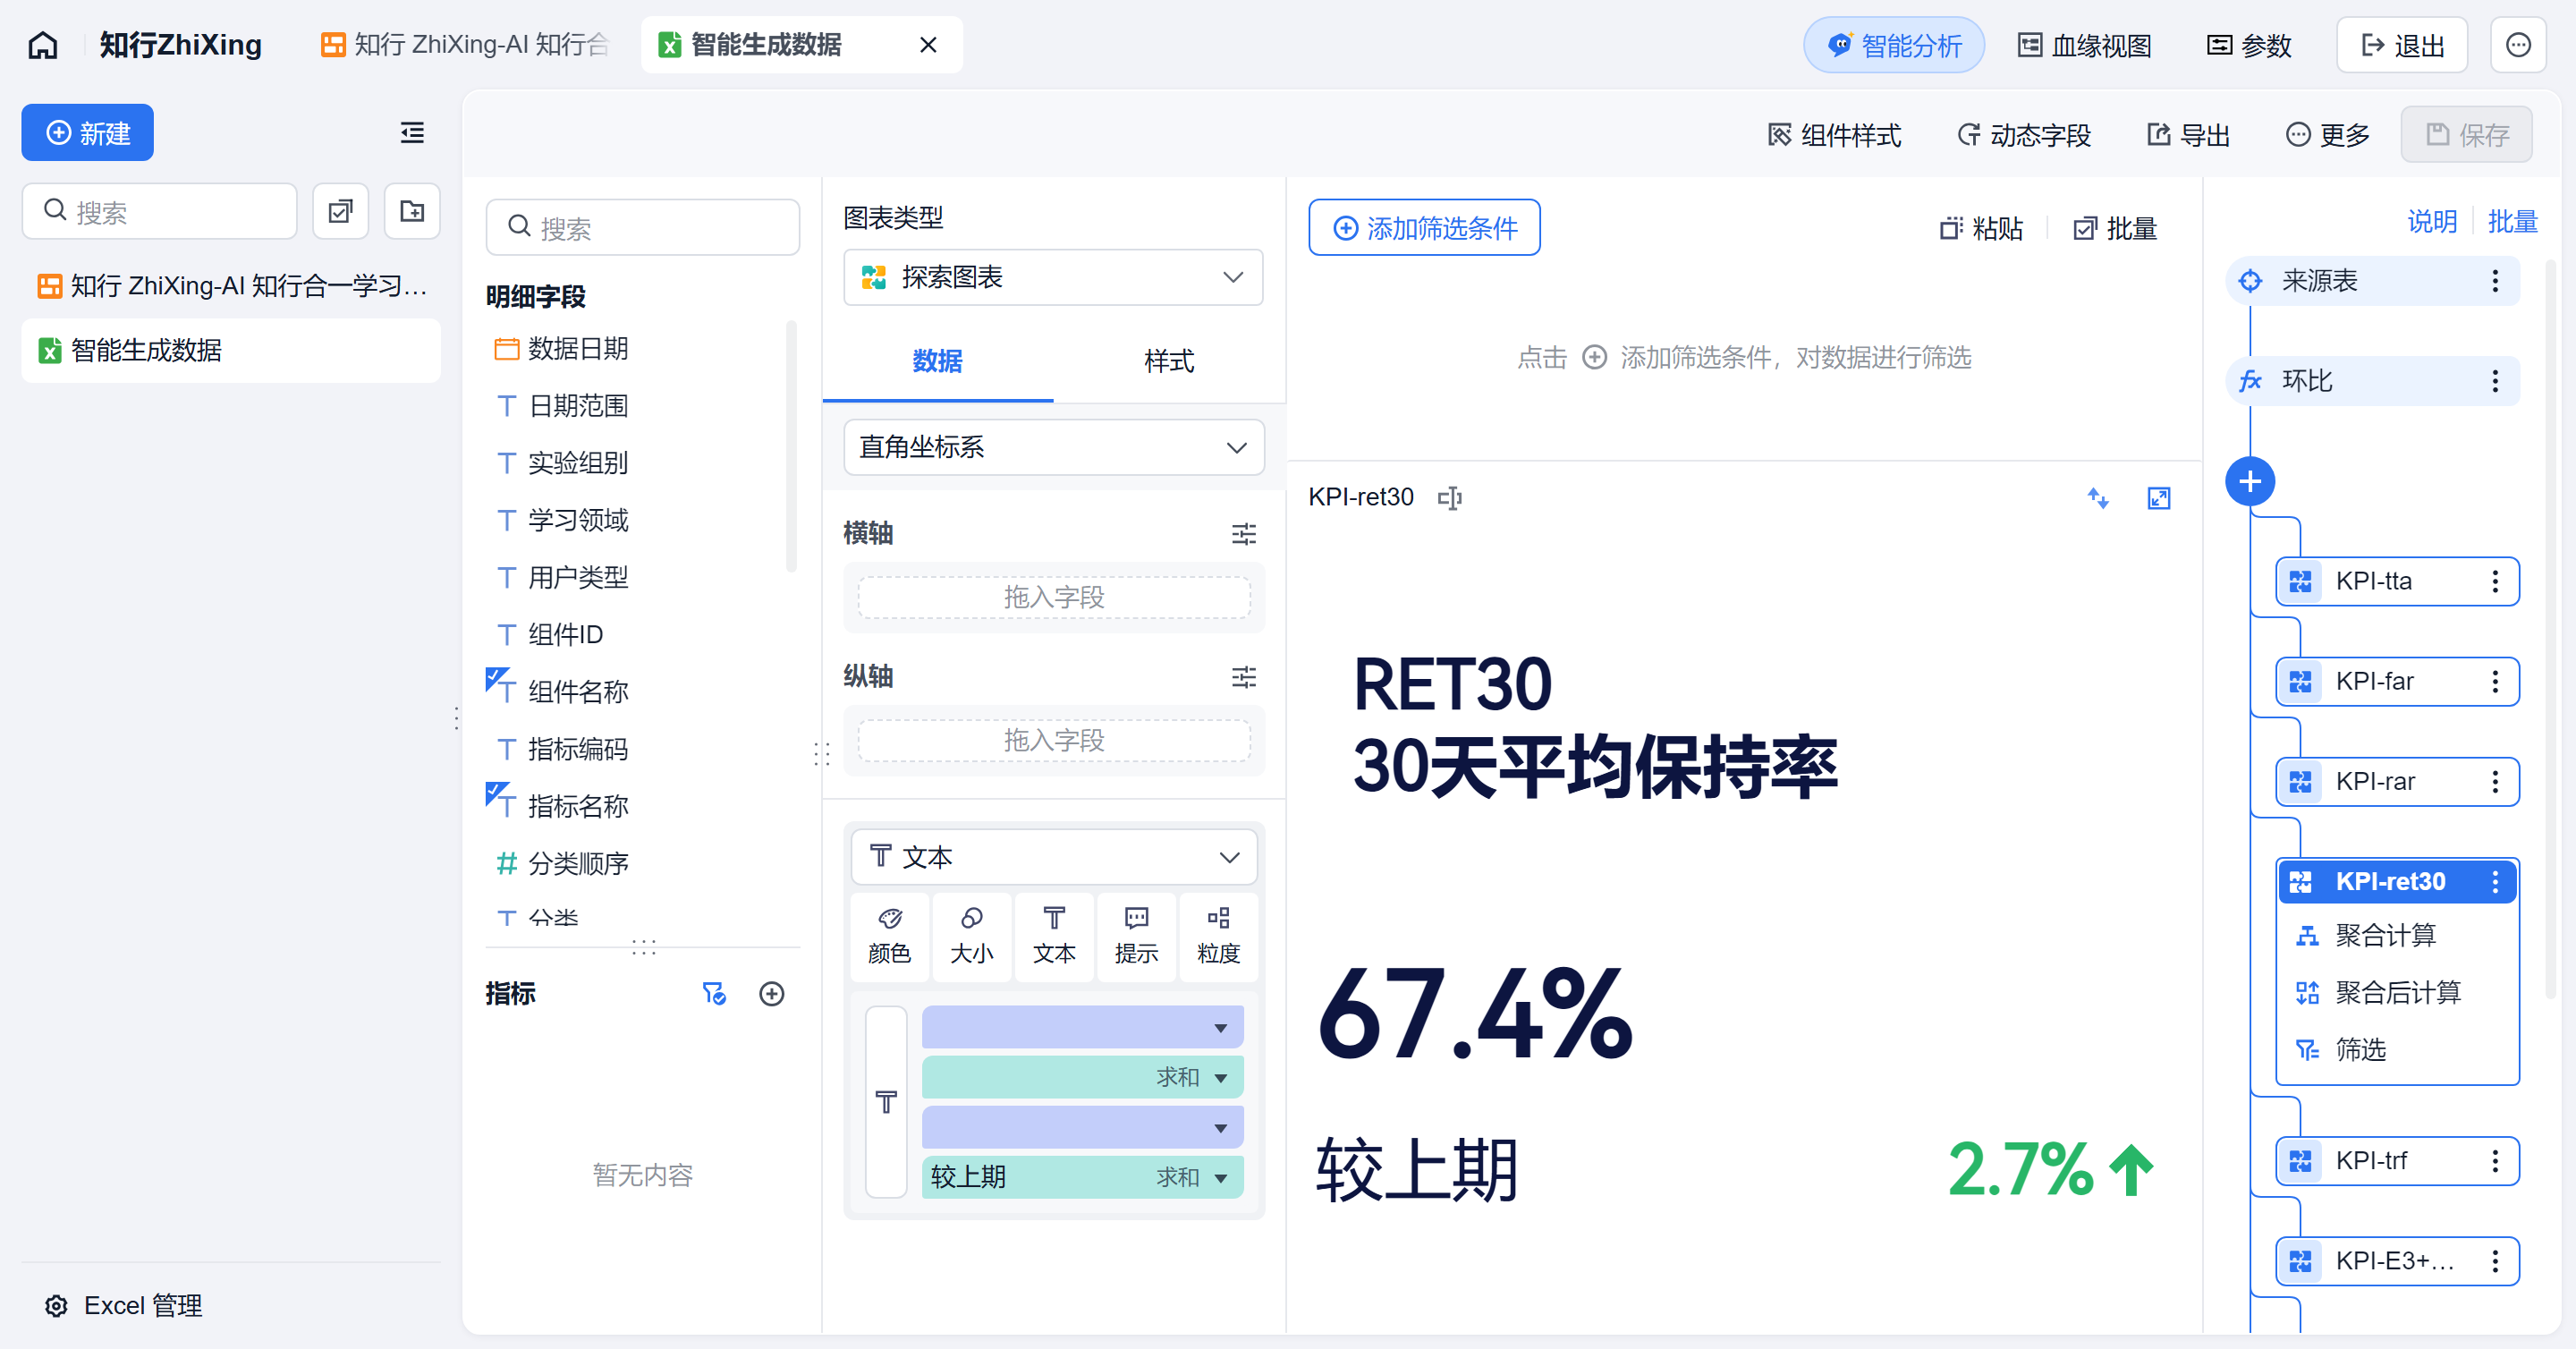
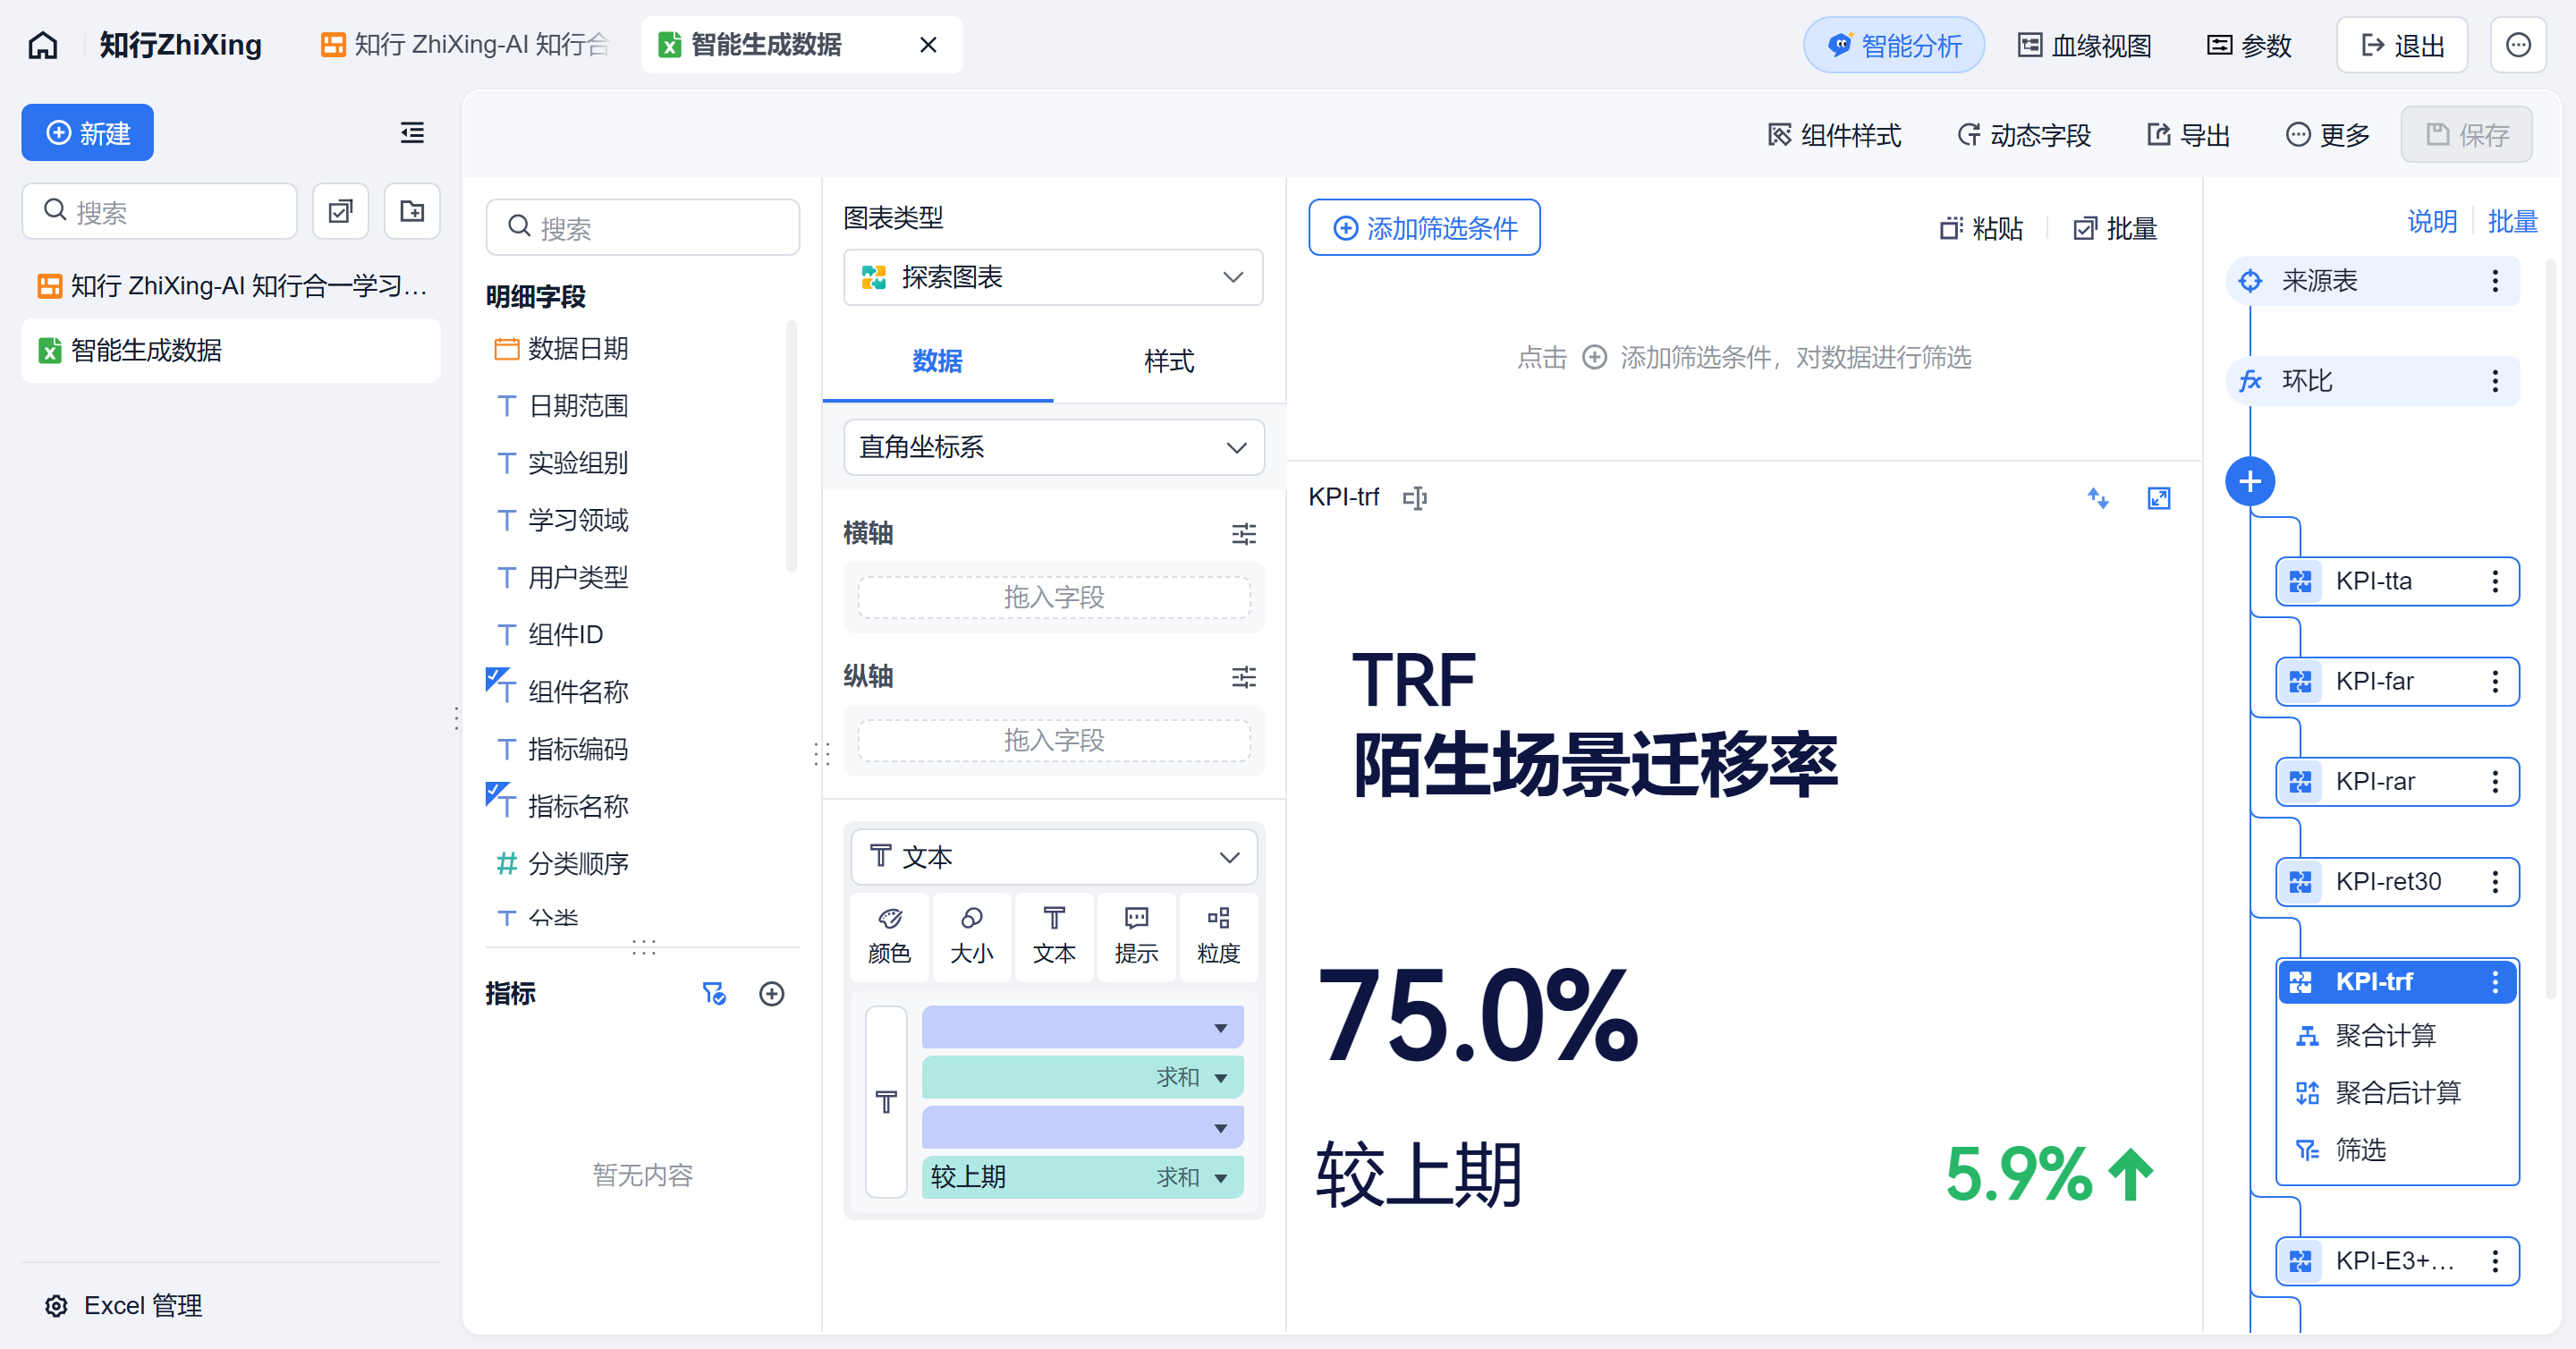
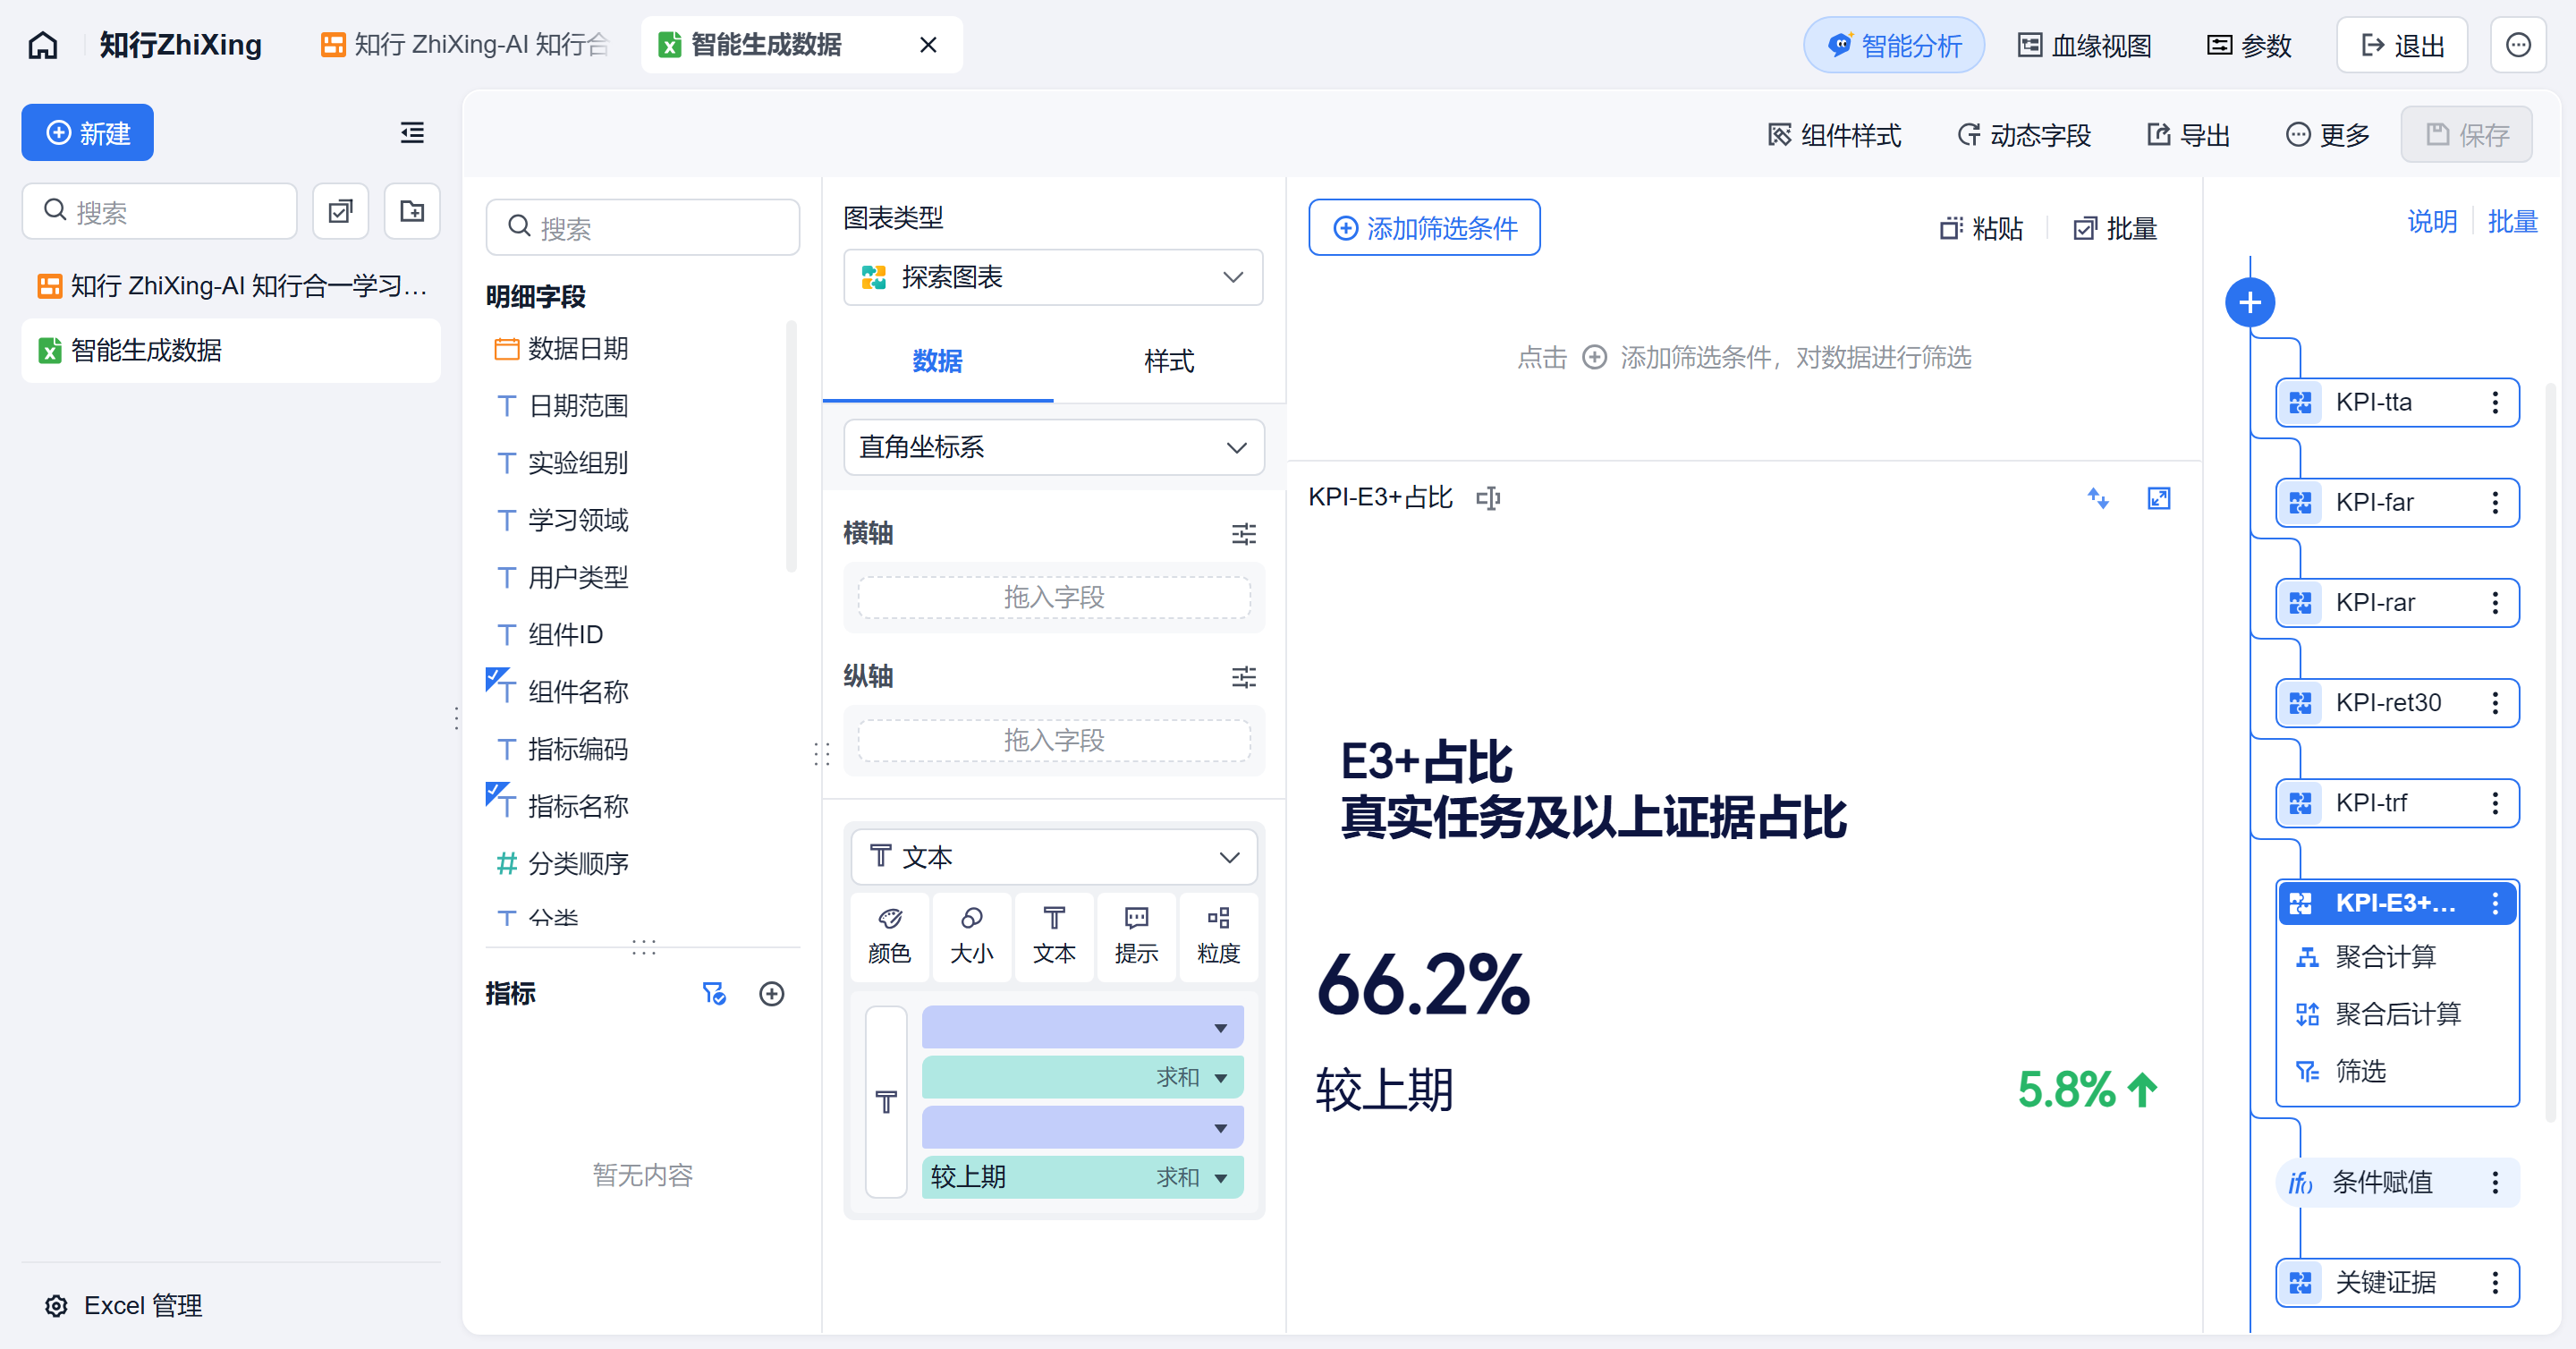
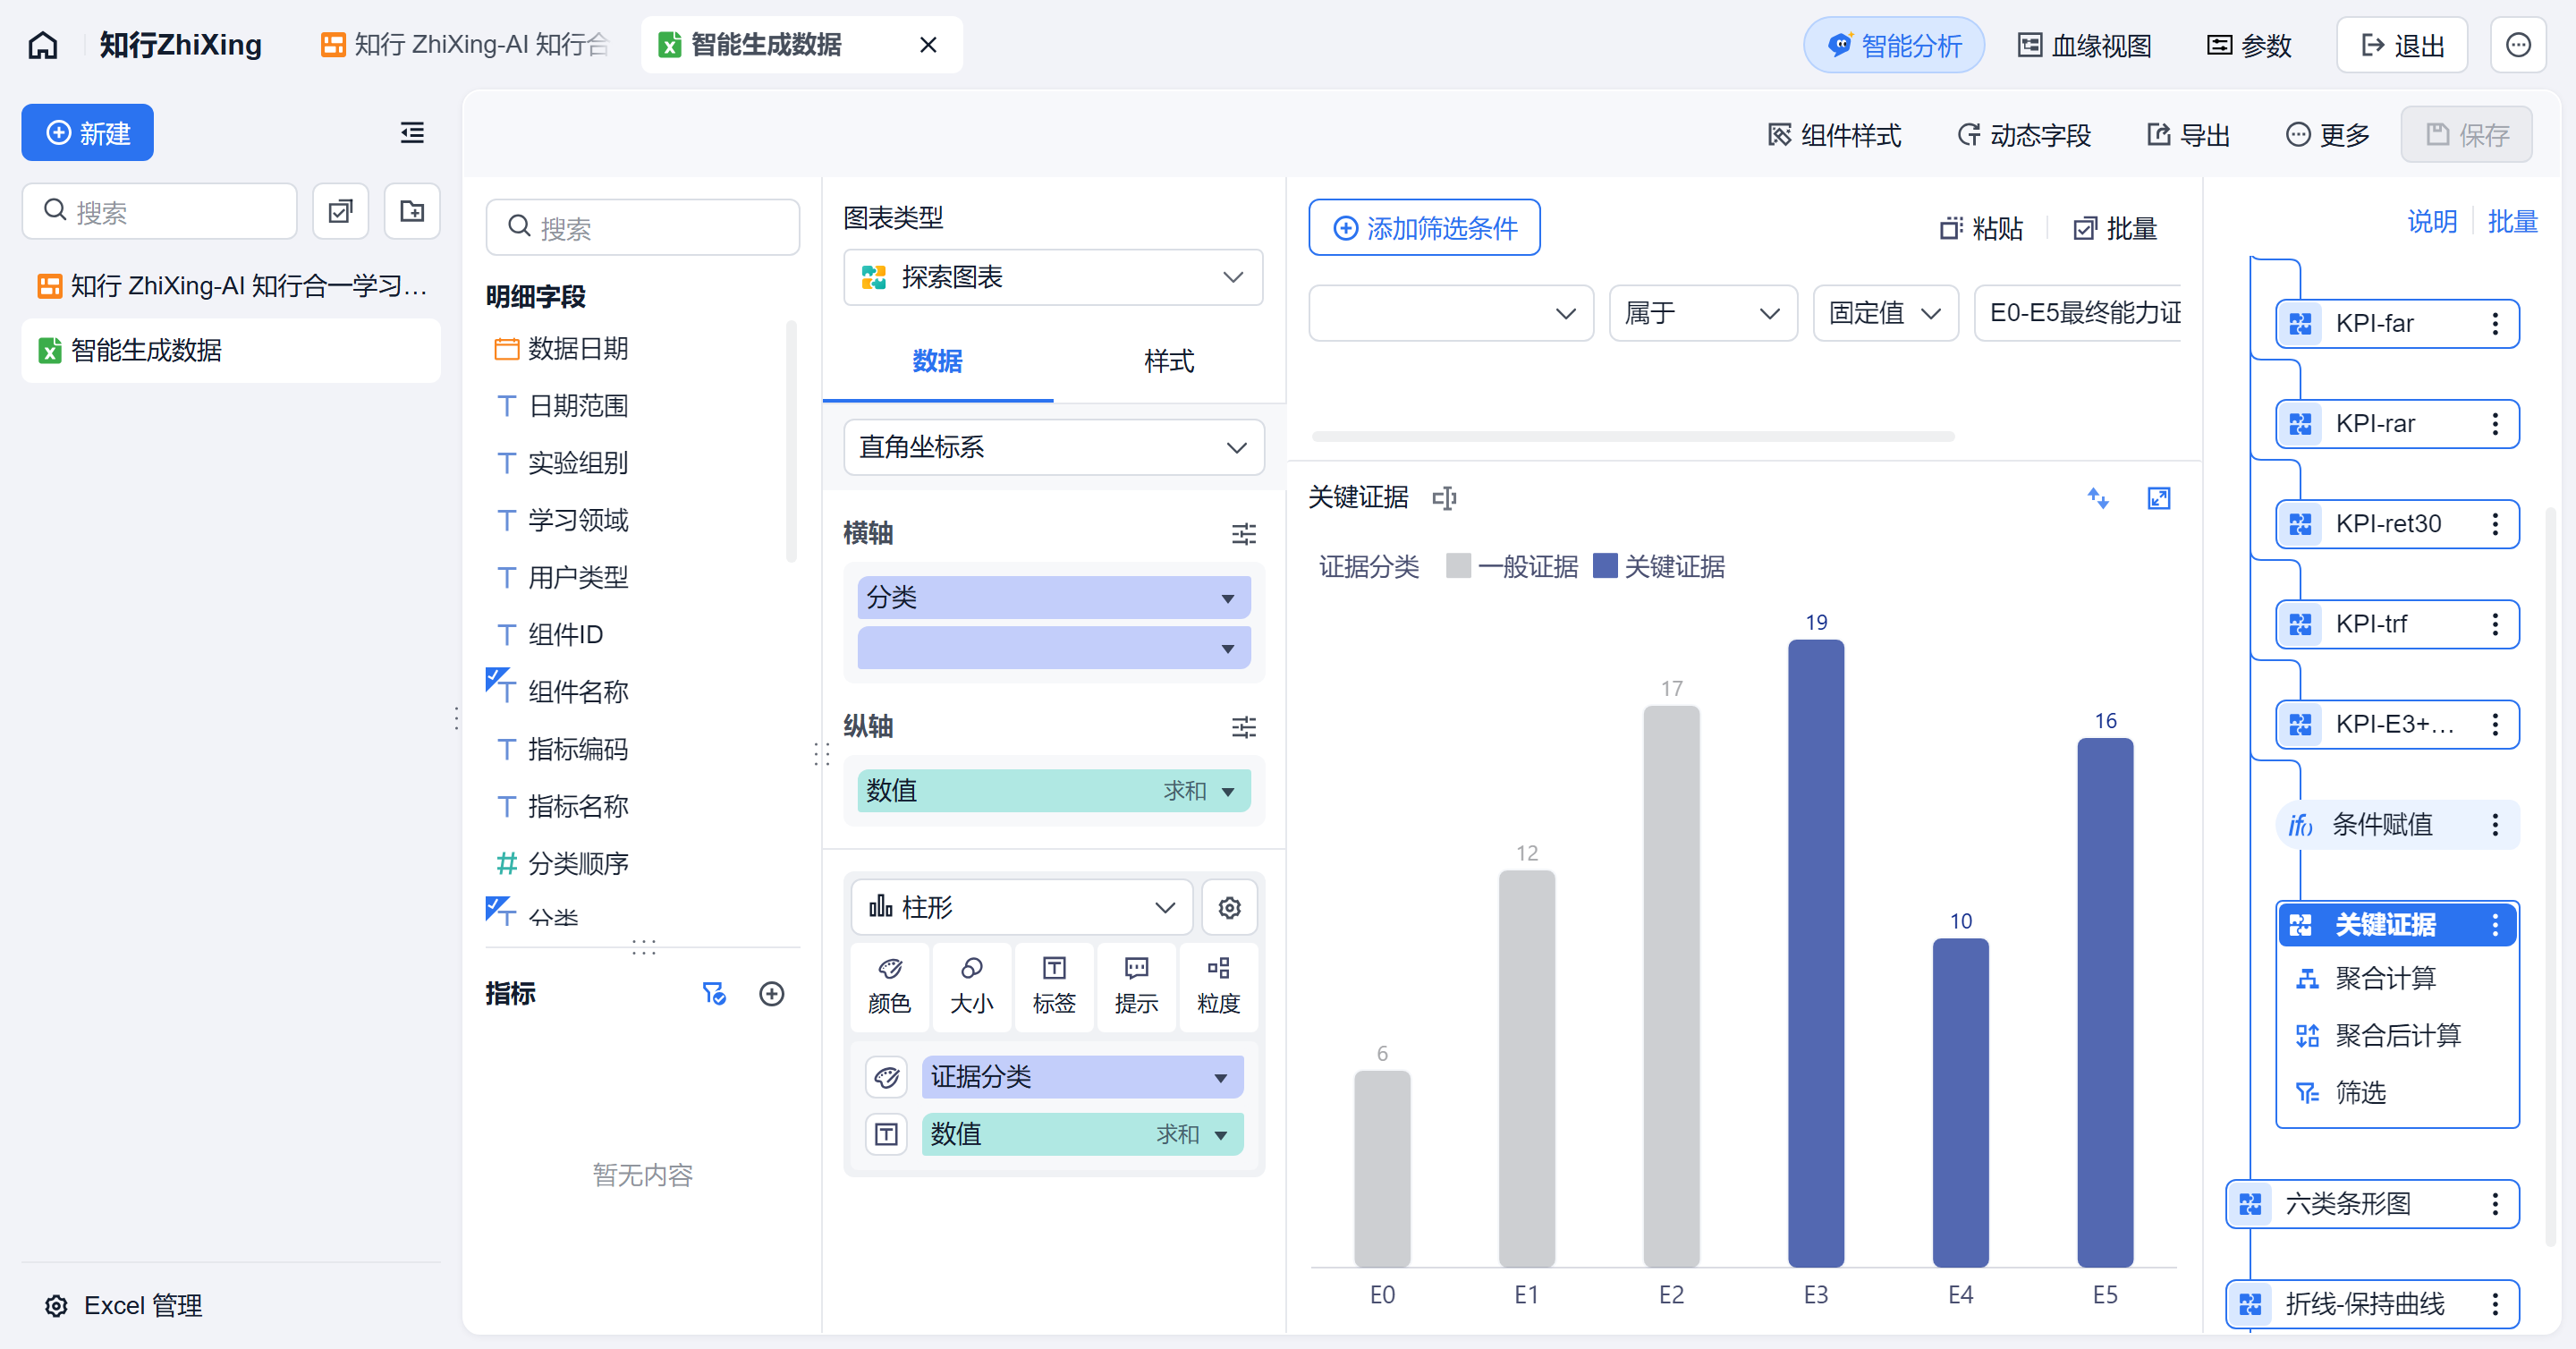
证据分类柱形图制作。
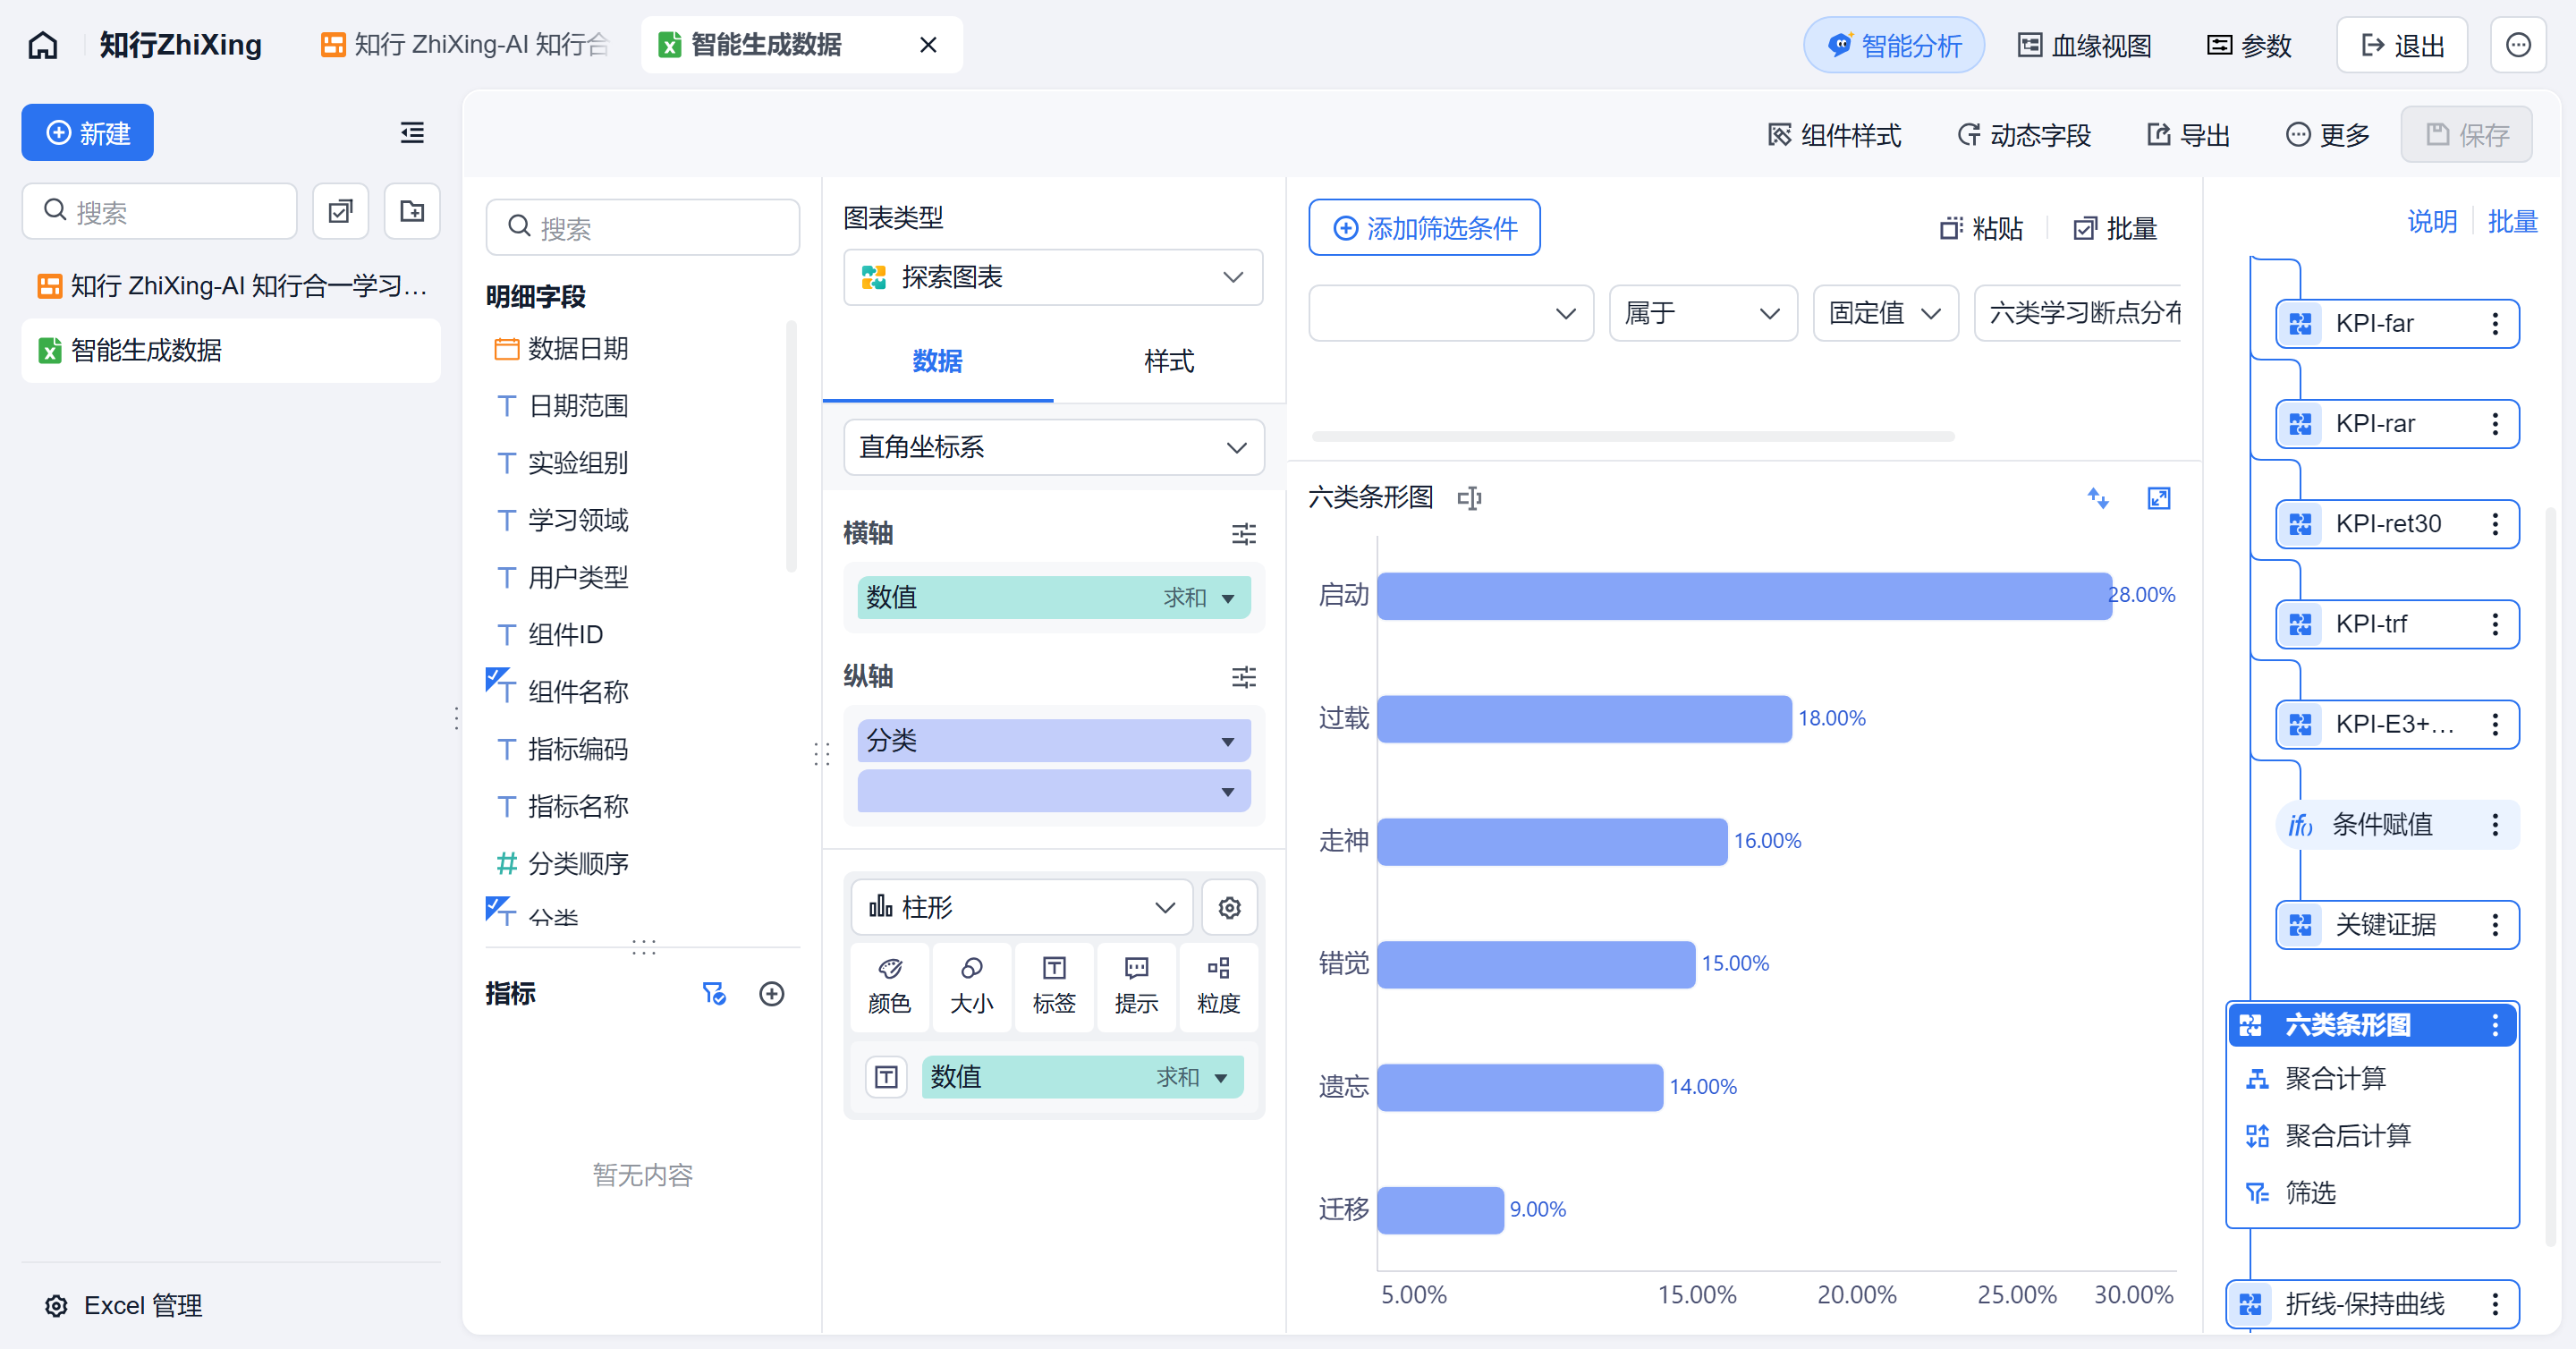
六类条形图制作。
保持曲线制作。
仪表板展示。
09 验证计划、验收与风险控制
项目应从可以被证伪的小问题开始,而不是先定义一个“大而全”的平台价值。启动、保持、迁移分别需要不同时间尺度的数据,也需要不同对照条件。
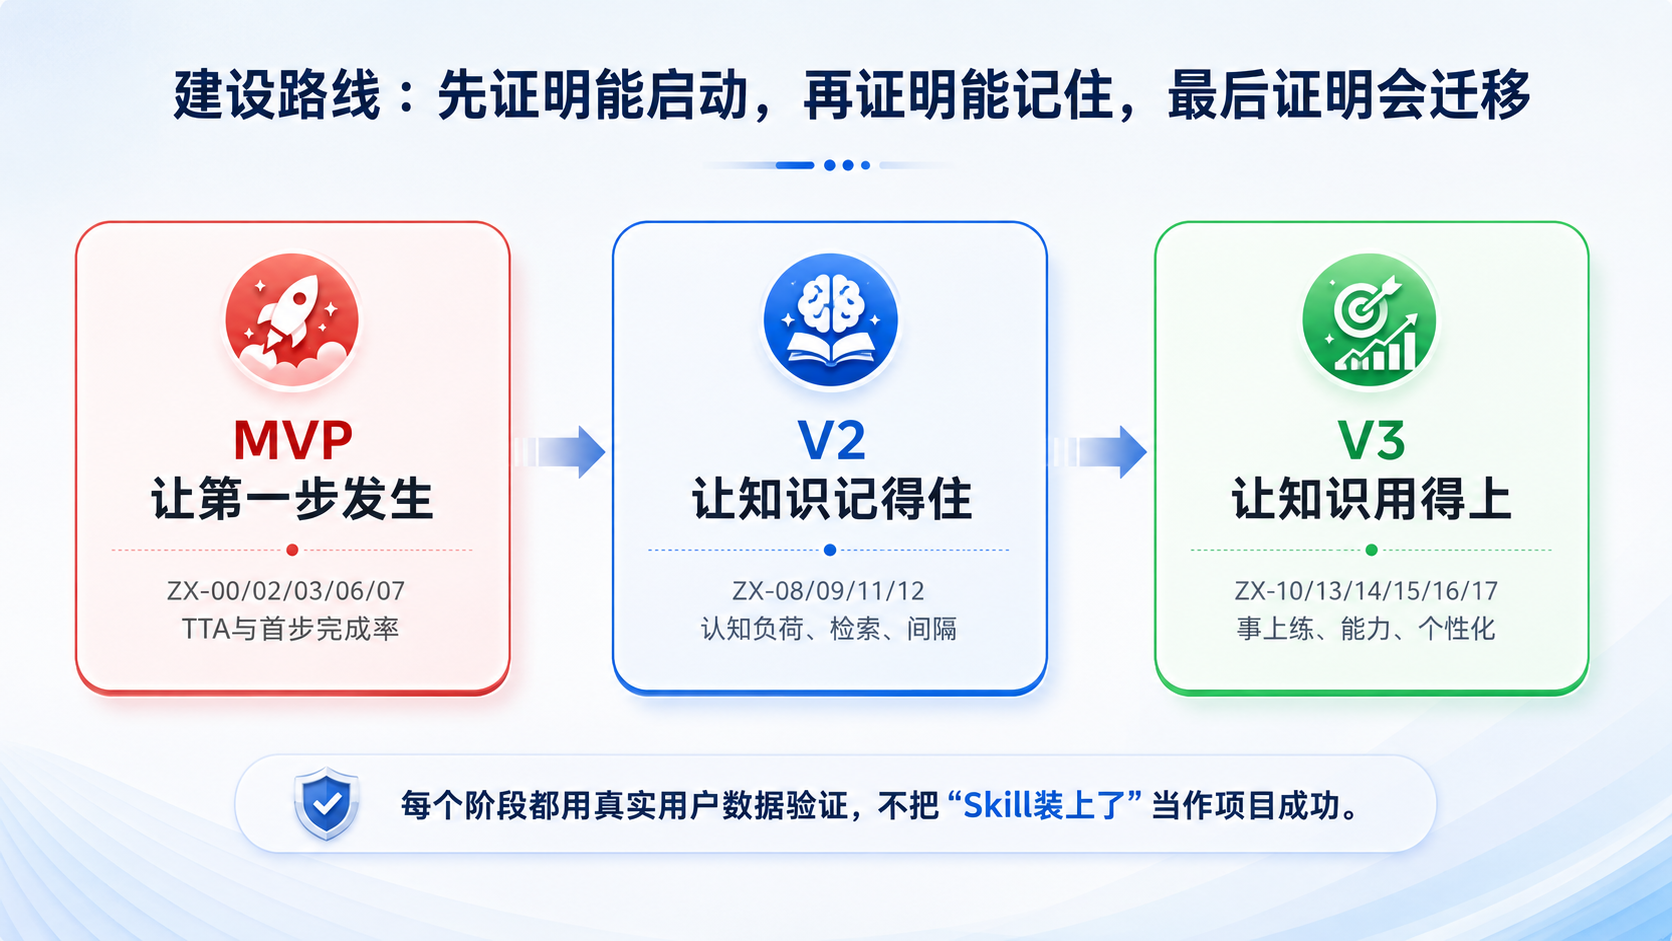
三阶段验证路线:先测试启动可行性,再测试长期保持,最后测试迁移
9.1 MVP 先验证可行性,不等于证明学习理论
第一阶段可以把“从表达学习意图到完成第一次学习行为的时间”作为一个工程指标,例如设定 Median TTA < 180 秒作为目标。但 180 秒不是科学阈值,只是原型团队需要预先定义的验收标准;更重要的是与对照方案相比是否真的缩短启动时间,以及这种缩短是否带来后续学习收益。
|
阶段
|
主要目标
|
重点能力
|
建议工程目标/研究终点
|
|
MVP
|
让第一步发生
|
目标蒸馏、阻力识别、最小行动、陪练
|
Median TTA < 180 秒(原型工程目标,非科学阈值);与对照比较首步完成率
|
|
V2
|
让知识记得住
|
主动检索、间隔巩固、证据记录
|
7/14/30 天保持;提示依赖下降
|
|
V3
|
让知识用得上
|
真实任务、学习行为模型、迁移验证
|
E3/E5 证据、真实迁移成功率
|
9.2 工程验收指标与研究指标要分开
|
维度
|
验收重点
|
建议观察指标(非行业基准)
|
|
启动
|
能否从意图进入第一次学习行动
|
Median TTA、首步完成率;阈值由项目预注册/验收约定
|
|
持续
|
第一步之后是否继续
|
第二步继续率、7 日学习链存活率
|
|
记忆
|
是否从眼熟变成可提取
|
主动检索成功率、7/14/30 天保持
|
|
应用
|
是否进入真实场景
|
E3 真实任务证据占比
|
|
迁移
|
能否在陌生场景使用
|
E5 迁移成功率
|
|
个性化
|
系统是否越来越适合用户
|
同等时长任务的完成率提升、提示依赖下降
|
9.3 主要风险与控制
|
风险
|
表现
|
应对
|
|
AI 替用户学
|
答案都由 AI 做,用户没有能力增长
|
设置 Human Judgment Gate;关键判断先让用户做
|
|
任务拆得过碎
|
一直停留在简单动作
|
ZX-16 逐步加难,最终必须走到独立和迁移
|
|
行为画像误判
|
一次行为就贴标签
|
只保存可观察任务行为;形成暂时倾向,并允许新证据推翻
|
|
过度依赖 MOSS 数据
|
把未授权能力写进方案
|
所有数据能力以实际授权与可接入范围为准
|
|
干预变成心理诊断
|
把拖延解释成个体缺陷
|
只描述任务行为与上下文,不做医学、心理或人格推断
|
|
隐私风险
|
长期学习轨迹包含个人数据
|
最小必要记录、用户可查可删、敏感信息不主动推断
|
9.4 工程交付物
ZhiXing 主 Agent 与 System Prompt(可运行于具备 Agent/Tool 能力的适当环境);
ZX-00~ZX-17 共 18 个标准 Skill;
Skill 输入输出、路由规则与测试用例;
可运行学习场景;
知行学习驾驶舱前端原型;
E0-E5 能力证据与能力图谱模型;
TTA、首步完成率、提取、保持、迁移的评估报告;
真实材料与工具接入说明;其中单列 MOSS 适用场景、授权范围与接口边界;
项目说明、用户使用说明与运维文档。
附录 A 科学依据、证据强度与边界
A.1 本文怎样使用研究证据
|
机制/设计
|
证据状态
|
本文如何使用与边界
|
|
努力成本与处理流畅性
|
有直接实验研究
|
用于解释任务“看起来费劲”如何影响选择/努力预测;不能解释所有拖延。
|
|
注意漂移与插入测试
|
有特定情境实验支持
|
在线讲授中插入测试可减少走神;具体频率与其他场景需再验证。
|
|
主动检索
|
有较强实验支持
|
用于长期保持与独立提取;不等于对所有理解/迁移任务都最优。
|
|
间隔学习
|
有较强实验支持
|
用于跨时间保持;最佳间隔随目标保持时间、材料和学习者变化。
|
|
元认知错觉
|
有实验支持
|
提醒“熟悉”不能替代无提示提取;不把一次错误解释为稳定个体特征。
|
|
迁移
|
有部分实验支持且高度依赖任务
|
用新问题和真实任务验证;不因同类题正确就声称形成通用能力。
|
|
未来自我/远期结果具体化
|
有跨期决策研究启发
|
研究主要来自储蓄等情境;用于学习属于跨领域假设。
|
|
最小行动、18 Skill、E0-E5、KAG、学习行为模型
|
项目工程假设
|
必须通过真实用户、对照、延迟测量验证;不能作为“科学已证明”的卖点。
|
|
MOSS(本文)
|
在企业/商业学习场景中可选的真实材料与分析环境之一;不承担学习机制解释,也不是知行成立的必要条件
|
|
A.2 关键边界
“大脑骗你”是科普表达,不是本文采用的神经科学结论。王煜全的内容用于提出问题和提供设计启发,具体机制仍以可查证的学习与行为研究为依据。
“知行合一”提供哲学问题框架;“学习状态机”“外部学习支架”“学习行为模型”是项目工程模型;三者都不应被写成对大脑工作方式的直接描述。
MOSS 仅属于可选工程环境/材料来源之一;18 个 Skill、E0-E5、KAG、Human Judgment Gate、未来情景推演等属于工程实现或待验证假设。任何效果结论都应来自真实实验,而不是来自平台接入或架构设计本身。
A.3 主要参考资料
[1] 王煜全:《如果大脑骗了你,让 AI 还你真相》相关科普内容,2026。本文仅作为问题提出与产品启发,不作为科学证据来源。
[2] Johnson, S. T., & Most, S. B. (2023). Taking the path of least resistance now, but not later: Pushing cognitive effort into the future reduces effort discounting. Psychonomic Bulletin & Review, 30, 1115-1124. https://doi.org/10.3758/s13423-022-02198-7
[3] Song, H., & Schwarz, N. (2008). If it's hard to read, it's hard to do: Processing fluency affects effort prediction and motivation. Psychological Science, 19(10), 986-988. https://doi.org/10.1111/j.1467-9280.2008.02189.x
[4] Szpunar, K. K., Khan, N. Y., & Schacter, D. L. (2013). Interpolated memory tests reduce mind wandering and improve learning of online lectures. Proceedings of the National Academy of Sciences, 110(16), 6313-6317. https://doi.org/10.1073/pnas.1221764110
[5] Roediger, H. L., & Karpicke, J. D. (2006). Test-enhanced learning: Taking memory tests improves long-term retention. Psychological Science, 17(3), 249-255. https://doi.org/10.1111/j.1467-9280.2006.01693.x
[6] Cepeda, N. J., Vul, E., Rohrer, D., Wixted, J. T., & Pashler, H. (2008). Spacing effects in learning: A temporal ridgeline of optimal retention. Psychological Science, 19(11), 1095-1102. https://doi.org/10.1111/j.1467-9280.2008.02209.x
[7] Koriat, A., & Bjork, R. A. (2006). Mending metacognitive illusions: A comparison of mnemonic-based and theory-based procedures. Journal of Experimental Psychology: Learning, Memory, and Cognition, 32(5), 1133-1145.
[8] Butler, A. C. (2010). Repeated testing produces superior transfer of learning relative to repeated studying. Journal of Experimental Psychology: Learning, Memory, and Cognition, 36(5), 1118-1133. https://doi.org/10.1037/a0019902
[9] Hershfield, H. E., Goldstein, D. G., Sharpe, W. F., Fox, J., Yeykelis, L., Carstensen, L. L., & Bailenson, J. N. (2011). Increasing saving behavior through age-progressed renderings of the future self. Journal of Marketing Research, 48(SPL), S23-S37. 本文只把它作为“未来结果具体化”的跨领域启发,不直接推断其学习效果。
[10] 帆软“认识帆软”:2026 年以 Moss、Dora 等产品将自然语言交互、智能问答和自动洞察引入数据分析场景。访问:2026 年 8 月。https://join.fanruan.com/explore-fr
[11] 帆软官网:AI 应用中心公开展示“Moss商业洞察”,并列出 AI Agent 引擎、AI+数据分析、AI+企业洞察等方向。访问:2026 年 8 月。https://www.fanruan.com/
附录 B 关键术语
|
术语
|
本文含义
|
|
Next Learning Action
|
当前学习者在此刻最值得完成的一步学习行动
|
|
TTA
|
Time To Action,从表达学习意图到完成第一次真实学习行动的时间
|
|
Human Judgment Gate
|
项目内部工程规则:在需要形成能力证据的节点,先让用户判断或产出,再显示 AI 反馈
|
|
E0-E5
|
项目内部证据等级;用于组织观察,不是标准心理量表
|
|
KAG
|
项目内部路由指标,用来描述知识表现与行动证据的差异;权重和效度待验证
|
|
学习行为模型
|
对历史任务行为的统计记录,用于调整任务形式;不等于人格或认知诊断
|
|
事上练
|
把真实项目、文件、案例和业务数据直接变成学习任务
|


