转化率相差17倍的流量黑洞与潜力品类
1 团队介绍
本作品由个人独立完成。作者为数据分析爱好者,具备 Python 数据处理和 BI 可视化工具的应用能力。参赛动机源于对电商用户行为分析的兴趣——希望通过真实数据理解用户决策路径、发现品类运营的优化空间。从数据获取、预处理、分析建模到可视化呈现,全流程独立完成。在品类分组和异常检测等关键环节,通过与 AI 辅助工具的多轮交互完成了方案迭代。
2 作品背景
电商平台的品类运营长期面临一个"流量分配悖论":一方面,拥有海量浏览量的品类(如服饰、日用百货)占据了绝大多数的曝光资源——数据显示,"高流量低转化"品类组中 1,581 个品类的日均浏览量高达 5.2 万次,但最终转化率仅 2.80%,大量流量并未转化为实际成交。这些流量黑洞持续吸走平台的曝光资源,形成"强者恒强"的马太效应。另一方面,还有 952 个"高潜力品类"——它们的浏览→购买转化率高达 38.72%,是平台均值的 17 倍,但日均浏览量不足 100 次。这些品类"酒香巷子深",被淹没在海量商品中无人问津。问题本质在于:所有品类共用同一套运营策略,流量分配以浏览量而非转化效率为导向。这造成了"该曝光的没曝光、不该曝光的占着资源"的双重浪费。
本作品致力于改善电商平台的品类精细化运营能力。当前运营模式存在三个核心局限:
局限一:转化漏斗存在盲区。 大多数运营指标仅关注浏览量和最终成交额(GMV),忽略了收藏、加购等中间环节。一个品类究竟是"没人看"、"看了不感兴趣"还是"感兴趣但没下单"?没有数据支撑,改进方向无从谈起。
局限二:品类策略一刀切。 所有品类共用同一套促销节奏、页面布局和推广方式。但不同品类的用户决策路径完全不同——快消品可能冲动消费,耐用品需要反复比价,"一键复制"的策略必然无法适配所有品类。
局限三:异常发现滞后。 品类转化率出现异常下降时,往往要等到月底看报表才能发现,错失了实时干预的最佳窗口。
本作品借鉴了电商漏斗模型(浏览→收藏→加购→购买全链路追踪)、RFM 模型的逆向应用(以流量规模和转化效率构建品类画像矩阵)、以及帕累托法则(识别关键的 20% 品类)的思路,将 9,439 个商品品类聚类为 8 个行为分组,为每个分组制定差异化的运营策略。
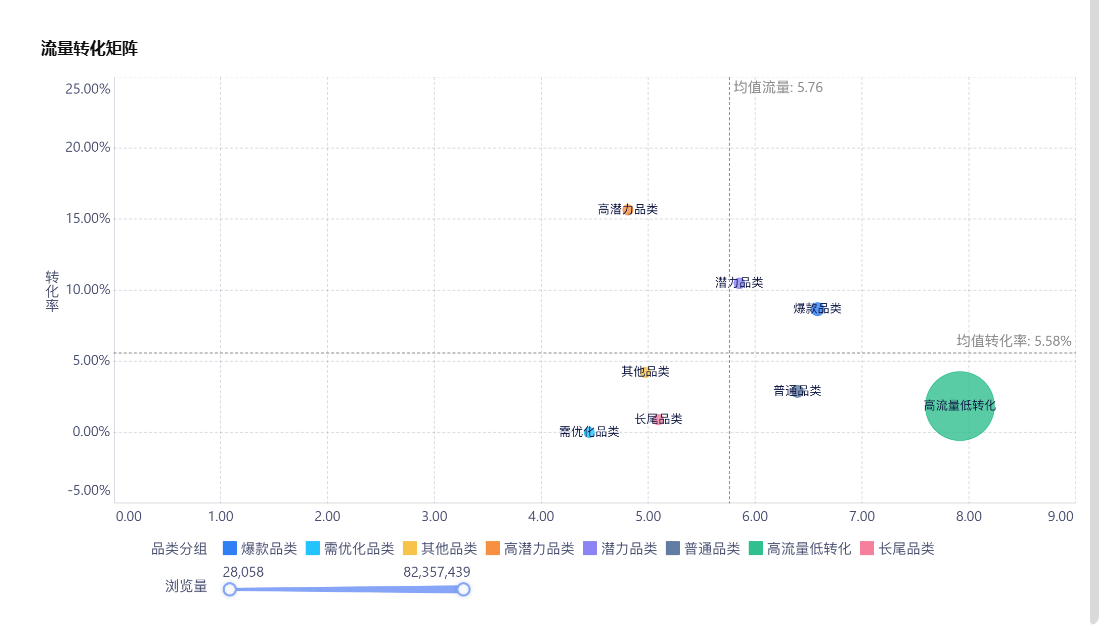
当我们将 9,439 个品类投射到"流量规模 × 转化效率"的二维矩阵中时,一个清晰的规律浮出水面:流量和转化之间并不存在天然的正相关——恰恰相反,二者之间存在明显的负相关趋势。爆款品类(307 个)占据金字塔尖:流量高、转化也高,是平台的核心利润区。高流量低转化品类(1,581 个)是最大的流量黑洞:大而不精,需要产品体验优化而非继续堆流量。高潜力品类(952 个)是最值得被"看见"的品类:转化率惊人但几乎零曝光,只需适度增加流量倾斜即可释放增长。这组数据揭示了一个反直觉的真相:电商平台的增长瓶颈往往不在"获取更多流量",而在于"把既有的流量重新分配到更高效的地方"。 与其不断通过投放、促销争夺增量流量,不如先做好存量流量的效率优化——将流量从低效品类向高效品类转移。这套"先内涵、后外延"的增长思路,是本作品的核心发现。
3 制作流程(背景驱动下,作品的数据来源、设计思路、逻辑、框架和实现方式等)
(1)、数据来源
本作品所使用的数据来源于阿里天池平台公开的淘宝用户行为数据集(UserBehavior Dataset),该数据集由阿里巴巴集团提供,记录了 2017 年 11 月 24 日至 2017 年 12 月 3 日期间淘宝平台约 100 万用户的真实行为日志。原始数据包含约 1 亿条行为记录,单条数据由用户 ID、商品 ID、品类 ID、行为类型(浏览/收藏/加购/购买)和时间戳五个字段构成。值得注意的是,11 月 24 日为数据采集起始日,当天仅收录了约 2-3 小时的用户行为,分析时予以标注排除,最终有效分析窗口为 2017 年 11 月 25 日至 12 月 3 日,共 9 日近 9,000 万条有效数据。
(2)、设计思路
本作品的设计围绕"品类画像"这一核心概念展开。电商平台拥有成千上万的商品品类,传统的运营方式往往对所有品类一视同仁,导致资源错配。本作品通过对用户行为从浏览到购买的全链路追踪,从"流量规模"和"转化效率"两个维度构建品类画像矩阵,将 9,439 个品类聚类为 8 个行为特征分组。每个分组对应不同的用户心智阶段和运营策略,从而为精细化的品类运营提供数据支撑。
(3)、分析逻辑
分析逻辑遵循"漏斗拆解→维度下钻→洞察输出"的三层递进结构:
第一层为行为漏斗分析,将用户决策路径拆解为"浏览→收藏→加购→购买"四个阶段,计算各阶段间的转化率,定位整体转化瓶颈。
第二层为维度下钻分析,从时间维度(日趋势、小时分布)和品类维度(行为分组、品类排行)两个方向展开,识别不同分组在不同时间段的行为差异。
第三层为策略输出,基于前两层发现,针对每个品类分组提炼差异化的运营策略,形成可落地的业务建议。
(4)、分析框架
整个分析报告分为五个模块:
模块一:数据概览与预处理
├── 数据来源与字段说明
├── 数据清洗(无效时间戳过滤)
├── 数据聚合(小时级/天级/品类级汇总)
└── 数据质量说明
模块二:整体趋势分析
├── 日趋势:9 天浏览量、收藏量、加购量、购买量走势
├── 小时分布:全天 24 小时用户活跃度规律
└── 转化漏斗:浏览→收藏→加购→购买各阶段转化率
模块三:品类画像与分组分析
├── 品类特征矩阵:流量规模 × 转化效率二维分类
├── 八大品类分组的行为特征解读
├── 各分组的转化漏斗对比
└── 分组间流量与成交贡献的帕累托分析
模块四:异常发现
├── 11 月 24 日数据采集不全的识别与处理
├── 12 月 2 日峰值分析(周末 + 月初效应叠加)
└── 需优化品类(零转化问题)的根因定位
模块五:运营建议
├── 各品类分组的差异化策略
├── 推广投放的最佳时段建议
└── 数据驱动的品类运营闭环
(5)、实现方式
技术实现分为数据处理和可视化两个阶段:
数据处理阶段使用 Python 3.12 + Pandas 2.2 完成,采用分块读取策略(每块 50 万行)处理 1 亿行原始数据,规避内存瓶颈。处理流程包括:时间戳解析与无效数据过滤→按小时/天/品类多维度聚合→品类特征提取与行为分组聚类。
可视化阶段使用 FineBI Next,导入预处理后的聚合数据,通过拖拽式操作构建交互式看板。核心图表类型包括:折线图(时间趋势)、漏斗图(转化链路)、柱状图(品类排行)、散点图(流量-转化矩阵),每个看板均支持按日期和品类分组筛选,便于多角度探索。
4成果展示
本作品基于淘宝 2017 年 11 月 25 日至 12 月 3 日共 9 天的用户行为真实数据(累计约 8,970 万次浏览、200 万次购买),围绕"品类画像"这一核心概念展开多维度分析。从整体趋势到时段规律,从转化漏斗到品类分层,层层下钻,最终输出一套数据驱动的差异化品类运营策略。
作品链接:
https://next.finebi.com/decision/home/application/407e4222bcfd4d7fb5f28c93a17856/fvs/3d732edba1e9433ea48cbb7a74d1e2
(1)模块一:整体流量趋势
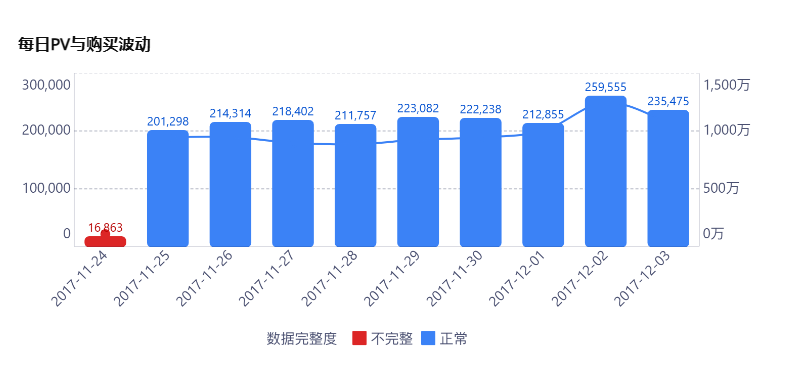
浏览量是用户活跃度的最直观指标。9 天有效数据中,日均浏览量约 984 万次,日均购买量约 22.2 万笔,整体浏览→购买转化率为 2.26%。
从日趋势来看,流量呈现出明显的"周末效应"和"月初效应"双重特征。11 月 25-26 日(周六日)浏览量维持在 940 万以上,高于工作日的 880-920 万水平;进入 12 月后,流量进一步攀升——12 月 1 日(周五)突破 1,000 万,12 月 2 日(周六)达到峰值 1,247 万,成为 9 天中流量最高的一天。这一峰值是"月初发薪效应"与"周末空闲效应"叠加的结果:月底至月初用户资金充裕,周末有更多时间浏览,双重驱动下形成的自然流量高峰。
购买量的走势与浏览量基本同步,12 月 2 日同样达到峰值 259,555 笔。12 月 3 日(周日)虽有所回落,但仍维持在 1,070 万浏览、23.5 万购买的高位。
(2)模块二:用户活跃时段规律
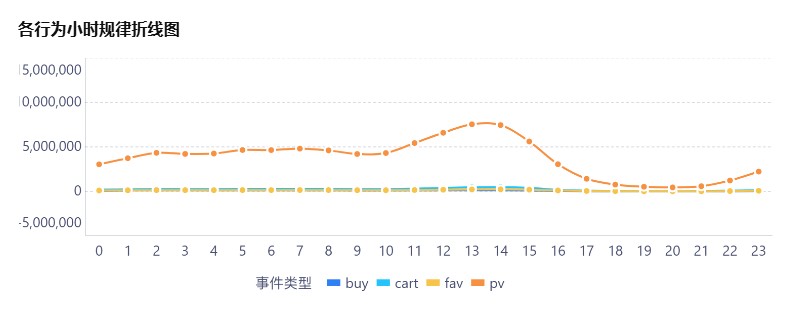
用户在全天的活跃度并非均匀分布,而是呈现出两个截然不同的阶段。午间 11 时至下午 15 时为全天浏览高峰,其中 13 时左右的浏览量达到峰值,贡献了全天约 23% 的流量。这一时段恰好对应上班族的午休时间,说明移动端碎片化浏览是流量主力。
值得注意的是,晚间 18 时至 22 时的浏览量反而处于全天的低谷,这与"晚上逛淘宝"的普遍认知有所不同。可能的原因是原始数据使用场景以 PC 端或特定用户群为主,也可能是下午时段集中了更多的商品上新和促销活动。
这一发现对运营投放有直接意义:推广资源应重点集中在午间 11 时至下午 15 时的高效时段,而非晚间。
(3)模块三:转化漏斗分析
将用户决策路径拆解为"浏览→收藏→加购→购买"四个阶段,各阶段的累计量级依次递减。9 天内累计浏览 8,860 万次、收藏约 286 万次、加购约 547 万次、购买约 200 万次。
各环节转化率如下:浏览→收藏转化率约 3.22%,浏览→加购转化率约 6.17%,浏览→购买转化率 2.26%。从加购到购买的转化率为 36.6%,即约每 3 个将商品加入购物车的用户中,就有 1 个最终完成购买。这一比例处于电商行业的正常区间,说明购物车到下单的通道基本畅通,但仍有优化空间。
(4) 模块四:品类分组对比
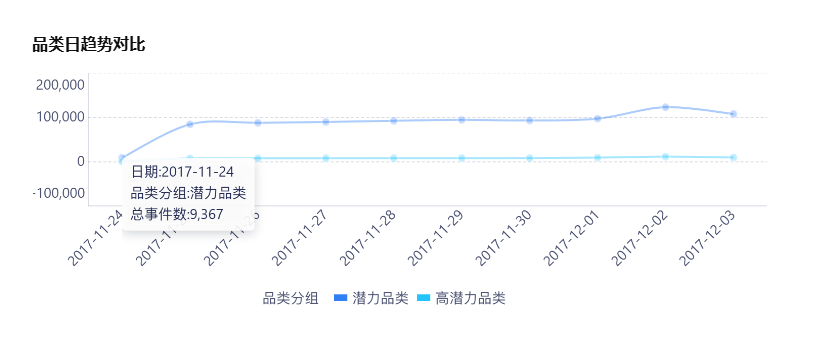
9,439 个商品品类并非铁板一块。通过"流量规模"和"转化效率"两个维度,本作品将全部品类聚类为 8 个行为分组,各分组的行为特征和运营价值截然不同。
"高流量低转化"组包含 1,581 个品类,平均浏览量高达 5.2 万次,但转化率仅 2.80%,低于整体平均。这类品类占据了大量曝光资源但未产出相应的销售转化,属于"流量黑洞",是优化商品页和定价策略的重点对象。
"爆款品类"组虽只有 307 个品类,但平均浏览量达 1.2 万次、转化率 9.00%,是平台最优质的盈利品类,应优先保障其曝光和用户体验。
"高潜力品类"组有 952 个品类,转化率高达 38.72%,但浏览量不足 100 次,属于典型的"酒香巷子深"品类。这类品类是平台增长的最大机会点——只需适度增加流量倾斜,即可释放可观的增长空间。
"长尾品类"组有 2,869 个品类,转化率仅 0.30%,属于维持性品类,无需投入过多运营资源。
(5) 模块五:流量-转化矩阵与运营策略
将每个品类按浏览量(对数)和转化率投射到二维矩阵散点图中,品牌分组的分布一目了然。
矩阵的左上象限属于"高潜力品类"(低流量、高转化),右下象限属于"高流量低转化"品类(高流量、低转化),右上象限属于"爆款品类"(双高)。一条清晰的"流量-转化负相关"趋势线贯穿其中——随着流量的增加,转化率呈下降趋势,这与电商领域的"流量稀释效应"相符:当品类获得大量曝光后,涌入的非精准流量拉低了整体转化率。
针对每个分组的定位,建议采取差异化的运营策略:爆款品类保持稳定运营、高流量低转化品类优化商品体验、高潜力品类加大推广曝光、长尾品类降低运营成本。通过将流量从低效品类向高效品类重新分配,在不增加总体投放预算的前提下,即可实现整体 GMV 的增长。
5 总结与分享
(1)数据获取:从"想做什么"到"能做什么"
项目启动时,最初的想法是获取品牌独立站的公开经营数据做分析,但在调研后发现:品牌独立站数据量普遍偏小(几十到几百个 SKU),不足以支撑有深度的趋势分析和预测建模。最终调整为使用阿里天池的淘宝用户行为数据集,虽然放弃了"品牌独立站"这个原始方向,但换来了 1 亿行 的真实用户行为记录——数据量足够大,分析维度足够丰富。这个取舍让我们认识到:数据分析的起点不是"想要什么数据",而是"有什么可用数据"。
(2)数据清洗:最简单的坑往往最隐蔽
预处理过程中遇到的一个典型教训是"1902 年日期"问题——原始数据中有少量行的时间戳值为 0 或负数,直接解析后变成了 1902 年。这个错误在预览时很容易被发现,但如果数据集很大(1 亿行),少量的脏数据会悄然混入汇总结果中。解决方案很简单——加一行年份过滤——但如果没有主动去验证数据质量,这个错误可能一路带进最终的可视化看板。事后看,在数据处理流程的每个关键节点设置验证环节(比如总量核对、日期范围检查),是值得养成的习惯。
(3)工具选择:用对工具比用"好"工具更重要
项目选择 FineBI Next 作为可视化工具。一开始也有过"是不是应该用 Python 做更炫酷的可视化"的纠结,但实际做下来发现,FineBI 的拖拽式操作在高频迭代看板时效率极高——改一个维度、换一种图表类型都是秒级操作。这让我们体会到:工具的价值不在于功能多强大,而在于能不能让分析思路快速落地。
(4)品类分组:第一次跑出来的结果完全不能用
品类聚类是项目中最曲折的一环。第一次尝试直接用 KMeans 对 9,439 个品类的特征做聚类,结果跑出来 5 个簇几乎完全重叠——因为数据分布极度偏斜(少数品类占了绝大部分流量),欧氏距离在这种场景下完全失效。后来改为基于分位数的规则分类,按"流量规模"和"转化效率"两个维度分档组合,才得到有业务意义的 8 个品类分组。这个经历说明:面对非正态分布的真实业务数据时,基于业务理解的规则分类往往比纯数学的聚类算法更可靠。
(5)数据量焦虑:1680 行真的够吗?
当看到 hourly_stats 只有 1680 行时,第一反应是"数据是不是丢了"。后来才搞清楚这是稀疏存储格式——只有发生了行为的小时才有记录,而不是每小时填 0。验证方法也很简单:用两个不同粒度的表(小时级和天级)交叉核对总量,数值完全一致,这才放心。这个"虚惊一场"让我们学到了:理解数据的存储格式和分析需要的数据粒度同样重要。
(6)整体感受
从数据获取、清洗、分析到可视化落地,整个流程走下来最大的收获不是某个具体的分析结论,而是建立了一套数据工作的基本流程:先验证数据质量、再理解数据分布、然后选择合适的分析方法、最后用可视化呈现洞察。这套流程比任何单一的工具技能都更有长期价值。


