|
近日,智数大会 2026「AI Ready·数据集成治理专场」举行。帆软软件有限公司数据中心负责人李昌鑫,围绕《让数据质量治理真正闭环:问题发现、定位与持续改善的帆软实践》展开分享。
扫码或点击图片查看直播回放
李昌鑫带来的是帆软面向自己的一次「内部答卷」:把数据当成流水线上的产品,用质量卡口决定它能否出厂。
为什么做了数仓,
还要做质量治理
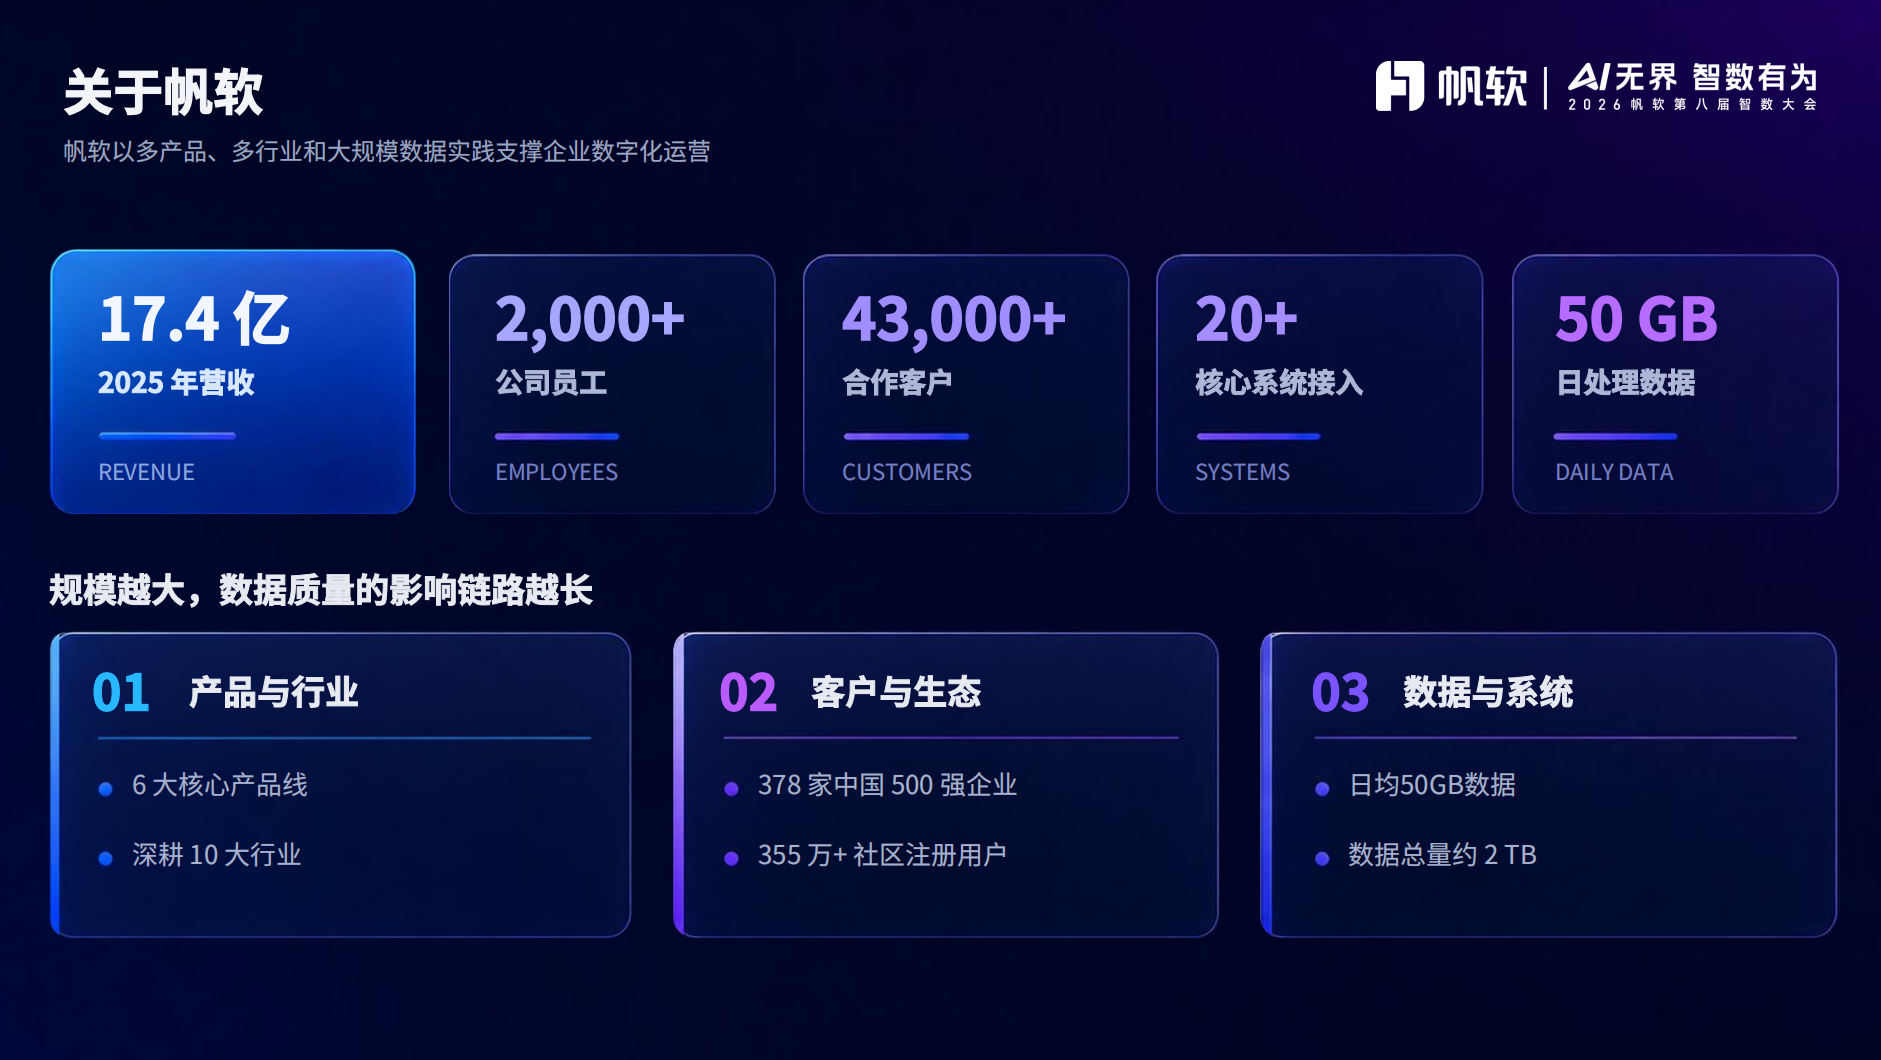
李昌鑫首先介绍了帆软自身的体量:2025 年公司营收 17.4 亿元,员工 2000 余人,合作客户 43000 多家,接入 20 多个核心系统,日均处理数据接近 50GB,数据总量约 2TB。规模越大,数据质量的影响链路就越长。
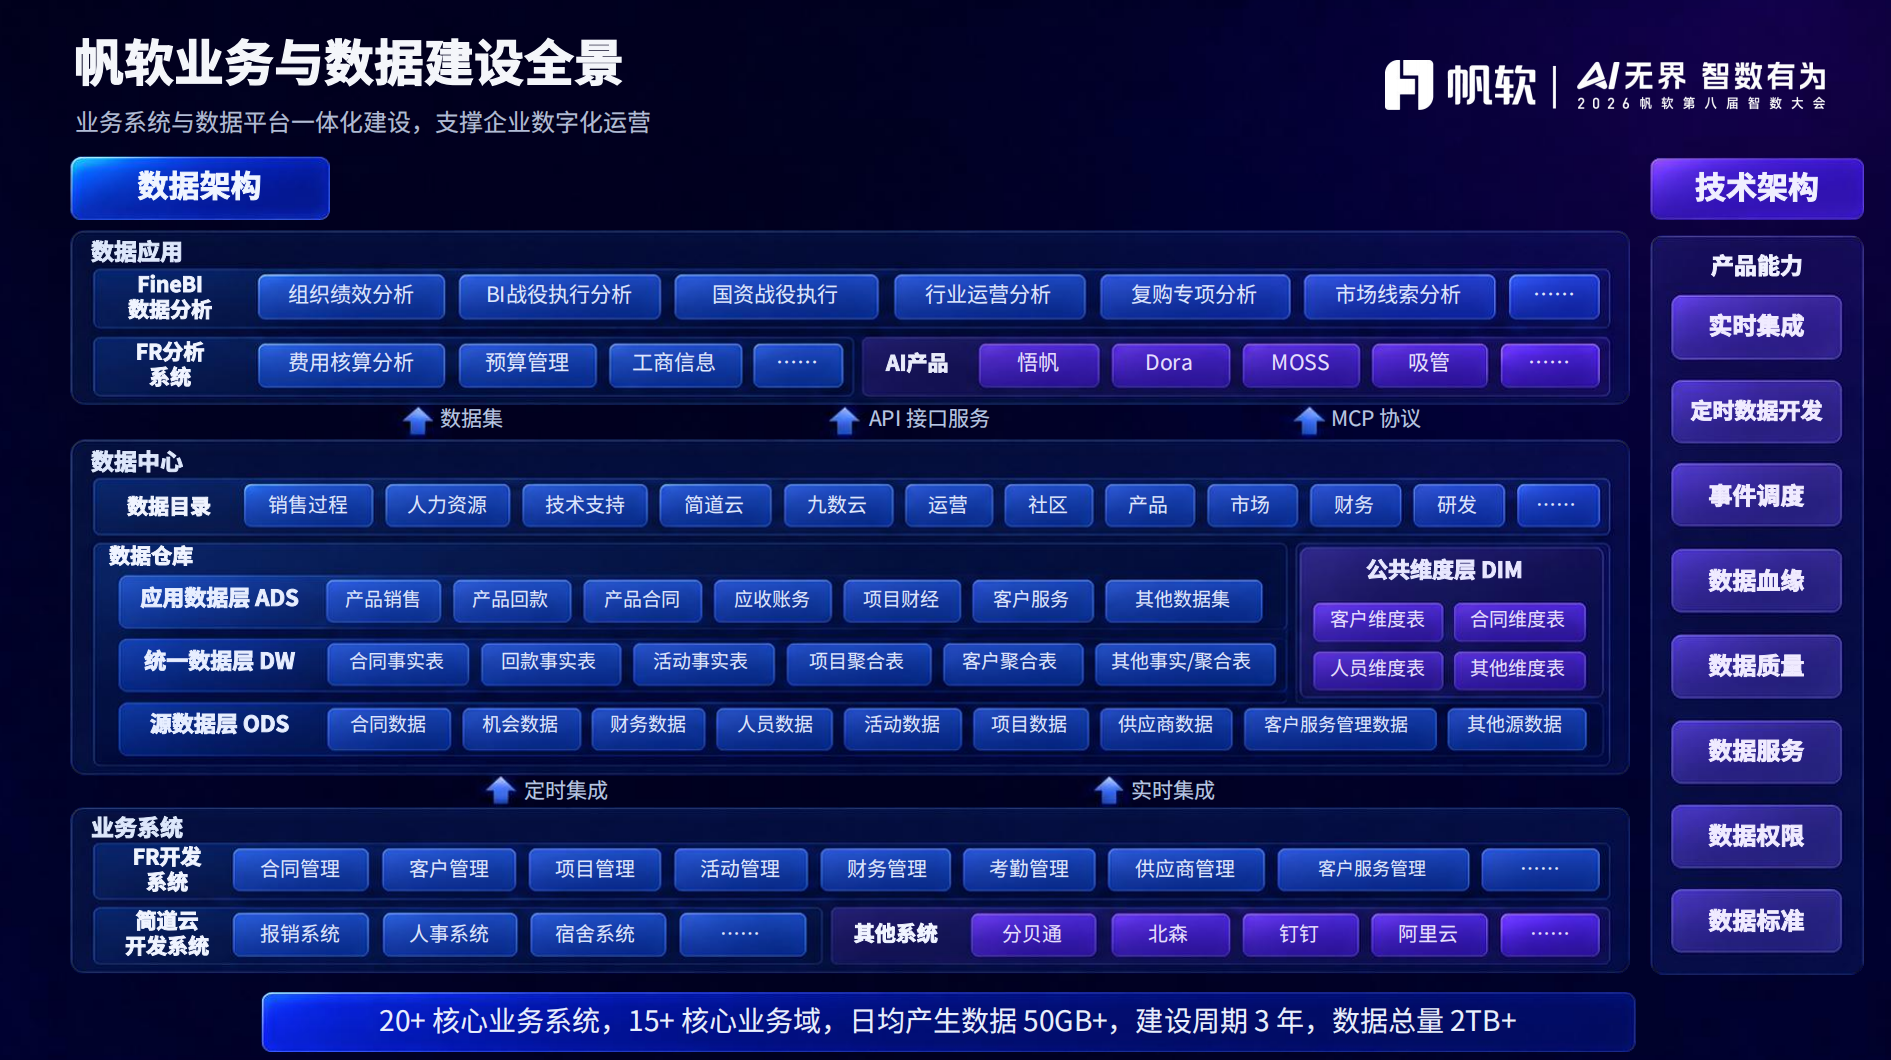
为承接这些数据,帆软数据中心参照主流数仓架构,用 FineDataLink 把 20 多个核心系统的数据统一集成进数据仓库,再经 ODS 源数据层、DIM 公共维度层、DW 统一数据层与 ADS 应用数据层逐层清洗转换,最终把 ADS 层数据开放给 BI 与 AI 系统,支撑经营决策。20 多个核心业务系统、15 个以上核心业务域、3 年建设周期,构成了这套数据底座的全部重量。
这套架构运转良好,但李昌鑫抛出了一个更关键的问题:既然已经建了数仓,为什么还要做数据质量治理?原因在于链路是串行的——任何一个环节的数据出问题,都会逐层向下传导,最终影响到业务端 BI 与 AI 的使用。
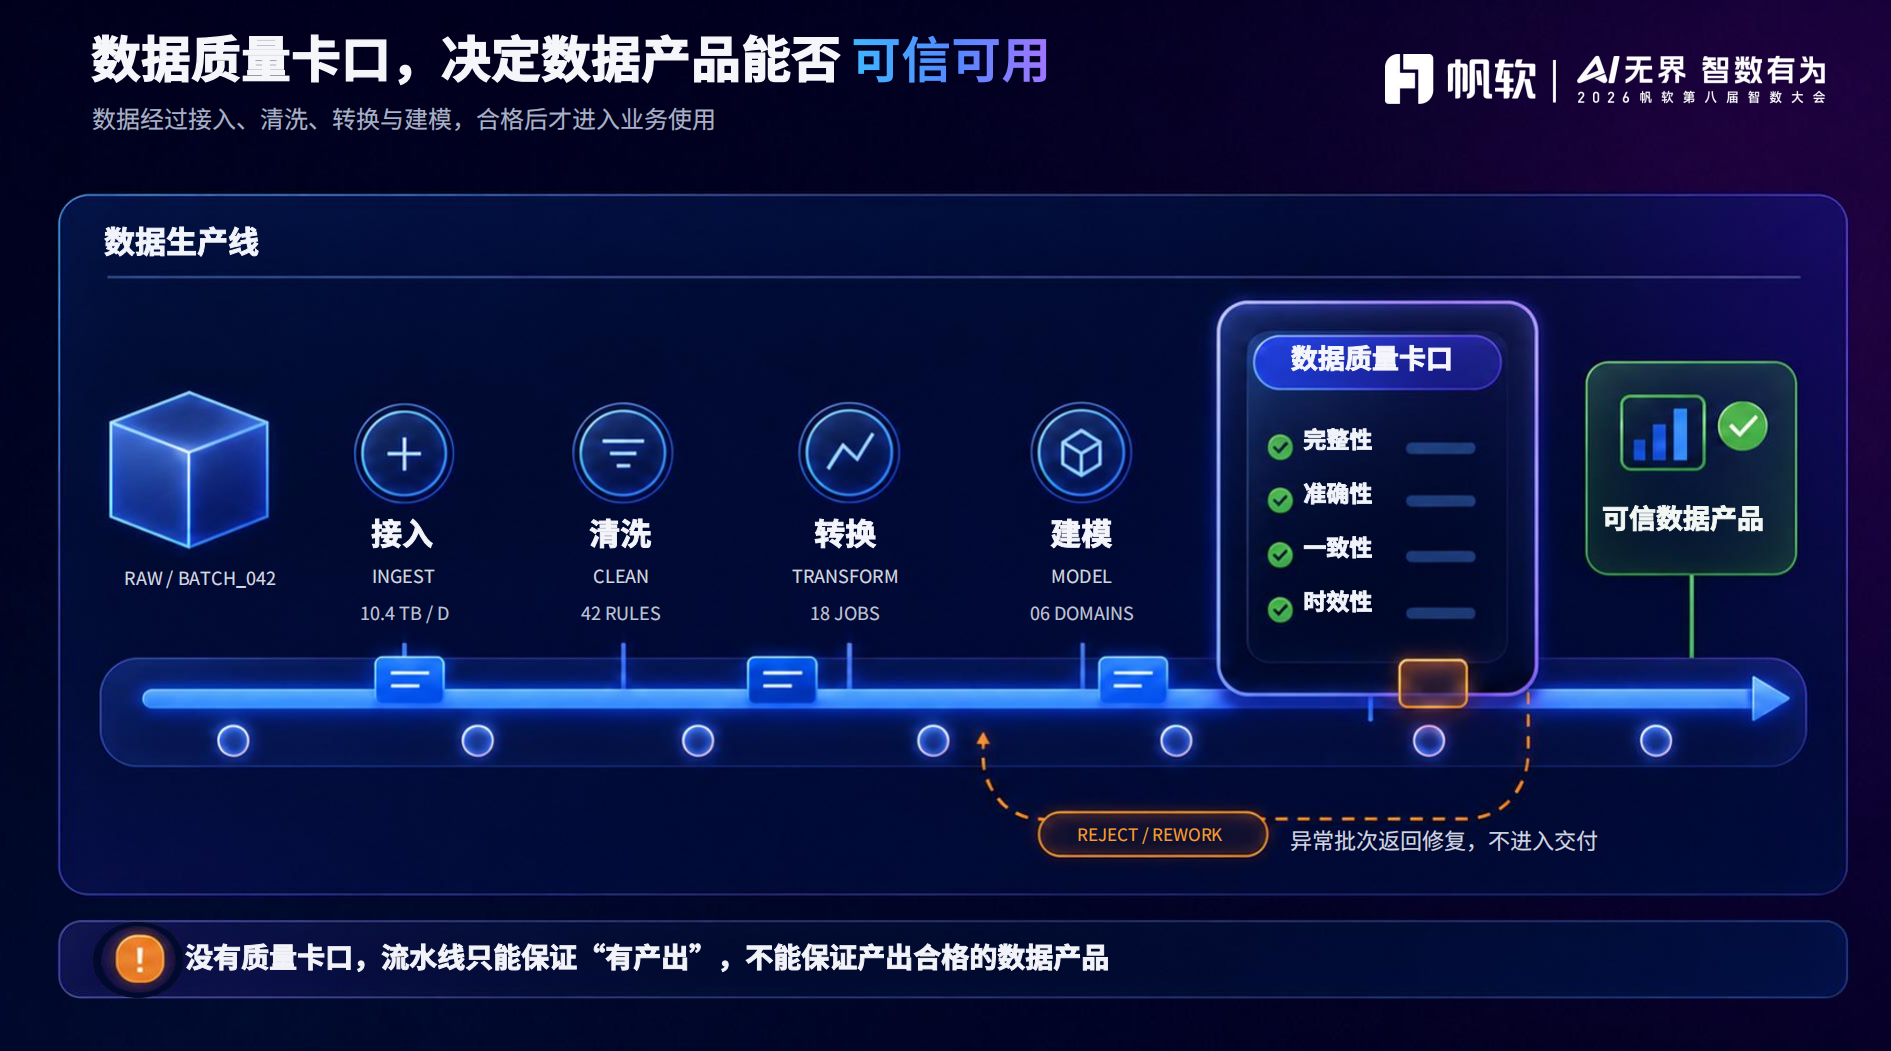
对此,帆软把数据生产比作一条流水线。原始数据在业务系统产生后接入数仓,经接入、清洗、转换、建模四道工序,最终交付为可用的数据产品。如果流水线上没有质量卡口,它只能保证「有产出」,却无法保证产出合格。于是帆软把卡口嵌进流水线,对每个数据产品实时检测完整性、准确性、一致性与有效性等;一旦发现异常,立即打回数据中心处理,不进入交付环节。
三流出问题,数仓来背锅
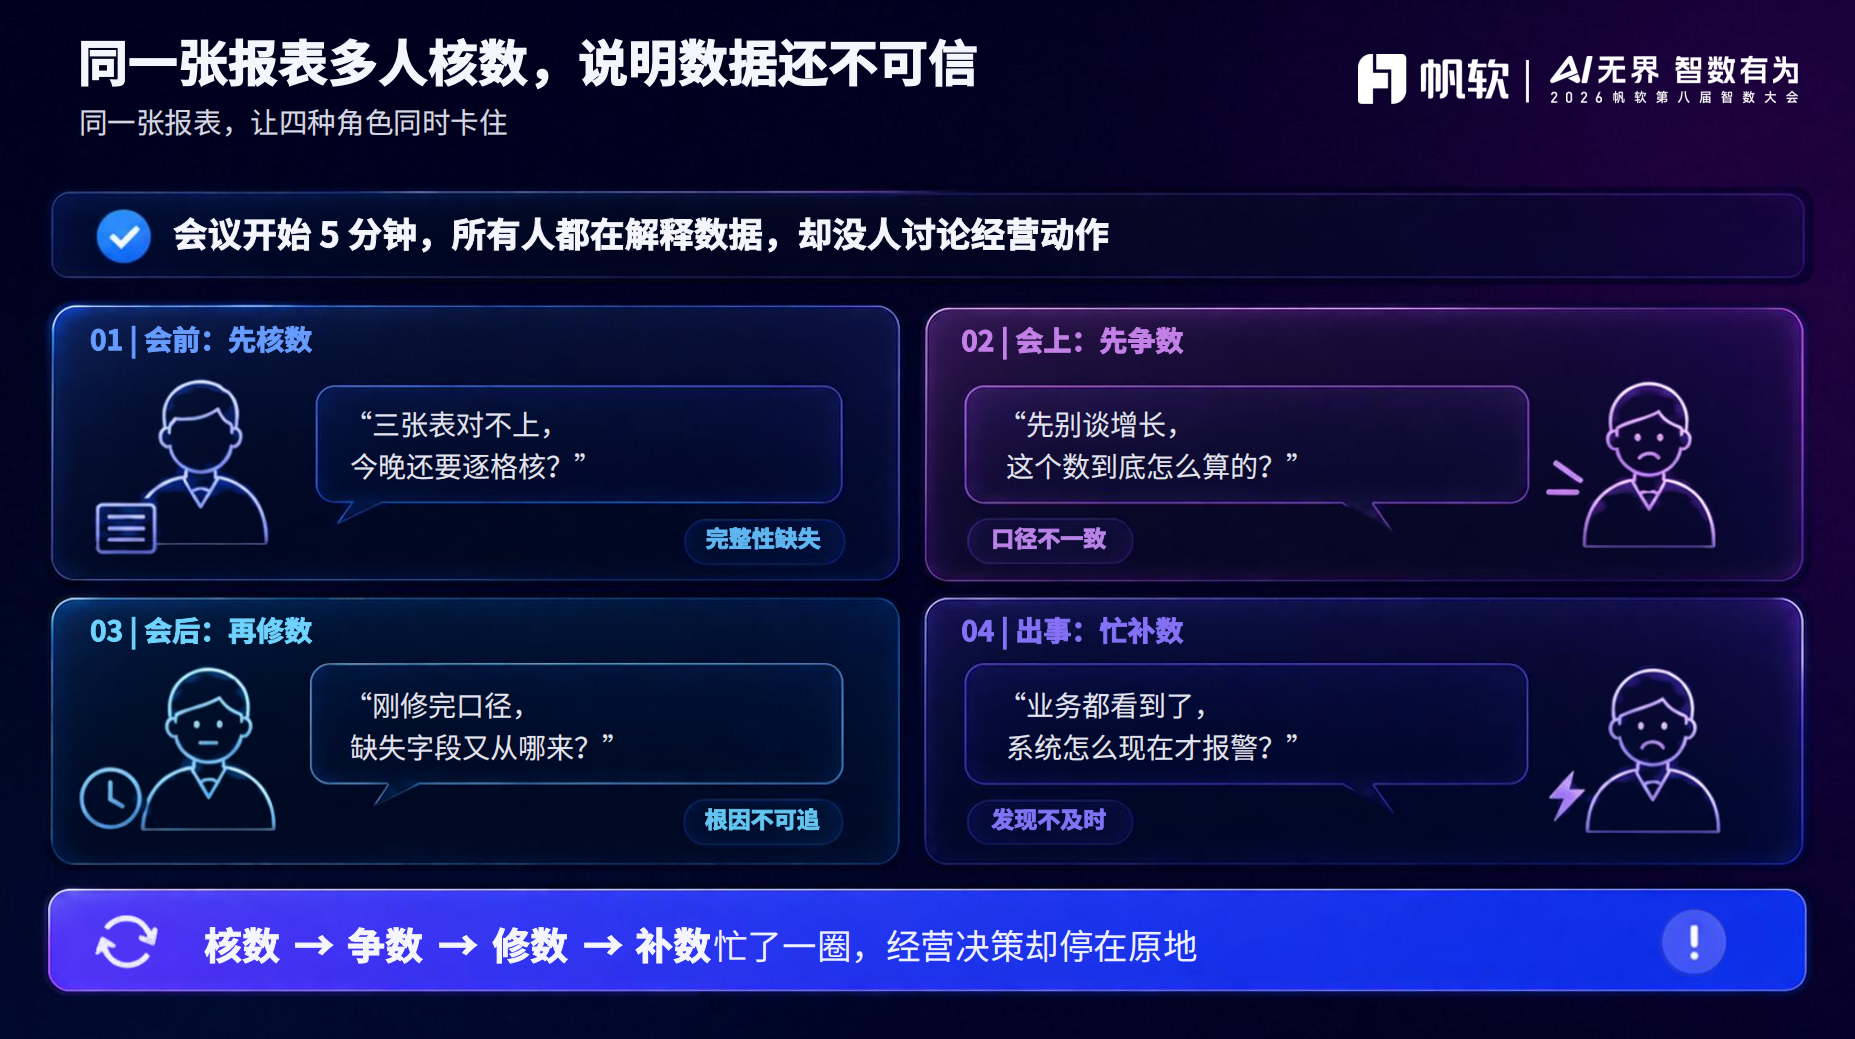
缺少这道卡口时,经营分析会就成了数据的「审讯现场」:会前先核数,三张表对不上还要逐格核对;会上先争数,增长还没谈,先争论这个数到底怎么算;会后继续修数,口径刚改完新的缺失字段又冒出来;一旦出事还得连夜补数。核数、争数、修数、补数忙了一圈,经营决策却停在原地。
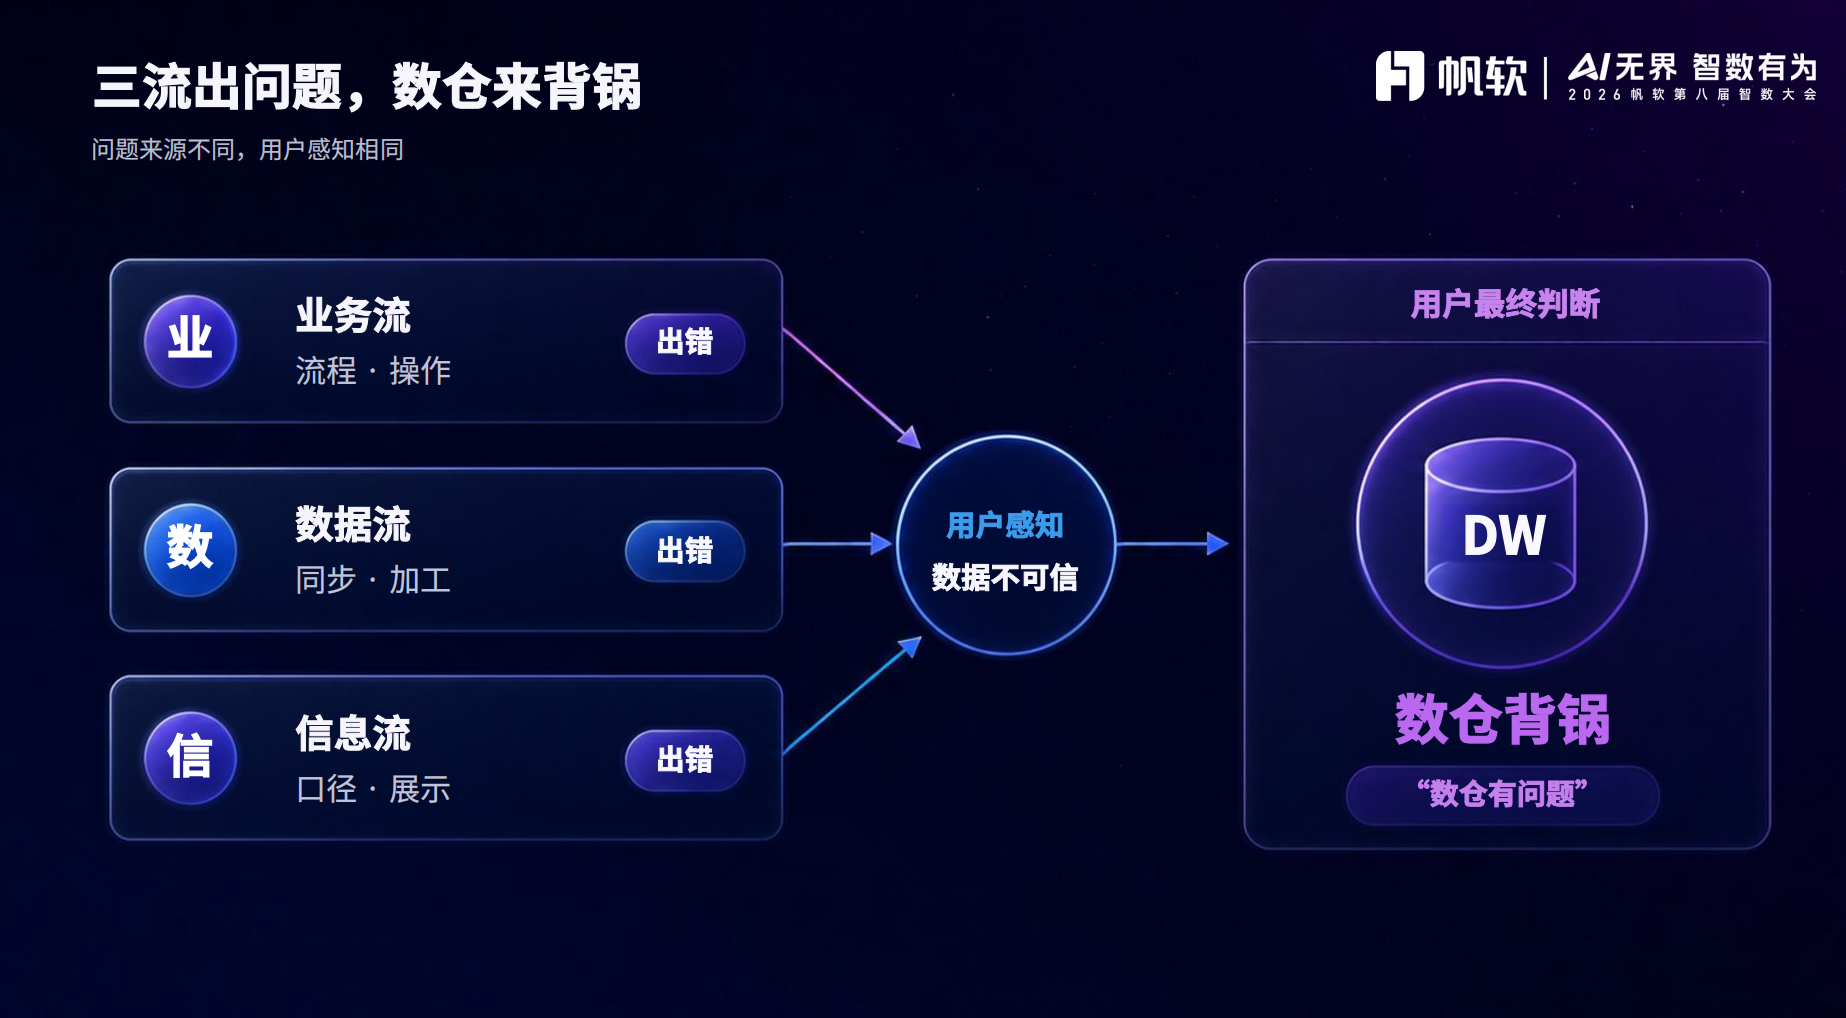
更进一步,李昌鑫指出数据问题并不都出在数仓。它可能来自业务流(流程与操作出错),可能来自数据流(同步与加工出错),也可能来自信息流(口径与展示出错)。问题来源各异,用户的感知却高度一致——数据不可信,数仓背锅。这对数据中心而言,是很难接受的结果。
一条闭环:
发现、定位、解决、持续监控
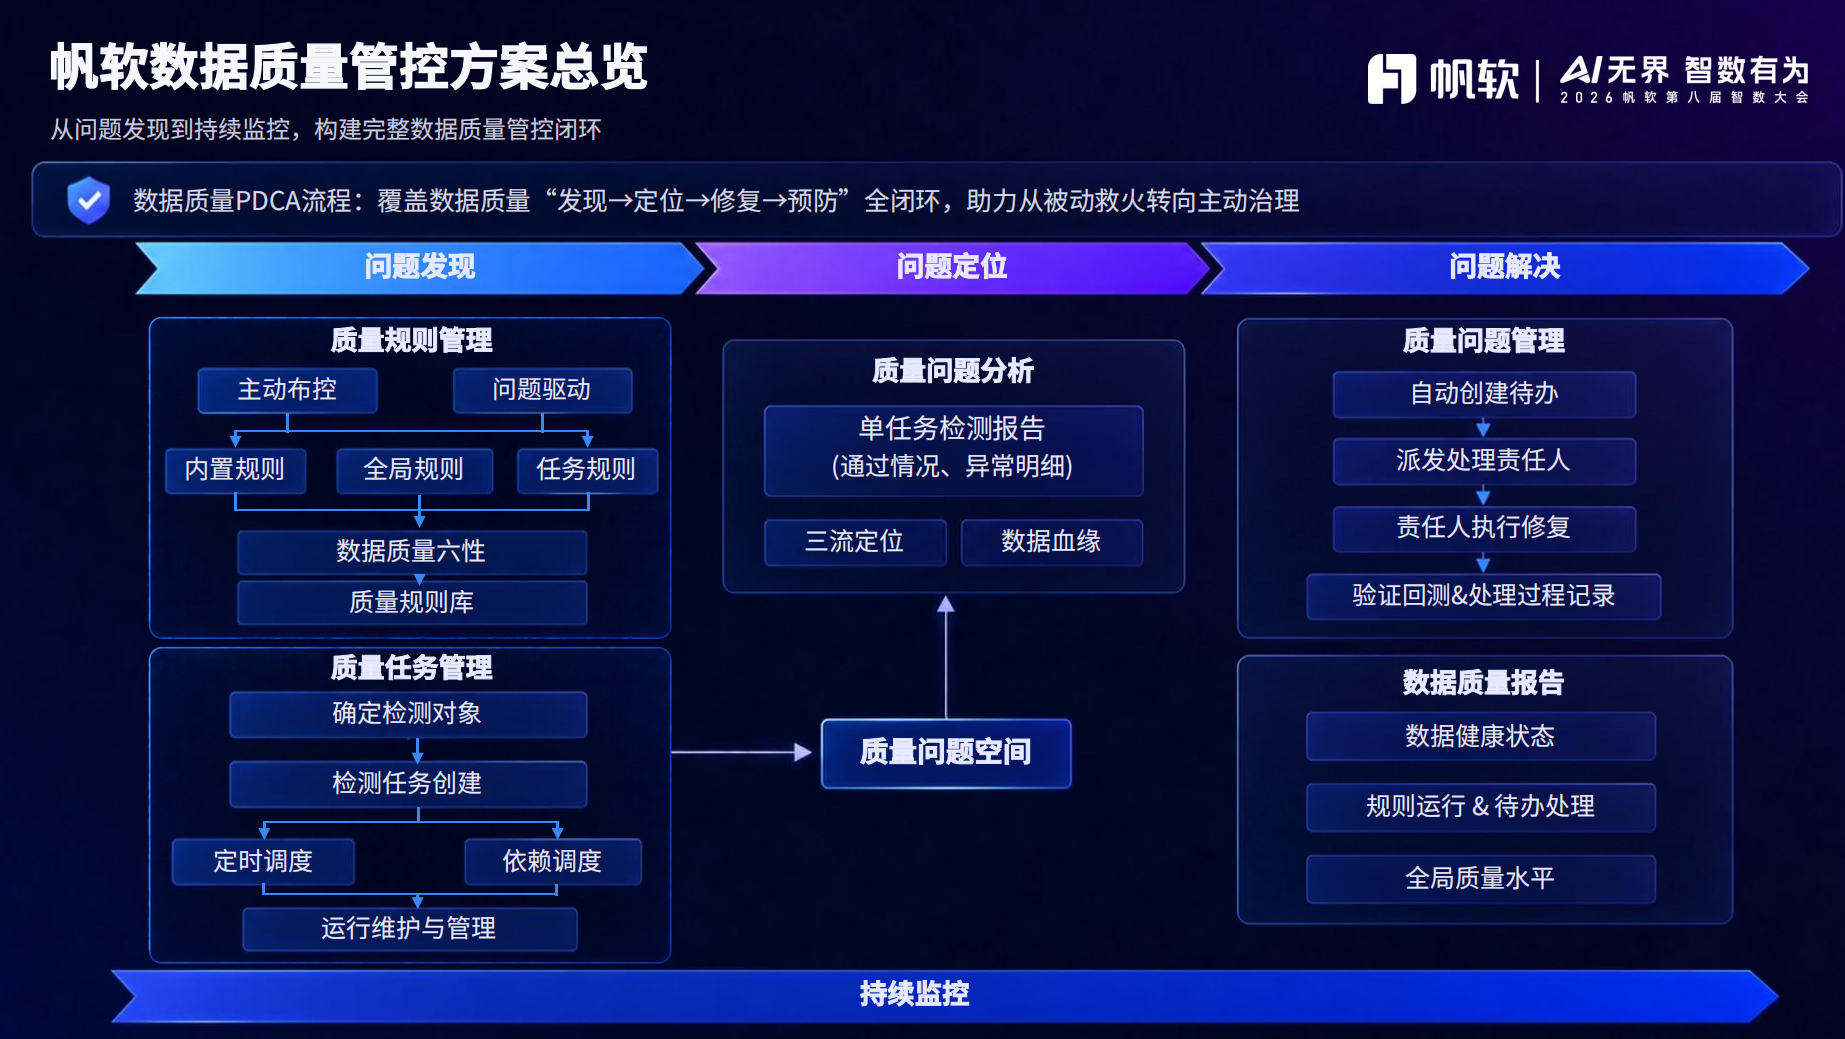
面对这些痛点,帆软把治理动作收敛为一套方法论:以 PDCA 循环为骨架,围绕问题发现、问题定位、问题解决、持续监控四个环节持续推进。李昌鑫强调,治理不是一次性项目,而是一条需要不断迭代的闭环。
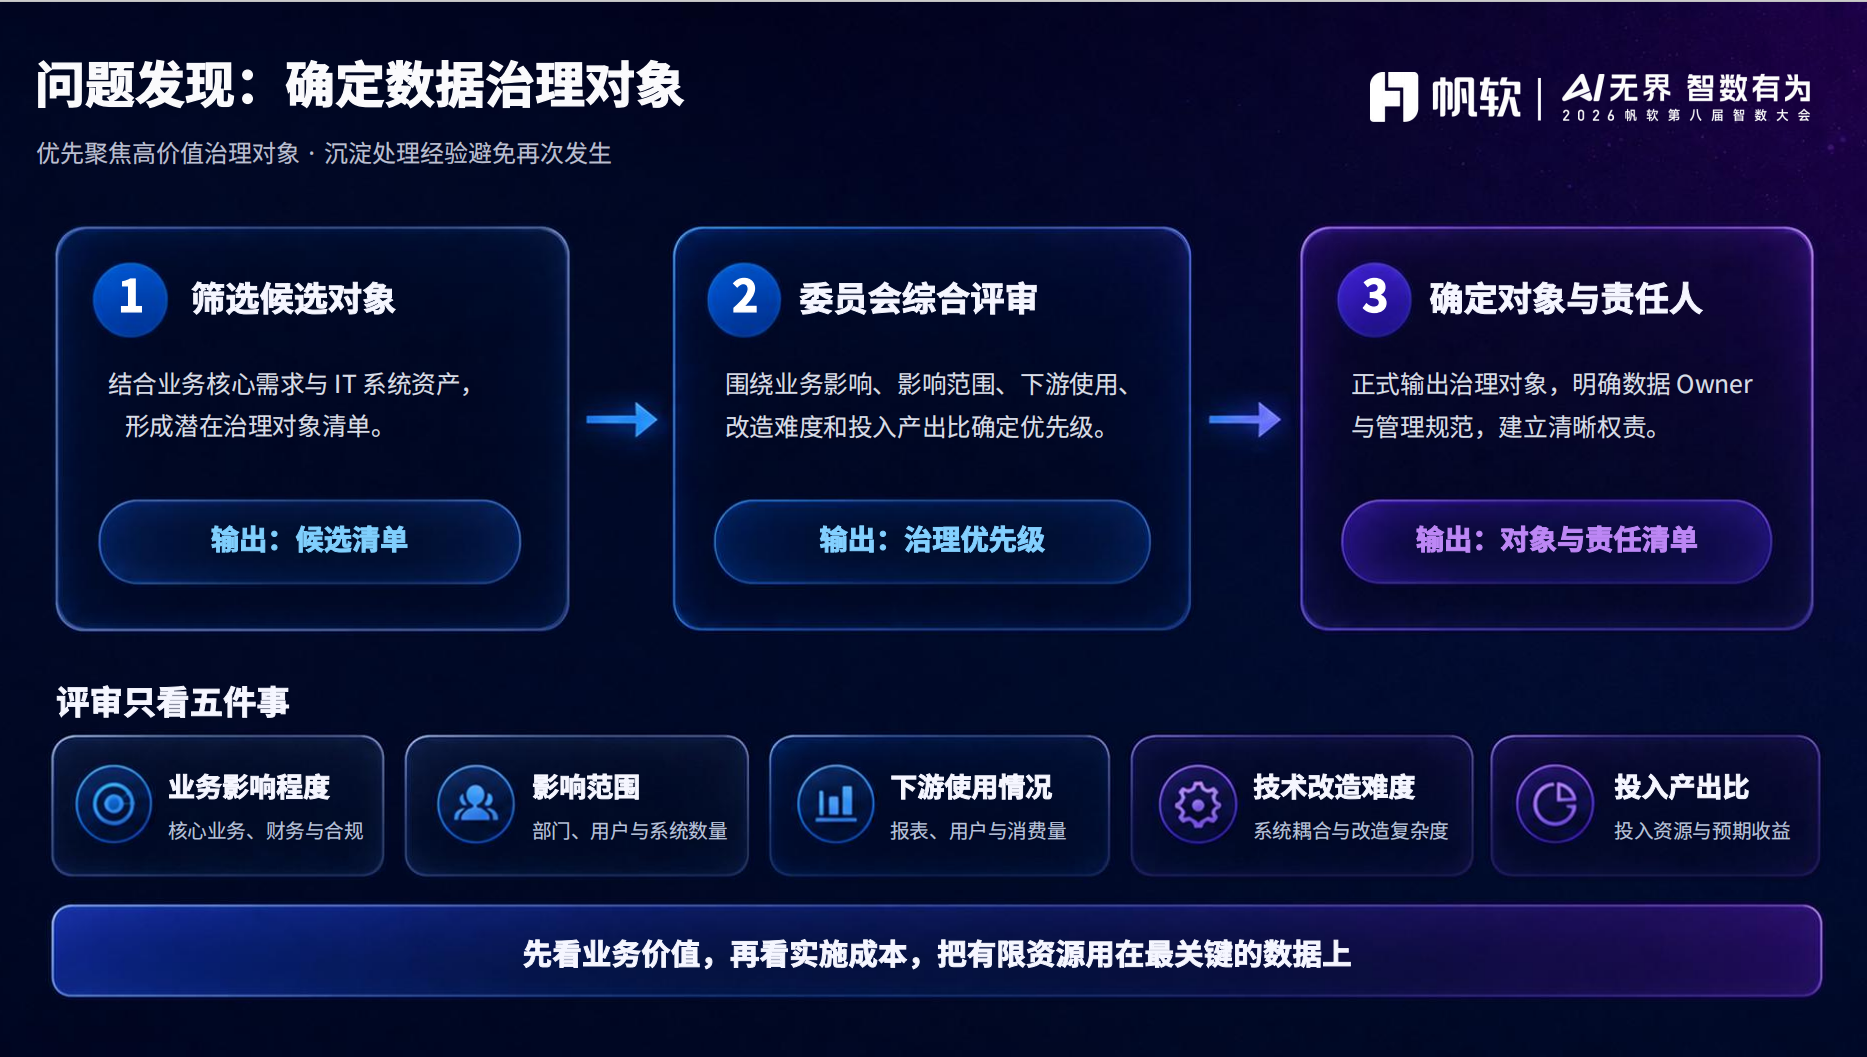
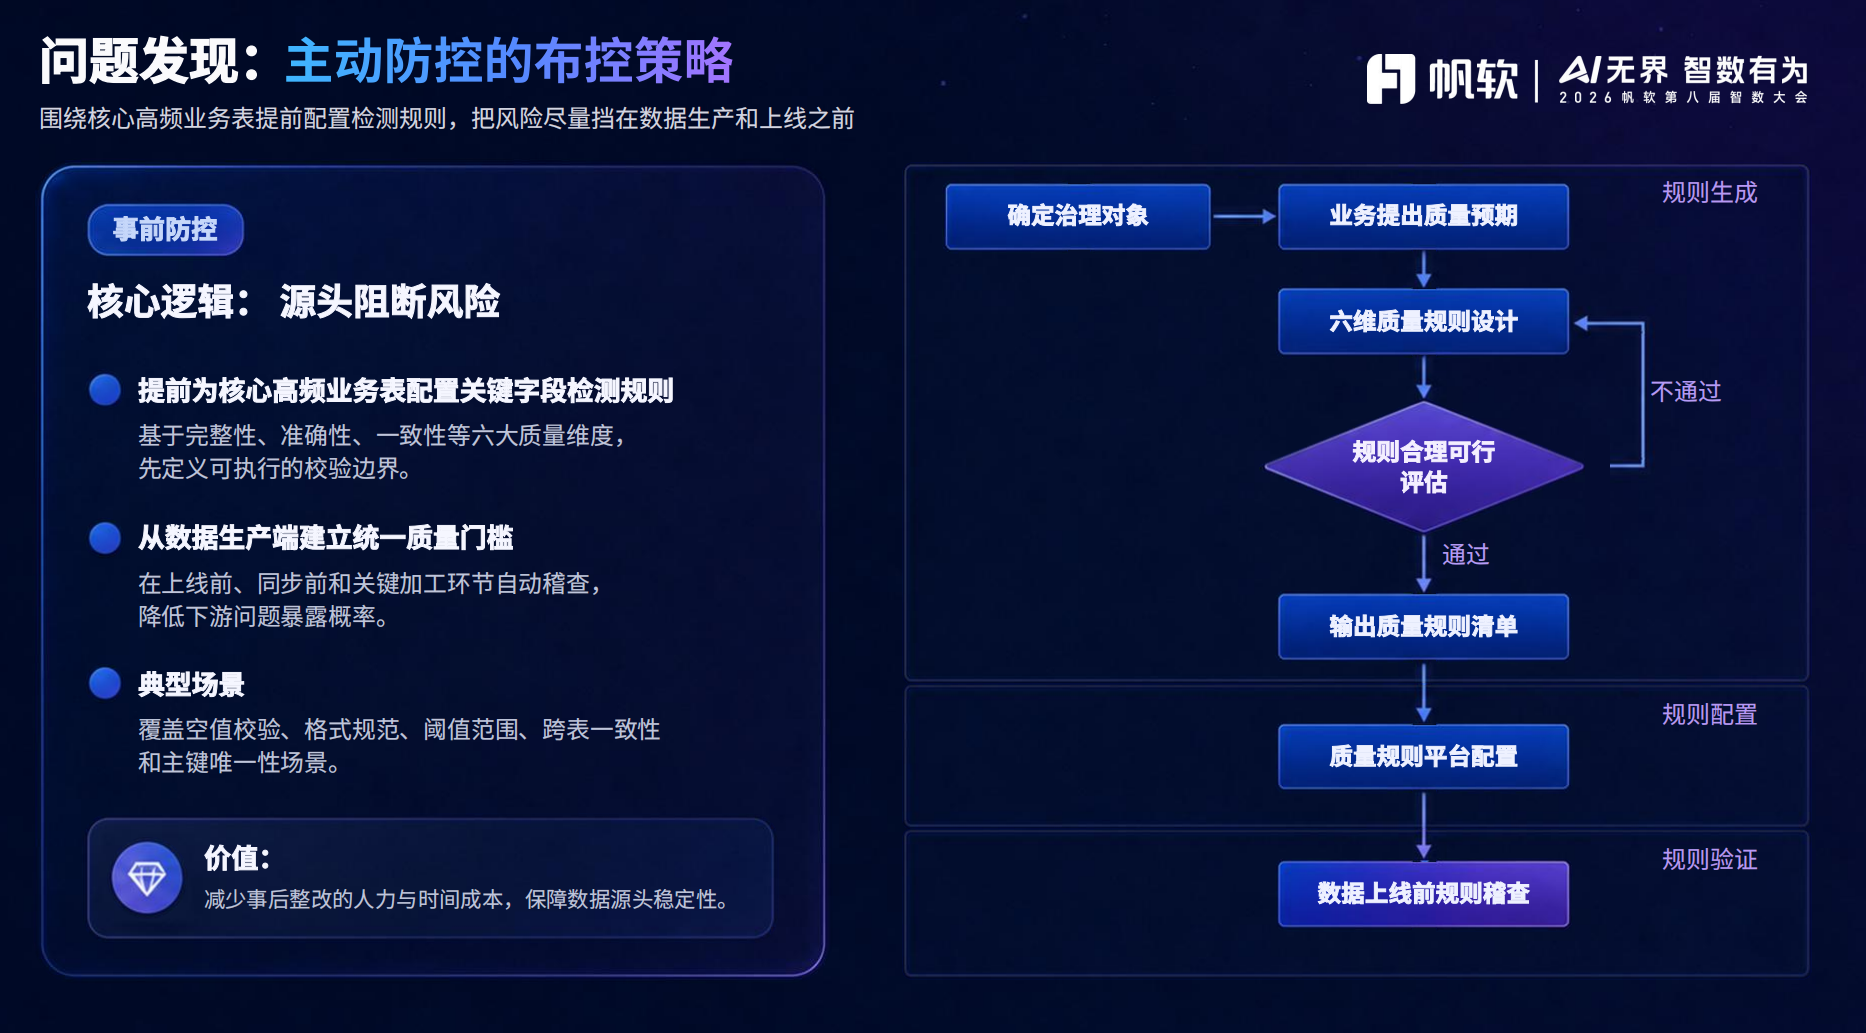
闭环的第一步并不是急着配规则,而是先筛治理对象。企业内部值得治理的数据对象极多,百分百投入只会摊薄资源。帆软因此建立了一套评审机制,只看五件事:业务影响程度、影响范围、下游使用情况、技术改造难度与投入产出比,据此筛出高优先级对象,并明确数据 Owner 与管理规范。先看业务价值,再看实施成本,把有限资源用在最关键的数据上。
两条路径与 2281 条规则
确定对象之后,帆软走的是两条并行的规则路径。第一条是主动布控:针对核心业务表与关键字段,在上线前、同步前和关键加工环节配置检测规则,覆盖空值校验、格式规范、阈值范围、跨表一致性与主键唯一性等典型场景,把风险尽可能挡在数据生产和上线之前。
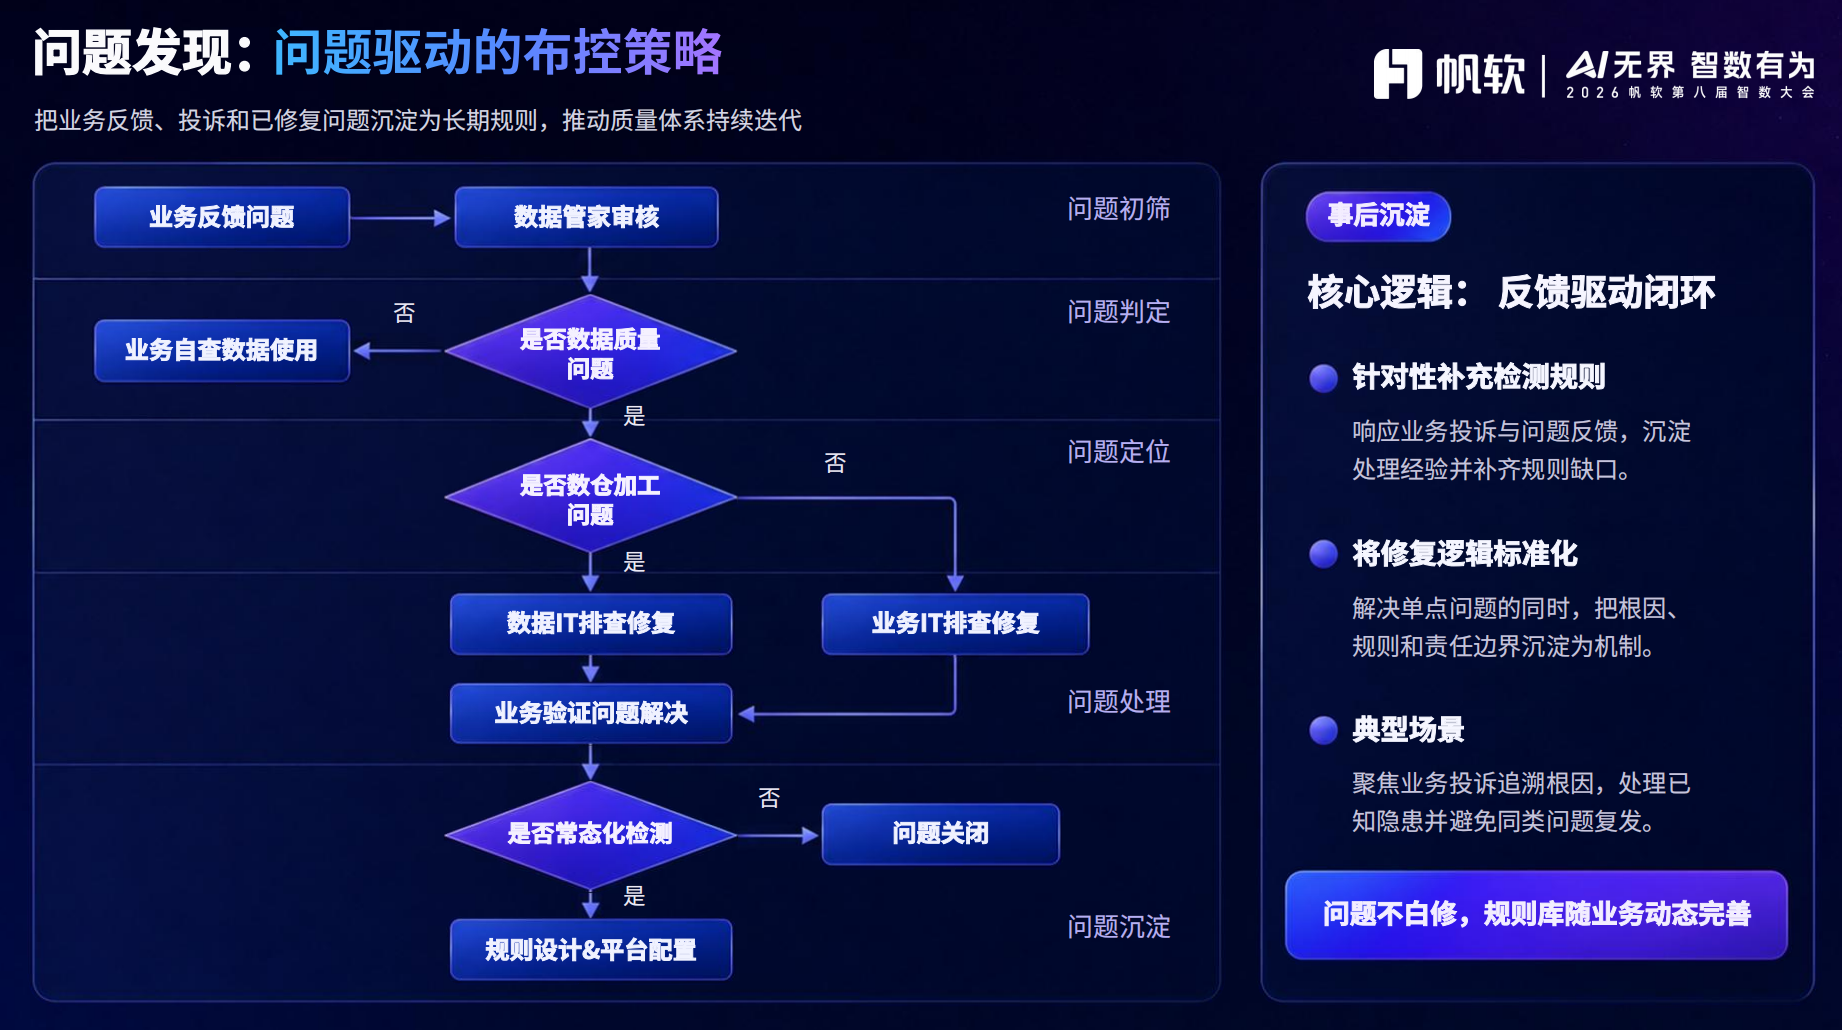
第二条是问题驱动。业务在日常使用中反馈与投诉的问题,修复之后并不算完——帆软数据中心会进一步判断它是否会反复出现,若会,便把处理经验标准化为规则,补进平台的规则库。问题不白修,规则库随业务动态完善,最终形成「业务越用、数据质量越好」的正向循环。
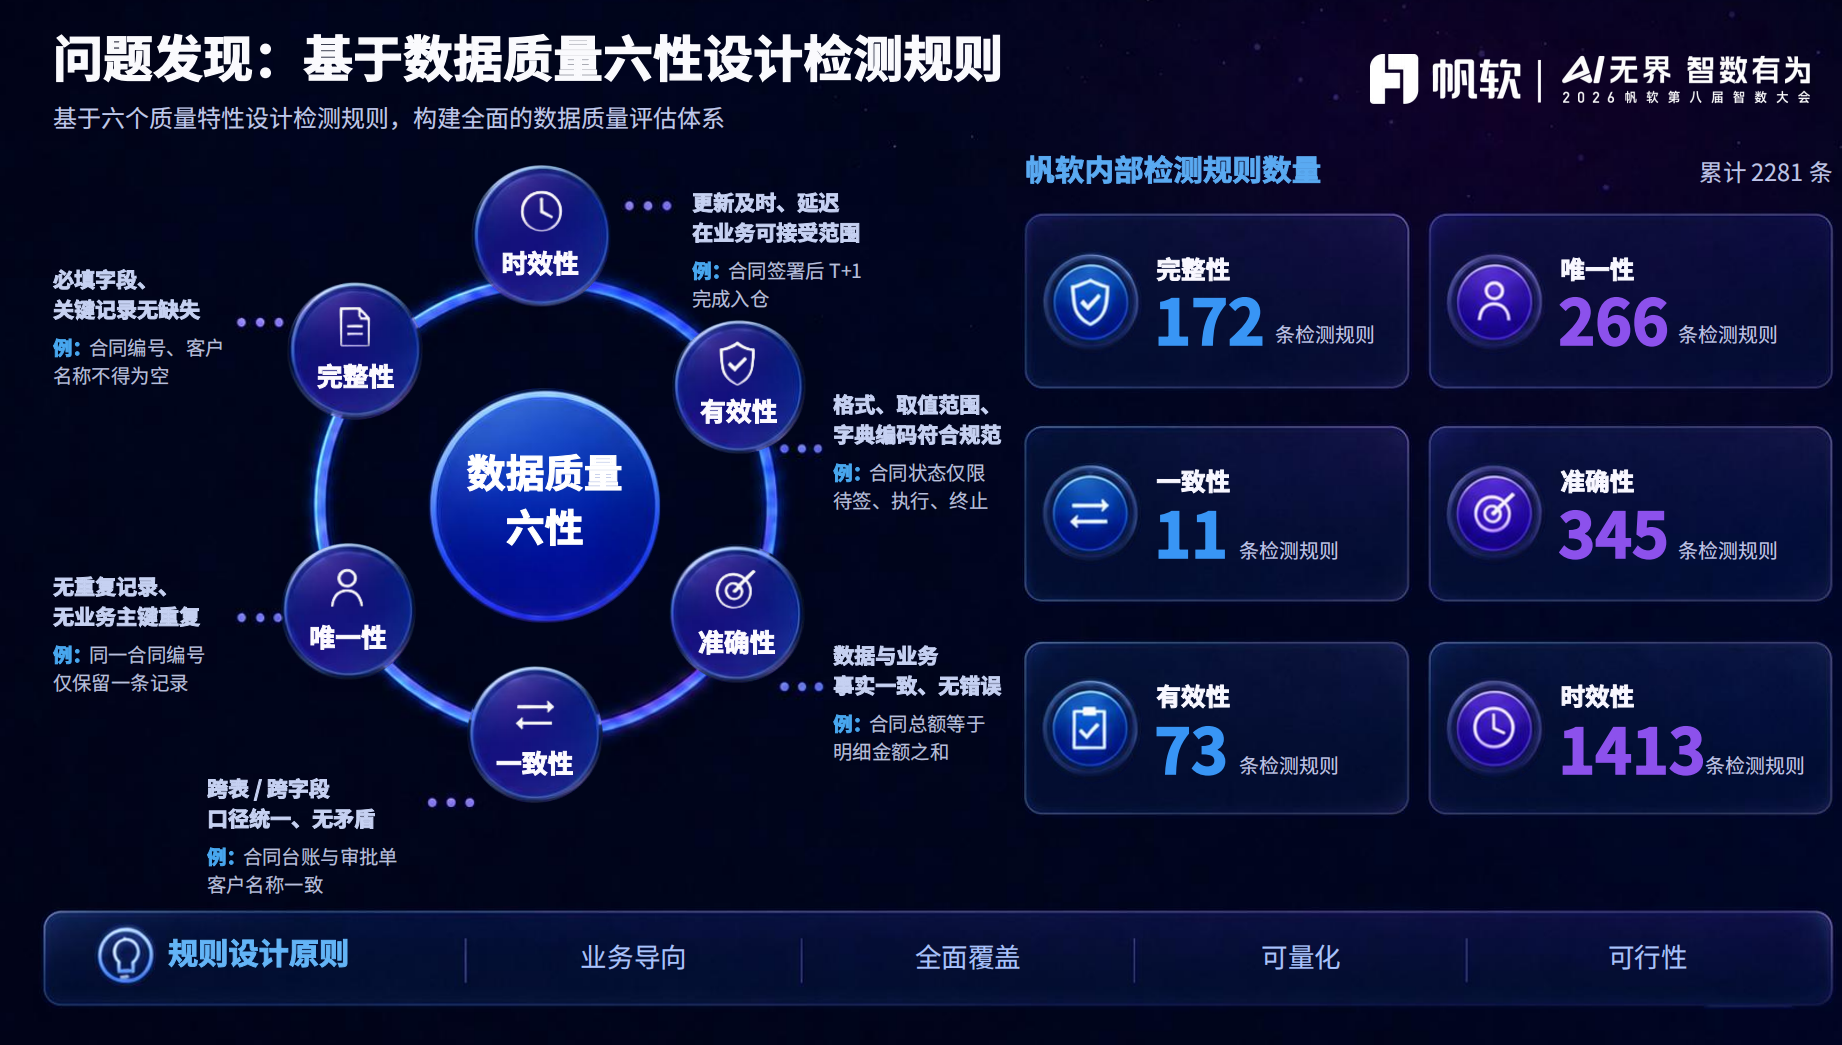
两条路径的落点都是可执行的数据检测规则,而规则的组织依据是「数据质量六性」:完整性、准确性、一致性、时效性、有效性、唯一性。以合同场景为例,合同编号与客户名称不得为空属完整性,合同总额须等于明细金额之和属准确性,合同状态仅限待签、执行、终止属有效性。目前帆软内部累计检测规则已达 2281 条,其中时效性 1413 条、准确性 345 条、唯一性 266 条、完整性 172 条、有效性 73 条、一致性 11 条。
把规则跑起来:
平台配置与分级告警
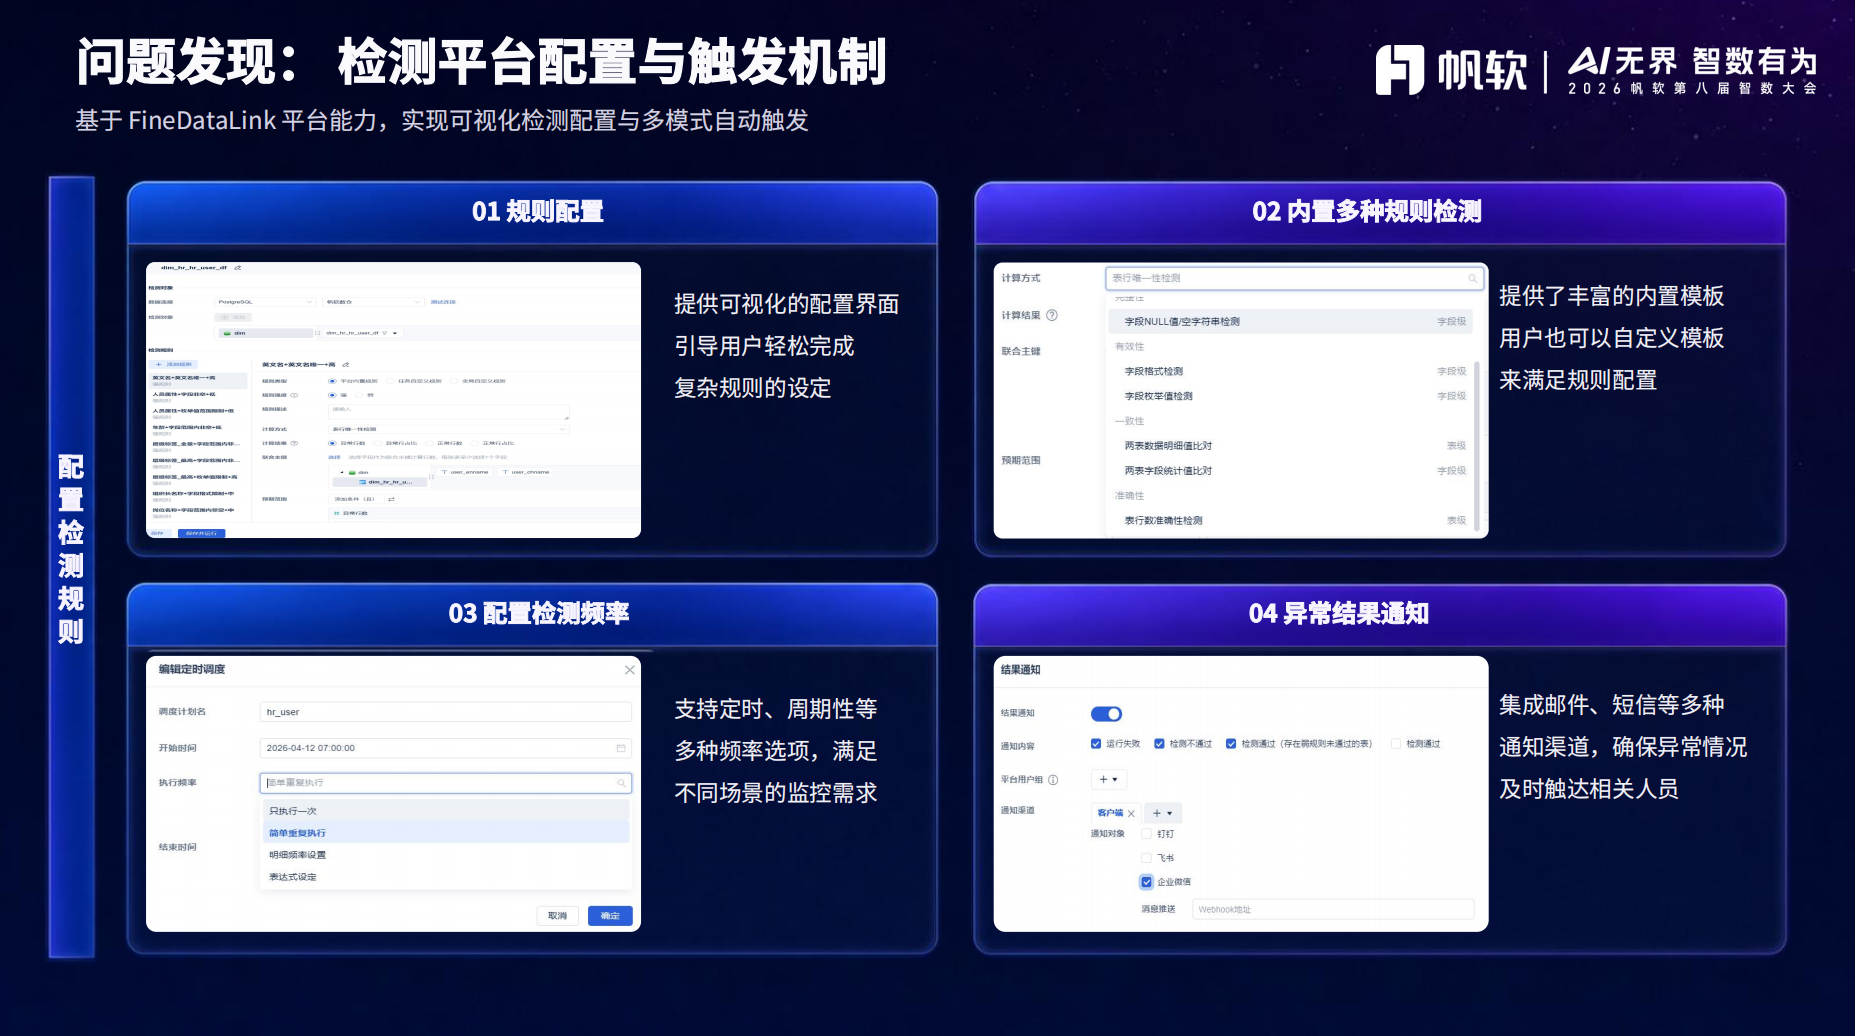
把这些规则真正跑起来,依靠的是 FineDataLink 的平台能力:可视化配置界面降低了复杂规则的设定门槛;平台内置大量模板,也支持自定义;检测频率可按定时、周期性等需求灵活选择;异常结果则能经邮件、短信、企业微信等多种渠道第一时间触达责任人。
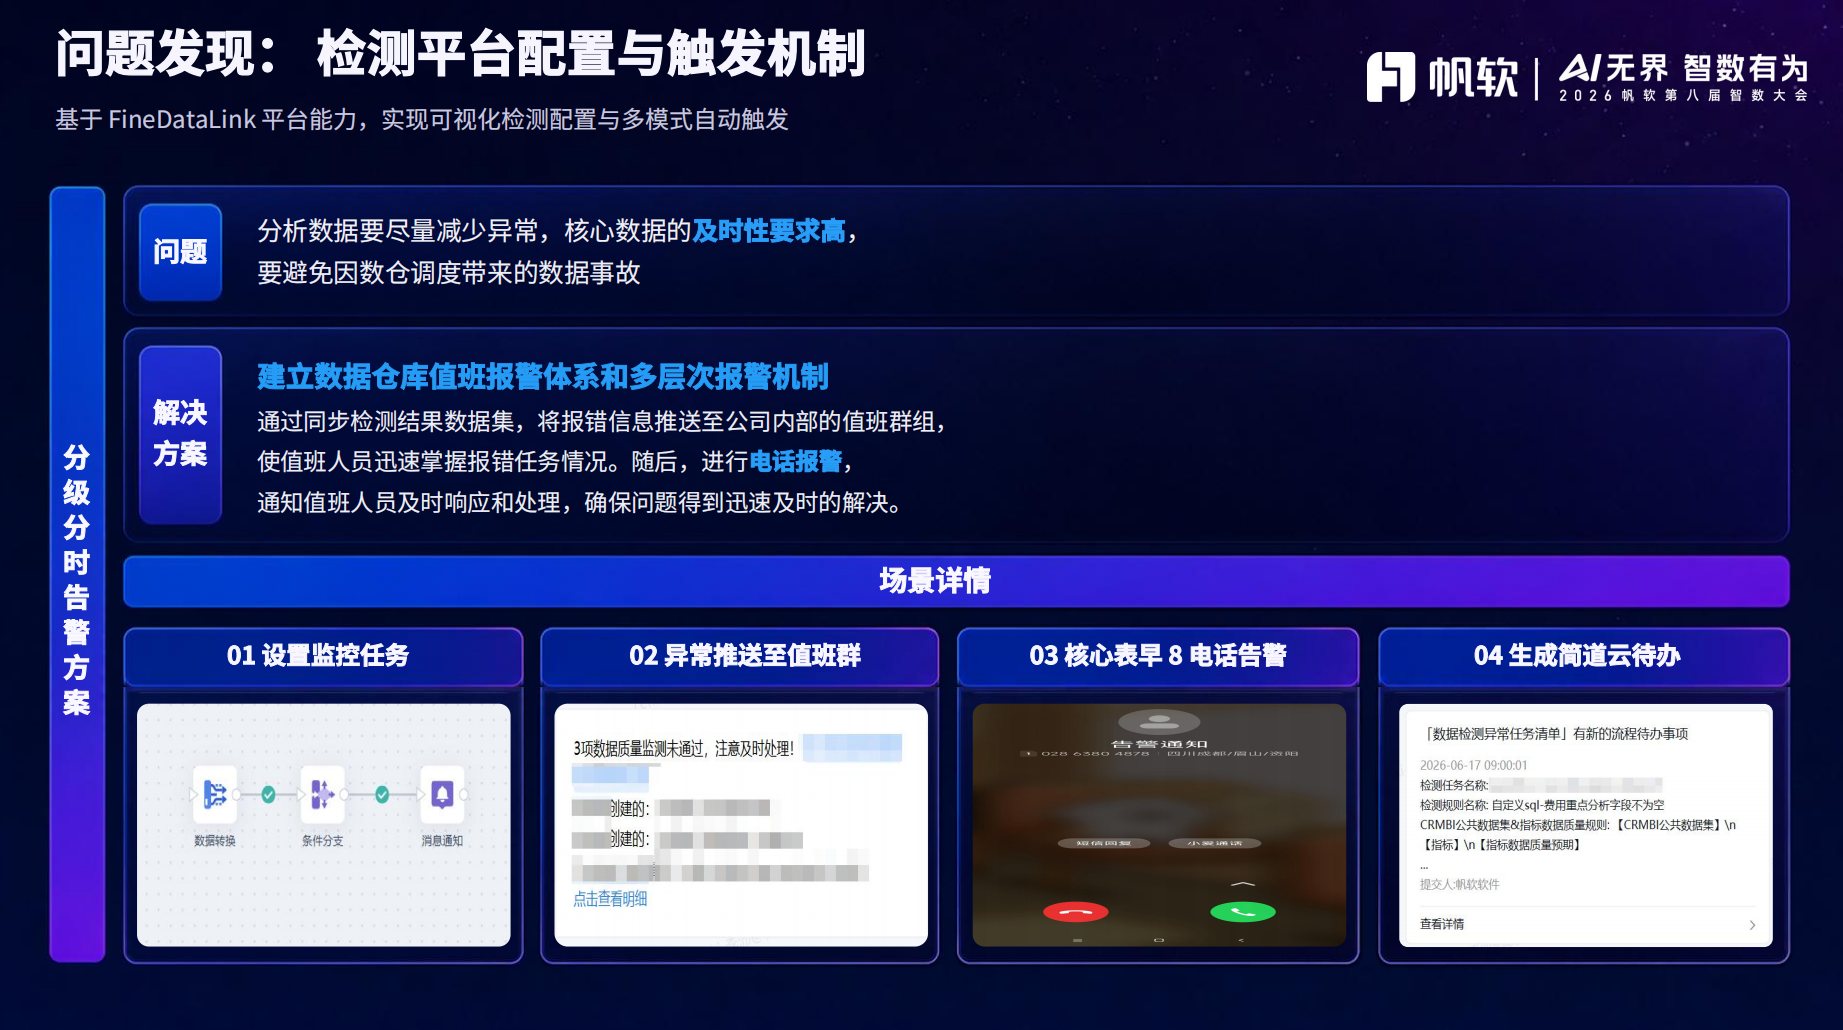
但李昌鑫坦言,核心业务数据的时效要求更高——凌晨出问题的合同表或客户表,不可能等到上班再修。为此帆软建立了分级分时告警机制:异常先推送至公司值班群,让值班人员第一时间掌握报错任务;对于核心表,每天早 8 点还会触发电话告警,把值班人员叫醒修复,确保业务人员 9 点上班时用到的是正确可用的数据。
定位与闭环:
三维诊断、血缘溯源、待办流转
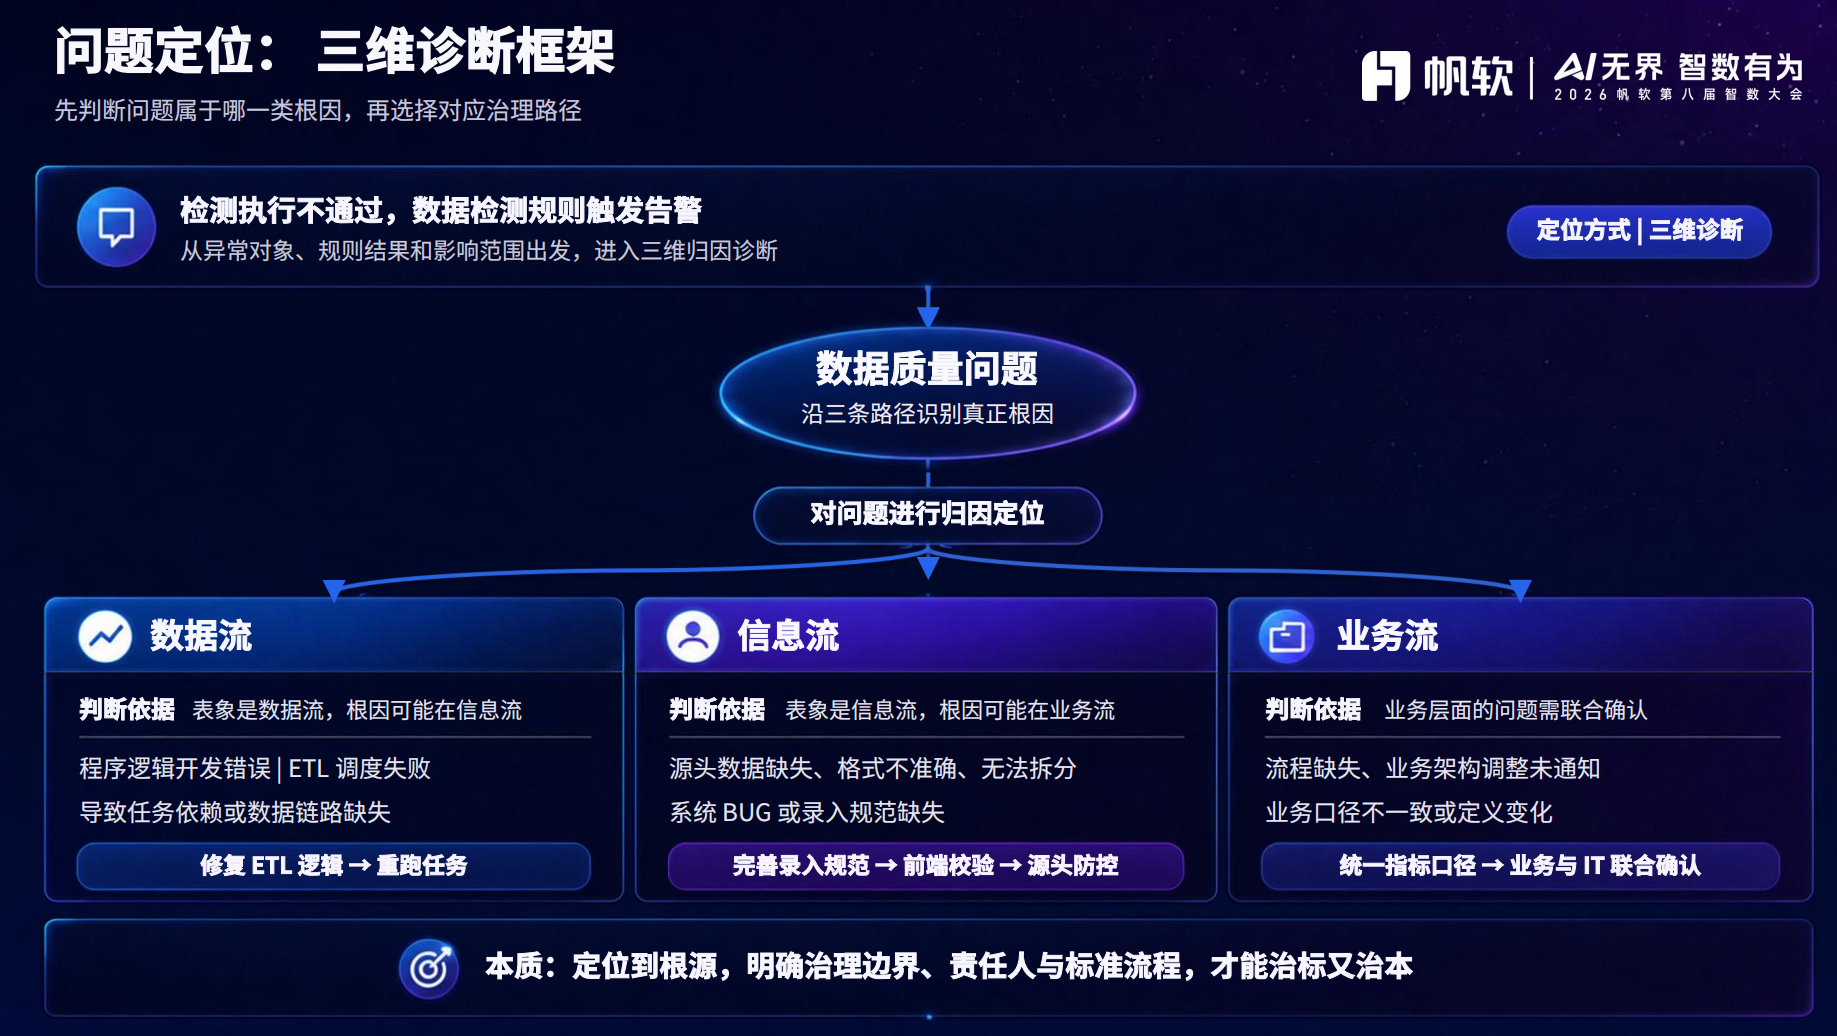
发现问题之后便是定位问题。帆软采用三维诊断框架逐层归因:先判断是否为数据流问题,例如 ETL 逻辑错误或调度失败;若不是,再向前判断是否为信息流问题,例如源头数据缺失、格式不准确或录入规范缺失;仍不是,则继续推向业务流,核查流程缺失、业务架构调整未通知、业务口径不一致等根因。表象可能在数据流,根因却往往藏在信息流甚至业务流。
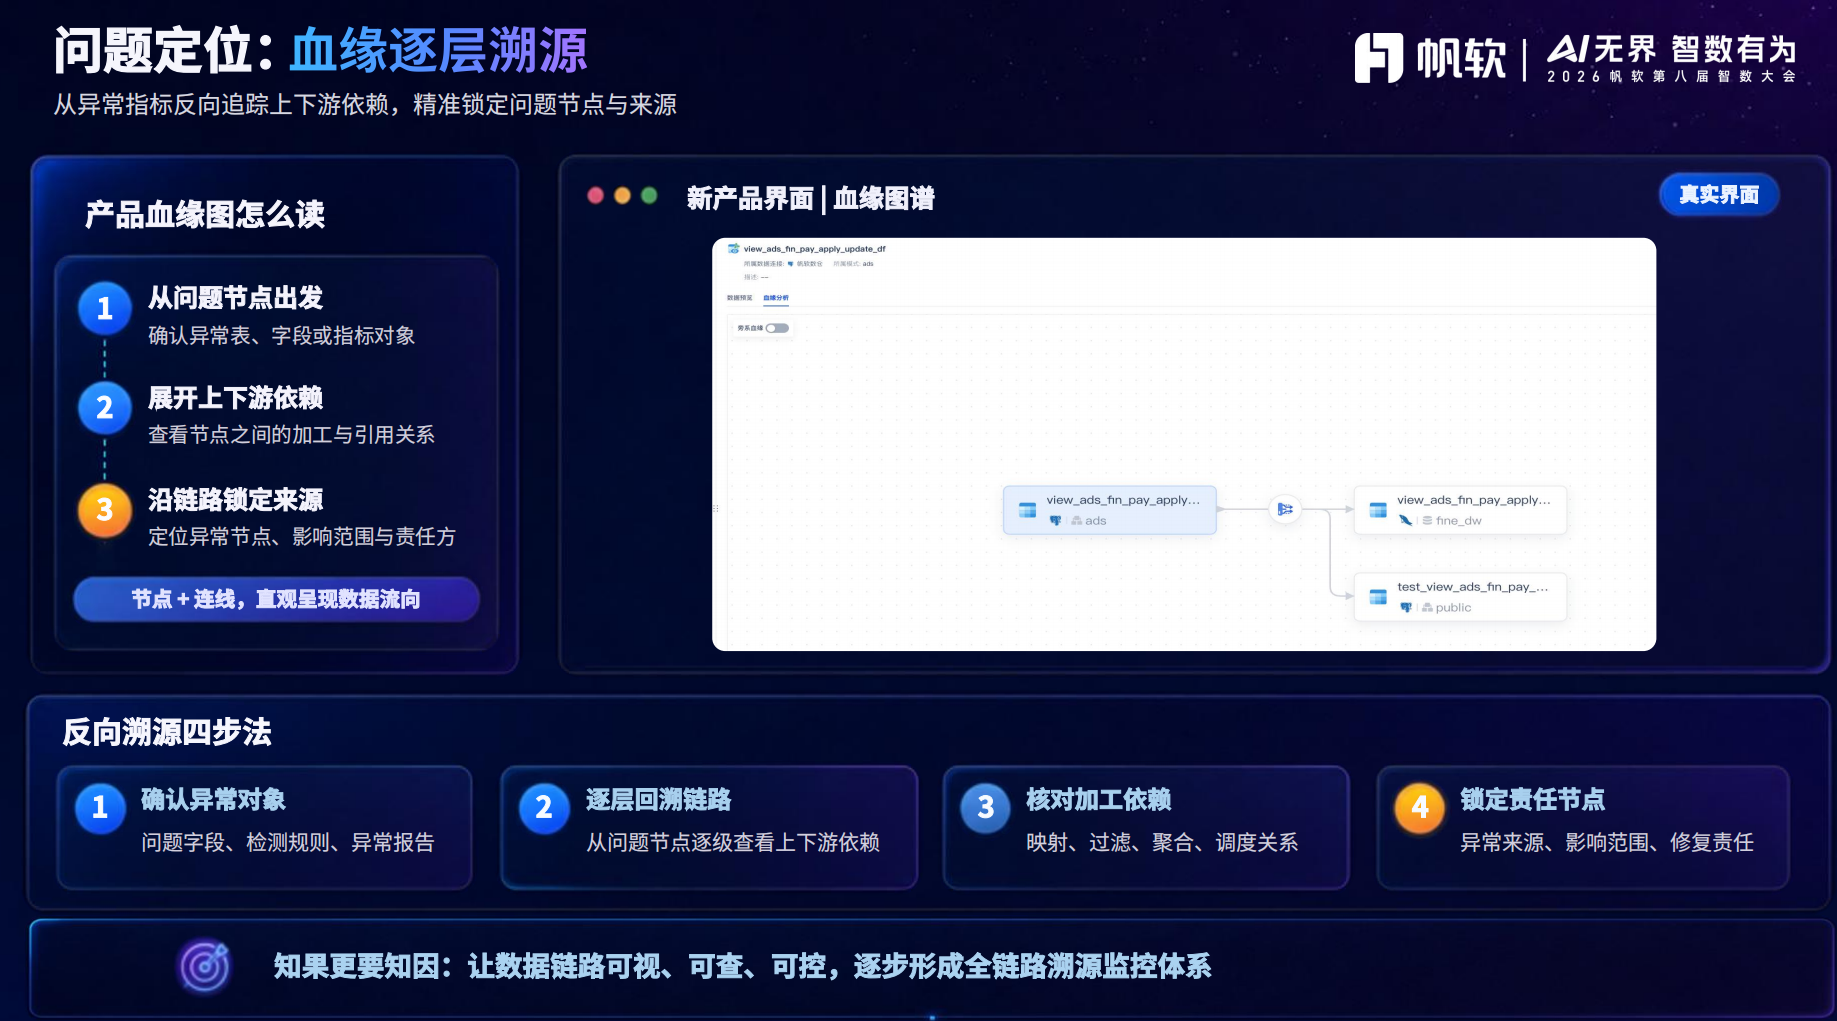
在具体排查中,数据血缘是关键工具。打开 FineDataLink 的血缘图谱,从异常的表、字段或指标出发,逐层展开上下游依赖关系,核对映射、过滤、聚合与调度关系,最终锁定异常节点、影响范围与责任方。知果更要知因,数据链路才能可视、可查、可控。
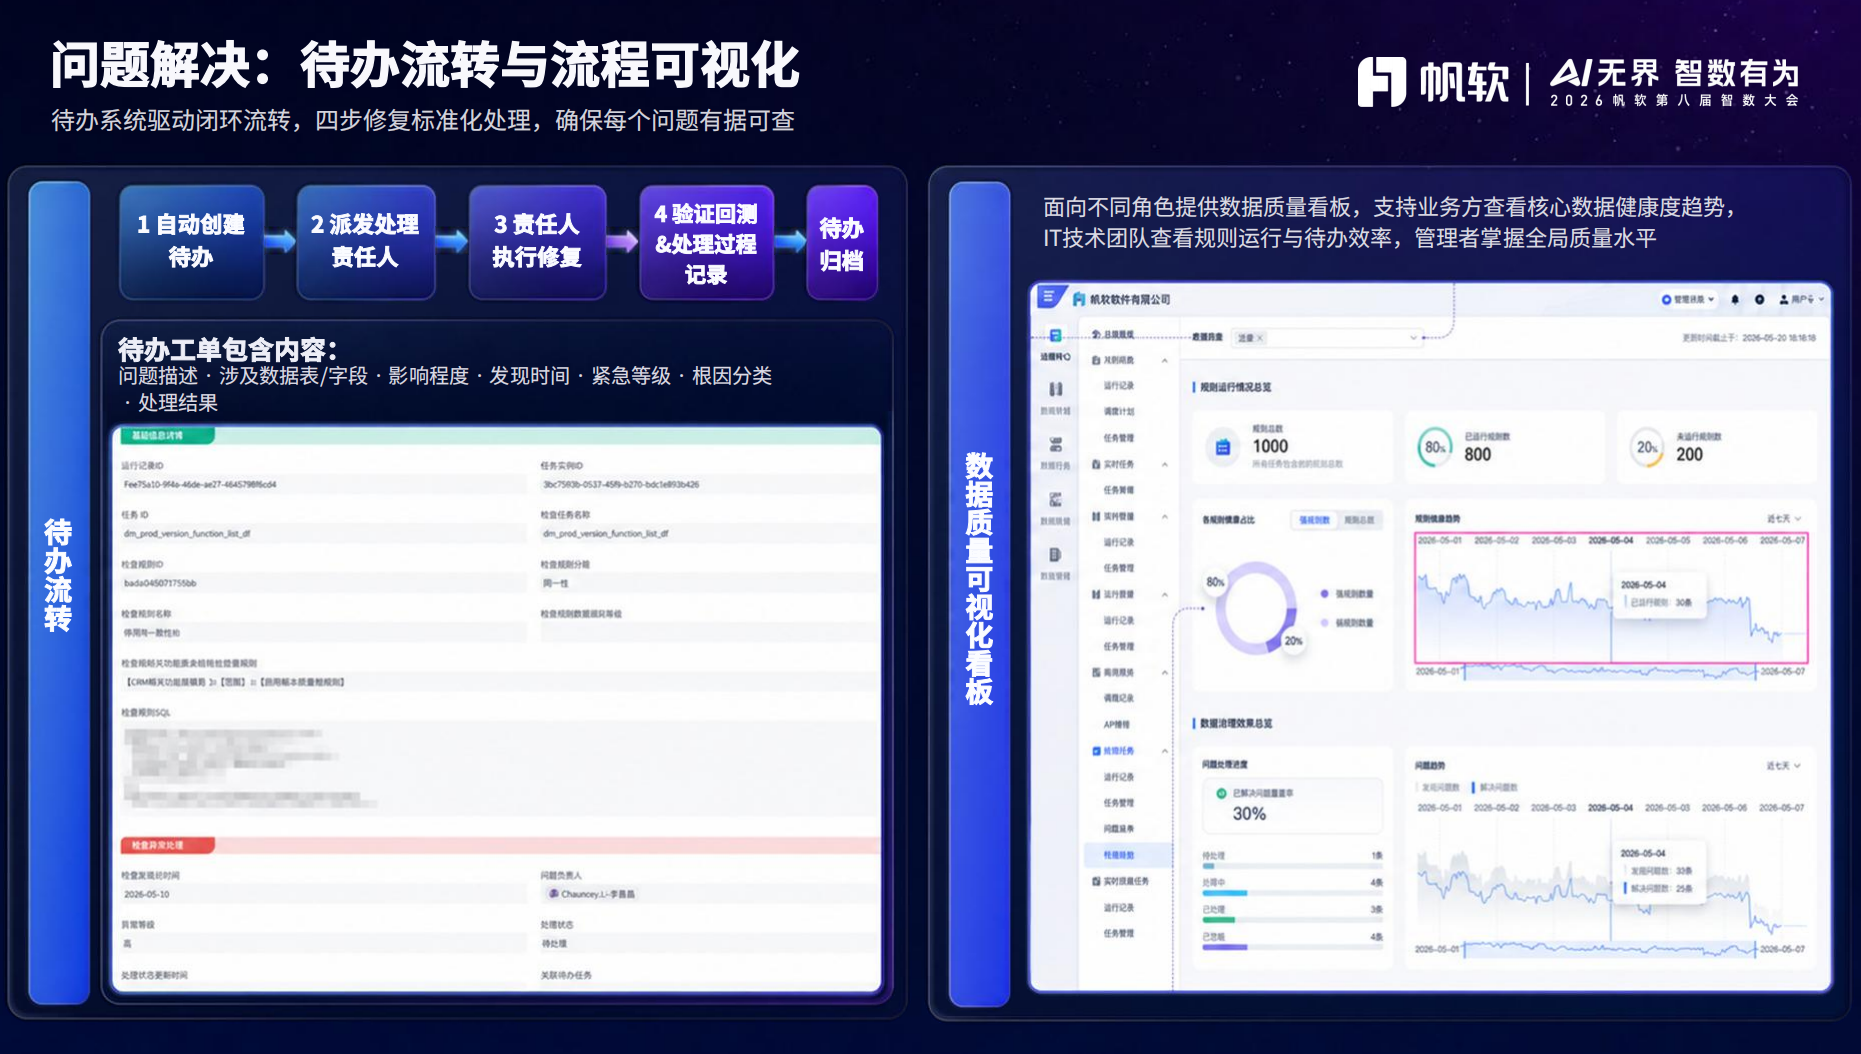
问题解决环节则被标准化为四步:自动创建待办、派发处理责任人、责任人执行修复、验证回测并记录处理过程。每条待办都携带问题描述、涉及数据表与字段、影响程度、发现时间、紧急等级、根因分类与处理结果,并汇总为数据质量可视化看板——业务方查看核心数据健康度趋势,IT 团队查看规则运行与待办效率,管理者掌握全局质量水平。
从不敢用数,到完全信任数据
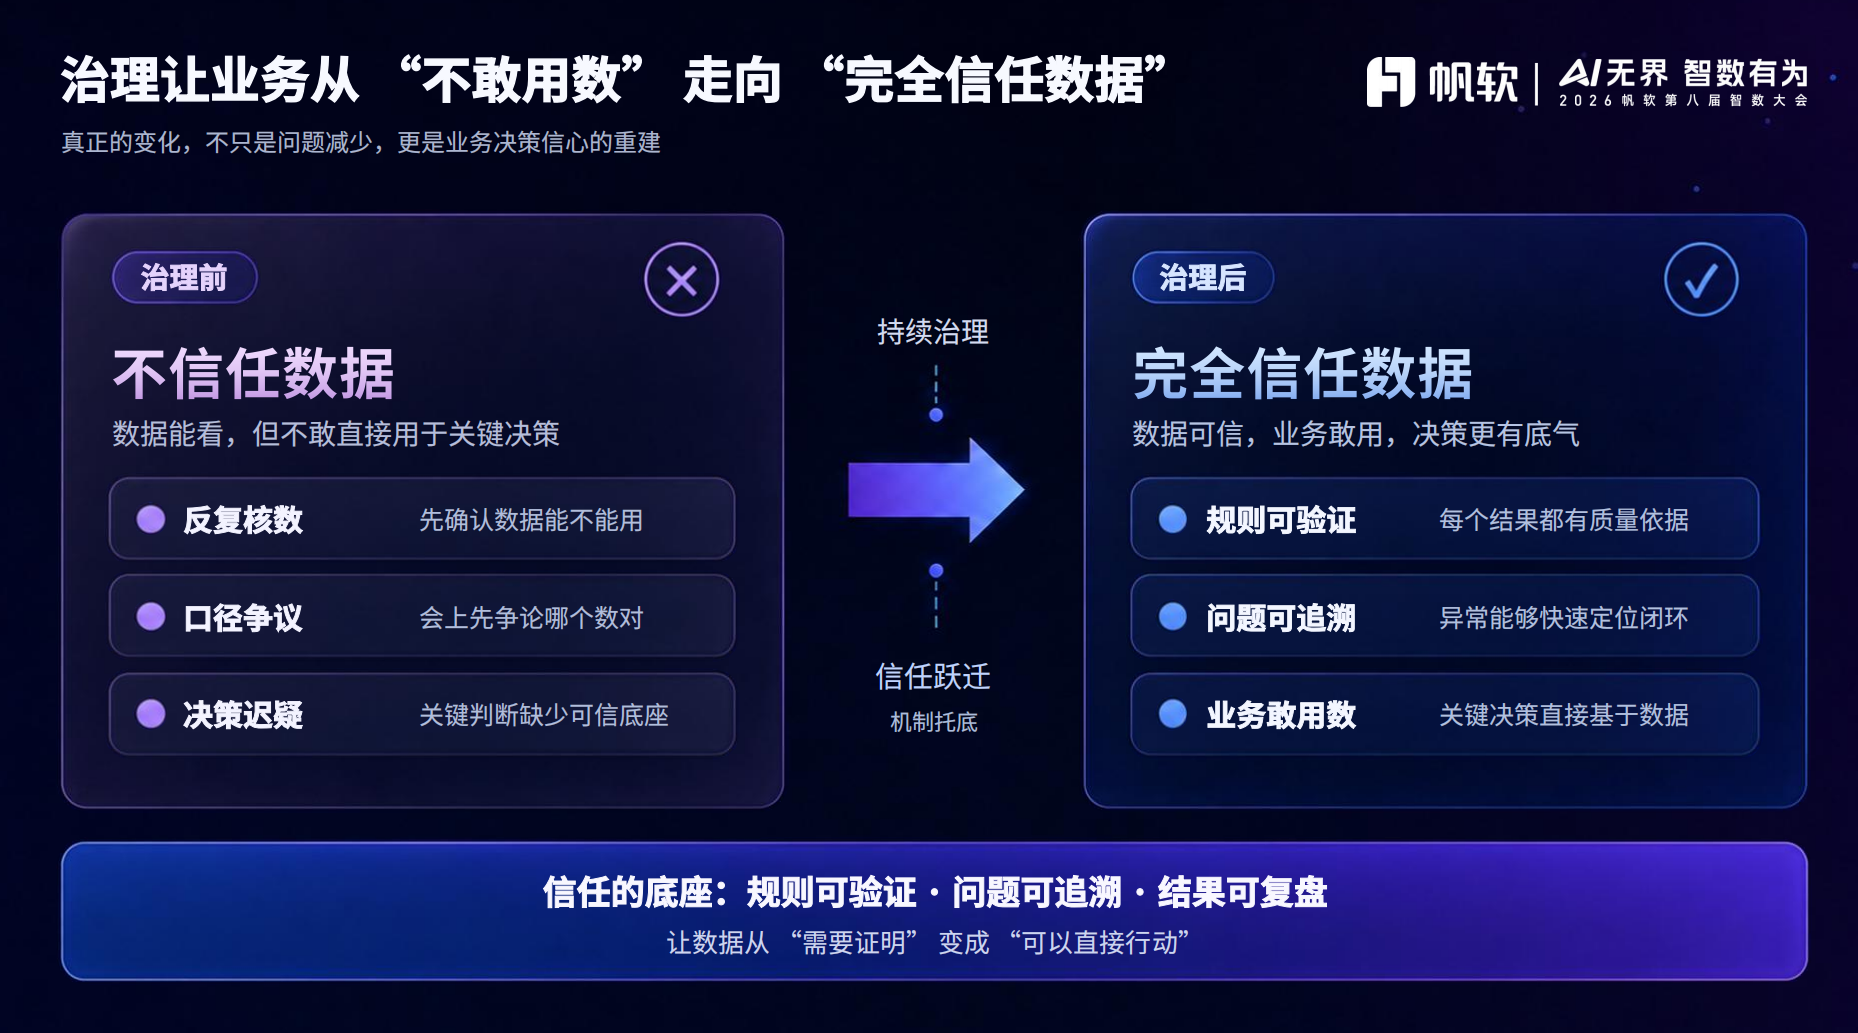
两年持续治理之后,李昌鑫认为最大的变化是一种「数据氛围」。治理之前,业务并不信任数据,每次开会或汇报前都要反复核对、质疑口径;如今业务已完全信任数据。他举了一个有趣的例子:两个部门的数据一旦对不上,双方会先确认这个数是不是数据中心提供的——如果不是,那就默认它不准确。
量化结果同样清晰。两年间,帆软累计触发主动预警 190 余次,拦截 20 起重大数据事故——相当于有 20 多次,值班人员在早上 8 点前就已经把问题解决掉了;近两年业务投诉为零。李昌鑫将治理价值概括为更早发现、更少事故、更稳定运行。
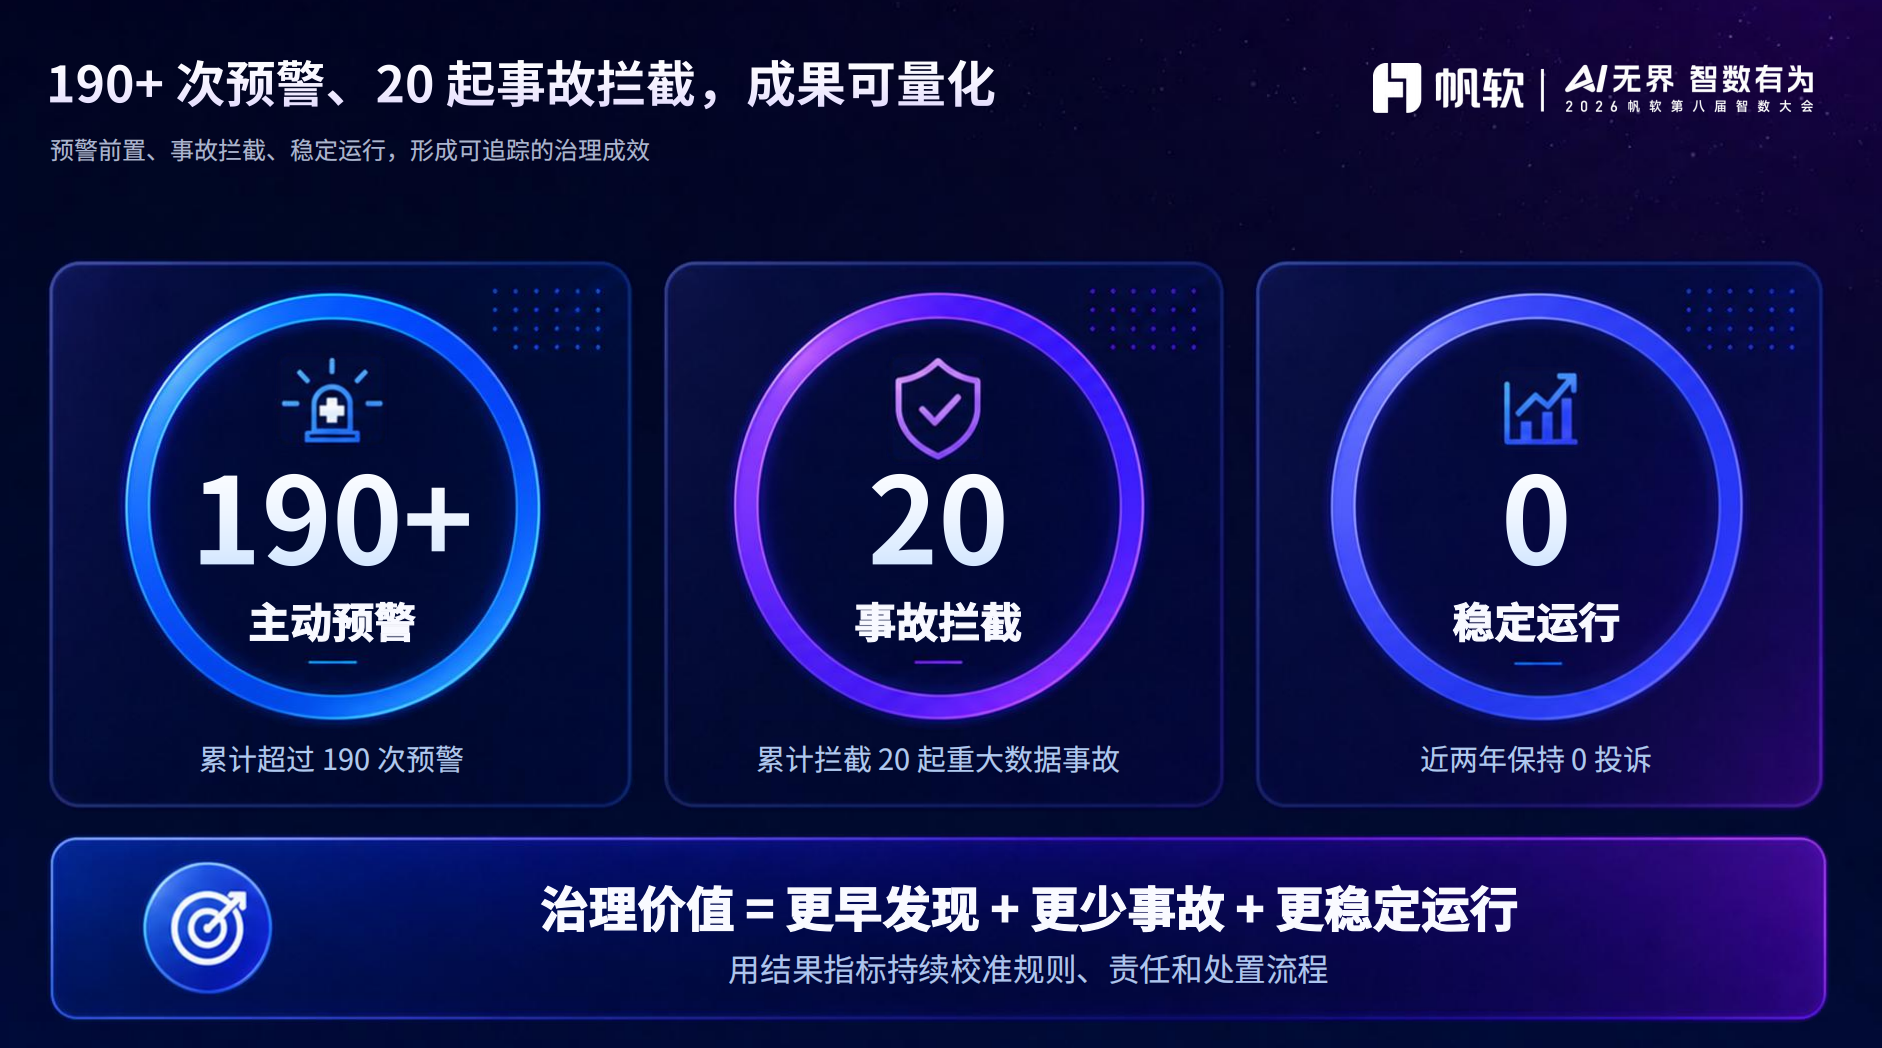
在李昌鑫看来,数据质量治理的价值并不在于解决了多少个待办、多少条问题,而在于沉淀出一套能让数据持续可用、可信、可管理的机制。规则持续校准,责任持续落位,流程持续运转——这才是真正意义上的闭环。 |